
损失函数
损失函数(Loss Function)衡量模型预测值与真实值之间的差距,是深度学习训练的”指挥棒”——优化器沿着损失函数的梯度方向更新参数(详见梯度下降与优化器)。本页系统梳理回归、分类、排序、分割和对比学习等场景下的常用损失函数,并给出关键数学推导与代码实现。前置阅读:数值优化与数学基础。
把损失函数想象成”考试评分标准”——不同的评分方式会引导模型学到不同的能力:
- MSE(均方误差)= 对大错重罚。差 10 分扣 100 分(平方),逼模型优先修正偏差最大的样本。缺点是对异常值过于敏感。
- MAE(平均绝对误差)= 一视同仁。差 1 分扣 1 分,对异常值更鲁棒,但梯度恒定(始终为 ),在小误差区域收敛慢。
- Huber Loss= MSE 和 MAE 的合体:小错按 MSE(平滑收敛),大错按 MAE(不被异常值绑架)。
- 交叉熵(Cross-Entropy)= 信息论评分。预测概率越偏离真实标签,惩罚越大且呈指数增长——天然适配分类任务。
- Focal Loss= 给”已经分对的简单样本”降权,让模型集中精力啃”难样本”——解决类别不平衡的利器。
- Triplet Loss= 人脸识别专用——拉近同一个人,推开其他人。
- Dice Loss= 分割专用——直接优化区域重叠度(IoU),而不是逐像素的误差。
- KL 散度损失(KL Divergence Loss)= 知识蒸馏专用——逼学生模型的输出分布去模仿老师模型的”软标签”,而非只学硬标签。
- DPO 损失(直接偏好优化损失)= 绕过奖励模型,直接从人类偏好数据(“回答 A 比回答 B 好”)训练 LLM。
- Lovasz Loss= IoU 的平滑可导替身——IoU 本身不可导无法直接用梯度优化,Lovasz 用凸代理解决了这一问题。
MSE / L2 Loss
Section titled “MSE / L2 Loss”均方误差是最经典的回归损失,对预测值与真实值之差取平方后求平均:
梯度对预测值求导为 ——误差越大梯度越大,收敛快但异常值(误差极大的样本)会主导梯度方向。
为什么用平方而不是绝对值? 直觉有三点:(1) 平方让损失处处可导(绝对值在零点不可导);(2) 大误差被指数级放大,模型优先修正最差的预测;(3) 在高斯噪声假设下,最小化 MSE 等价于最大似然估计。
偏差-方差分解(Bias-Variance Decomposition)
MSE 可以被精确分解为三部分——偏差的平方、方差和不可约噪声。这是理解”模型为什么过拟合”的核心数学工具。
假设真实关系为 ,其中 为不可约噪声,模型在训练集上学到 。对单个测试点 x,期望损失为:
最后一项交叉项为 0,因为 与 独立。现在展开核心项:
中间项中, 对训练集是常数,提出来后 ,故中间项为零:
最终结论:
| 分量 | 含义 | 对应现象 |
|---|---|---|
| Bias² | 模型预测的平均值与真实值 f(x) 的偏离 | 欠拟合:模型太简单,无法拟合真实关系 |
| Var | 模型在不同训练集上预测的波动程度 | 过拟合:模型对训练数据太敏感 |
| σ² | 数据本身的噪声,无法消除 | 标签采集误差、缺失特征等 |
核心启示:降低 Bias(用更复杂的模型)通常会增加 Variance,反之亦然——这就是偏差-方差权衡(Bias-Variance Tradeoff)。正则化(如 L2 权重衰减)本质上是用少量 Bias 换取大量 Variance 的降低。
MAE / L1 Loss
Section titled “MAE / L1 Loss”平均绝对误差直接取差的绝对值:
梯度恒为 (与误差大小无关),因此对异常值鲁棒;但在 处不可导,小误差区域收敛慢。在拉普拉斯噪声假设下,最小化 MAE 等价于最大似然估计。
Huber Loss
Section titled “Huber Loss”Huber Loss(又称 Smooth L1 Loss)在误差较小时用 MSE、较大时切换为 MAE,用一个阈值 控制切换点:
兼具 MSE 的平滑收敛和 MAE 的异常值鲁棒性,常用于回归和强化学习(如 DQN 的目标值计算)。
δ 点的连续性与可导性验证
Huber Loss 的设计精髓在于:它在切换点 处既连续又可导(一阶导数连续),这是通过精心选择常数项 实现的。
连续性——在 处,两段的值必须相等:
一阶导数连续性——对 error 求导(设 error = y_pred - y_true,error > 0 时):
左导数 = ,右导数 = ,二者相等——这正是 这个常数项的作用:如果右段常数项不是 ,两段在 点的值或导数就无法同时匹配。Smooth L1 Loss(Fast R-CNN 提出)是 的特例。
交叉熵 Cross-Entropy
Section titled “交叉熵 Cross-Entropy”交叉熵源自信息论,其推导链为:自信息 → 熵 → 交叉熵 → KL 散度 → 分类损失。
第一步:自信息(Self-Information)
一个事件 x 的自信息量定义为:
概率越小的事件,发生时带来的”信息量”越大。掷硬币正面(p=0.5)信息量为 1 bit;掷出六面骰子的某一面(p=1/6)信息量约 2.58 bit。
第二步:熵(Entropy)—— 自信息的期望
分布 p 的熵是所有可能事件的自信息的期望:
熵衡量分布的”不确定性”:均匀分布熵最大(最不确定),确定分布熵为零。
第三步:交叉熵(Cross-Entropy)—— 用分布 q 编码分布 p 的代价
如果真实分布是 p,但我们用分布 q 来编码,所需的信息量期望就是交叉熵:
第四步:KL 散度(Kullback-Leibler Divergence)—— p 与 q 的差距
因此交叉熵与 KL 散度的关系为:
关键洞察:当 p 是固定的真实标签分布时,H(p) 是常数,最小化交叉熵 H(p,q) 等价于最小化 KL 散度——即让模型分布 q 尽可能接近真实分布 p。
第五步:从交叉熵到分类损失
在分类任务中,真实标签是 one-hot 向量 y(只有正确类别为 1,其余为 0),模型输出 softmax 概率为 p。套用交叉熵:
由于 one-hot 中只有一个 ,其余为 0:
这就完成了从信息论到分类损失的完整推导——分类的交叉熵损失就是”模型对正确类别赋予的概率的自信息的负值”。模型对正确类别越自信( 越大),损失越小。
二元分类是多分类的特例(y 取 0 或 1):
为什么分类不用 MSE? 如果在 softmax 输出上用 MSE,梯度会在预测接近 0 或 1 时趋近于零(梯度消失),导致学习极慢。交叉熵配合 softmax 的梯度恰好是 ——简单且不会梯度消失,这是信息论设计带来的数学优势。
Label Smoothing Cross-Entropy(标签平滑交叉熵)
Section titled “Label Smoothing Cross-Entropy(标签平滑交叉熵)”标签平滑(Label Smoothing,Szegedy et al., CVPR 2016)将 one-hot 硬标签”软化”——不再给正确类别 100% 概率,而是分一点给其他类别:
其中 是平滑因子(通常 0.1),K 是类别数。交叉熵变为:
直觉:one-hot 标签告诉模型”正确类别概率必须是 1”——这过于绝对,容易导致过拟合和过度自信。标签平滑相当于告诉模型”你大概率是对的,但保留一点不确定性”,起到正则化效果。在 ImageNet 分类和机器翻译(Transformer)中被广泛使用。
Focal Loss
Section titled “Focal Loss”Focal Loss(Lin et al., ICCV 2017)在交叉熵基础上加一个调节因子 ,自动降低易分类样本的权重:
当 p 接近 1(已分对)时 趋近于 0,损失被大幅压低;当 p 小(难样本)时因子接近 1,损失几乎不变。 通常取 2。这是 RetinaNet 目标检测器成功的关键。
梯度分析:为什么 能降低易样本梯度?
以二分类、正确标签 y=1 为例,设模型对正确类别的预测概率为 p。标准交叉熵的损失和梯度为:
Focal Loss 的损失和梯度为:
关键对比——易样本()的梯度量级:
即:对于已经分对的样本(),标准交叉熵仍然贡献约 1.0 量级的梯度;而 Focal Loss 的梯度被 因子压缩到接近 0。 越大,压缩越激进。这就是 Focal Loss “聚焦难样本”的数学本质——通过梯度量级的自动缩放,让易样本在反向传播中几乎不产生参数更新。
在目标检测中,背景框(易分对的负样本)通常占 1000:1 的比例。标准 CE 下这些海量易样本的梯度之和会淹没真正有用的难样本信号;Focal Loss 把易样本的梯度压到接近零,让优化器专注于难样本。
Hinge Loss(SVM)
Section titled “Hinge Loss(SVM)”SVM(支持向量机)的标准损失,要求正确类的得分比其他类高出至少一个间隔 margin:
只惩罚间隔内的违例,间隔外则损失为 0——这正是 SVM “最大间隔”思想在损失函数层面的体现。详见SVM 支持向量机。
Triplet Loss
Section titled “Triplet Loss”人脸识别 / 嵌入学习的经典损失。每次取一个锚样本(anchor)、一个正样本(positive,同类)、一个负样本(negative,异类),要求锚与正的距离小于锚与负的距离至少一个 margin:
其中 d 是距离函数(通常为欧氏距离)。详见自监督与对比学习。
Contrastive Loss
Section titled “Contrastive Loss”对比损失(Contrastive Loss)与 Triplet Loss 类似,但每次只用一对样本(正对或负对):
Cosine Embedding Loss(余弦嵌入损失)
Section titled “Cosine Embedding Loss(余弦嵌入损失)”余弦嵌入损失用向量夹角的余弦值衡量相似度,要求正对余弦大、负对余弦小:
其中 ,margin 通常取 0.0~0.5。PyTorch 中对应 nn.CosineEmbeddingLoss。
直觉:与 Contrastive Loss 用欧氏距离不同,Cosine Embedding Loss 只看方向不看模长——这对嵌入学习特别有用,因为我们关心的是嵌入在空间中的”角度位置”而非”绝对长度”。在句子相似度、推荐系统中广泛使用。
Dice Loss
Section titled “Dice Loss”Dice 系数(Dice Coefficient,又称 F1 score 的集合形式)衡量两个集合的重叠度,Dice Loss = 1 - Dice:
在像素级分割中,A 是预测的前景区域、B 是真实标注区域。Dice Loss 直接优化重叠度,对类别不平衡(前景像素远少于背景)天然友好。详见图像分割。
IoU Loss
Section titled “IoU Loss”IoU(Intersection over Union,交并比)= 交集面积 / 并集面积。IoU Loss = 1 - IoU,在目标检测的边界框回归中广泛使用。详见目标检测与 YOLO。
Lovasz Loss
Section titled “Lovasz Loss”Lovasz Loss(Berman et al., CVPR 2018)是 IoU 的凸代理(convex surrogate)。IoU 本身是阶跃函数(不可导),无法直接用梯度下降优化。Lovasz Loss 利用集合论中的 Lovász 扩展(Lovász extension),将离散的 IoU 连续化为可导函数:
Lovasz-Hinge (二分类): 将 Jaccard 集合损失通过 Lovász 扩展转化为凸函数Lovasz-Softmax (多分类): 对每个类别做 softmax 概率的 Lovász 扩展直觉:IoU Loss 当预测稍有偏差时梯度为零(不可导),Lovász Loss 提供了平滑的梯度信号——“离正确分割越近,梯度越温和地引导你继续靠近”。在实践中常与 Cross-Entropy 组合使用,效果优于单独使用 Dice 或 IoU Loss。
知识蒸馏损失
Section titled “知识蒸馏损失”KL 散度损失
Section titled “KL 散度损失”知识蒸馏(Knowledge Distillation,Hinton et al., 2015)的核心损失。学生模型(student)学习老师模型(teacher)输出的软标签分布:
其中 q 通过温度缩放(temperature scaling)获得:
T > 1 使 softmax 输出更”软”(更平滑),暴露出类间关系(“猫不像狗,但比像卡车更接近”)——这些”暗知识”(dark knowledge)比硬标签包含更丰富的信息。完整蒸馏损失通常是:
直觉:硬标签说”这是猫”,软标签说”这大概率是猫,但也有一点像狗和兔子的特征”——后者提供了更密集的学习信号。详见知识蒸馏。
对比学习损失
Section titled “对比学习损失”InfoNCE
Section titled “InfoNCE”InfoNCE(Informational Noise Contrastive Estimation,信息论噪声对比估计)是现代对比学习的核心损失(SimCLR、MoCo、CLIP 都在用)。给定一个正样本对和 K 个负样本:
其中 sim 是相似度(如余弦相似度), 是温度系数。详见自监督与对比学习。
InfoNCE 与交叉熵的等价性推导
InfoNCE 看起来和交叉熵不同,但本质完全一样——只需做变量替换。
将 sim(q, k_i) / τ 记为 logit (相似度除以温度就是”未归一化的分数”),则:
这与多类交叉熵 形式完全相同——正样本就是”正确类别”,K 个负样本就是”其他类别”。
InfoNCE = CrossEntropy 正样本 k+ ←→ 正确类别 负样本 k_i ←→ 错误类别 sim(q,k)/τ ←→ logit z_j唯一的区别在于:分类的 logits 来自分类头的线性层,而 InfoNCE 的 logits 来自样本对之间的相似度。这就是 InfoNCE 被称为”对比版本的交叉熵”的原因——它把对比学习统一到了分类框架中。
最新进展(2024–2025)
Section titled “最新进展(2024–2025)”偏好学习损失:从 RLHF 到 DPO 及其变体
Section titled “偏好学习损失:从 RLHF 到 DPO 及其变体”传统的 RLHF(Reinforcement Learning from Human Feedback)需要两阶段:先训练一个奖励模型(Reward Model),再用 PPO 等 RL 算法优化 LLM。2023 年 DPO 的提出改变了这一范式——直接从偏好数据训练,无需 RL。
DPO(Direct Preference Optimization,直接偏好优化,Rafailov et al., NeurIPS 2023)
DPO 的核心洞见:可以通过一个简单的损失函数,将人类偏好数据直接映射到策略优化,绕过显式的奖励模型。给定偏好对(chosen response ,rejected response ):
其中 是当前策略(LLM), 是参考策略(冻结的初始 LLM), 控制偏离参考策略的程度, 是 sigmoid。直觉上:让模型对 chosen 的对数似然比(相对于参考模型)高于 rejected。
IPO(Identity Preference Optimization,2024):指出 DPO 在偏好确定性高时会过拟合(DPO 损失可以趋于零但泛化变差),用二次损失替代对数损失:
KTO(Kahneman-Tversky Optimization,2024):DPO 需要成对偏好数据(“A 比 B 好”),KTO 只需要二元反馈(“这条回答好/不好”)——数据采集成本更低:
利用行为经济学的前景理论(Prospect Theory)建模:人对”好”和”不好”的效用函数不对称(损失厌恶)。
| 方法 | 数据需求 | 优势 | 劣势 |
|---|---|---|---|
| RLHF (PPO) | 偏好数据 + RM | 理论最优,灵活 | 训练不稳定,需 4 个模型同时在线 |
| DPO | 成对偏好数据 | 简单稳定,无需 RL | 需要高质量配对数据 |
| IPO | 成对偏好数据 | 抗过拟合 | 收敛较慢 |
| KTO | 二元反馈(好/不好) | 数据成本最低,效果好 | 效果略逊 DPO |
大模型训练中的损失创新
Section titled “大模型训练中的损失创新”Z-loss(Logit Zapping Loss)
PaLM(Chowdhery et al., 2022)和 GPT-4 报告中提到的辅助损失,用于稳定训练:
惩罚 logits 的绝对值过大。直觉:训练中个别 logit 可能爆炸性增长,导致 softmax 溢出或梯度不稳定。Z-loss 以极小权重()将 logsumexp 拉向零,防止 logits 漂移——代价极小,收益是训练稳定性显著提升。
MoE 辅助损失(Load Balancing Loss)
混合专家模型(Mixture of Experts,MoE)中,如果所有 token 都被路由到少数几个专家(expert),会导致负载不均衡和训练崩溃。Load Balancing Loss 强制 token 均匀分布到各专家:
其中 是分配到专家 i 的 token 比例, 是 router 对专家 i 的平均概率。当所有专家均匀分配时此损失最小。Switch Transformer、GShard、Mixtral 都使用了这一辅助损失。
多模态对比损失新进展
SigLIP(Zhai et al., ICCV 2023)将 CLIP 的 InfoNCE 损失从 softmax 形式改为 sigmoid 形式:
每个图文对独立计算,不需要全 batch 的 softmax 归一化。这使得 batch size 可以大幅扩展(不再受 GPU 显存中 softmax 计算的限制),且实验效果优于 CLIP。
不同损失函数的梯度行为对比
Section titled “不同损失函数的梯度行为对比”同样是误差(预测值 - 真实值),不同损失函数给出的梯度大小截然不同,这直接决定了模型如何学习:
分类损失家族
Section titled “分类损失家族”PyTorch:各类损失函数的基本用法
Section titled “PyTorch:各类损失函数的基本用法”import torchimport torch.nn as nn
# --- 回归损失 ---pred = torch.randn(8, 1) # 模型预测值target = torch.randn(8, 1) # 真实值mse = nn.MSELoss()(pred, target) # 均方误差mae = nn.L1Loss()(pred, target) # 平均绝对误差huber = nn.HuberLoss(delta=1.0)(pred, target) # Huber 损失
# --- 分类损失 ---logits = torch.randn(8, 10) # 10 类的原始输出labels = torch.randint(0, 10, (8,)) # 真实类别索引ce = nn.CrossEntropyLoss()(logits, labels) # 多类交叉熵(内含 softmax)
# Focal Loss 需要手动实现或用第三方库 torchvision.opsdef focal_loss(logits, labels, gamma=2.0, alpha=0.25): """简化版 Focal Loss""" ce = nn.functional.cross_entropy(logits, labels, reduction='none') p = torch.exp(-ce) # 预测概率 return (alpha * (1 - p) ** gamma * ce).mean()
fl = focal_loss(logits, labels) # Focal Loss
print(f"MSE={mse:.3f} CE={ce:.3f} Focal={fl:.3f}")从头实现:数值稳定的交叉熵 + Softmax
Section titled “从头实现:数值稳定的交叉熵 + Softmax”交叉熵与 softmax 合并计算时,直接 log(softmax(z)) 会遇到数值溢出问题(exp 大 logit → inf)。标准技巧是用 LogSumExp 重写:
import torchimport torch.nn.functional as F
def stable_cross_entropy_with_softmax(logits, labels):    """    从头实现数值稳定的交叉熵损失(合并 softmax + NLL)。
    数学推导:        CE = -log softmax(z)[correct]           = -log[ exp(z_correct) / Σ exp(z_j) ]           = -(z_correct - logsumexp(z))           = logsumexp(z) - z_correct
    logsumexp(z) = max(z) + log Σ exp(z_j - max(z))   ← 减去 max 防溢出
    Args:        logits:  (N, C)  未归一化的预测分数        labels:  (N,)     正确类别的索引    Returns:        scalar loss    """    # 第 1 步:数值稳定的 logsumexp    z_max = logits.max(dim=-1, keepdim=True).values          # (N, 1) 减最大值防 exp 溢出    exp_shifted = torch.exp(logits - z_max)                  # (N, C) 全是 ≤1 的值,不会溢出    sum_exp = exp_shifted.sum(dim=-1, keepdim=True)          # (N, 1)    log_sum_exp = z_max.squeeze(-1) + torch.log(sum_exp)     # (N,) 还原:logsumexp(z)
    # 第 2 步:取出正确类别的 logit    z_correct = logits.gather(1, labels.unsqueeze(1)).squeeze(1)  # (N,)
    # 第 3 步:CE = logsumexp(z) - z_correct    loss_per_sample = log_sum_exp - z_correct                # (N,)
    return loss_per_sample.mean()

# 验证与 PyTorch 官方实现一致logits = torch.randn(8, 10)labels = torch.randint(0, 10, (8,))
my_ce = stable_cross_entropy_with_softmax(logits, labels)torch_ce = F.cross_entropy(logits, labels)
print(f"从头实现: {my_ce.item():.6f}")print(f"PyTorch:  {torch_ce.item():.6f}")print(f"误差:     {abs(my_ce - torch_ce).item():.2e}")       # 应 < 1e-6
# 极端值测试:大 logit 不会溢出(直接 softmax 会 inf)extreme_logits = torch.tensor([[1000.0, 0.0, 0.0]])extreme_labels = torch.tensor([0])print(f"极端值损失: {stable_cross_entropy_with_softmax(extreme_logits, extreme_labels).item():.4f}")  # 应 ≈ 0.0
DPO 损失的 PyTorch 实现
Section titled “DPO 损失的 PyTorch 实现”import torchimport torch.nn as nnimport torch.nn.functional as F
def dpo_loss(policy_chosen_logps, # (B,) 策略模型对 chosen 回答的 log 概率 policy_rejected_logps, # (B,) 策略模型对 rejected 回答的 log 概率 ref_chosen_logps, # (B,) 参考模型(冻结)对 chosen 的 log 概率 ref_rejected_logps, # (B,) 参考模型(冻结)对 rejected 的 log 概率 beta=0.1): """ Direct Preference Optimization (DPO) 损失。
L = -log σ(β * [Δlog π(chosen) - Δlog π(rejected)])
其中 Δlog π(y) = log π_θ(y|x) - log π_ref(y|x),即当前策略相对于 参考策略的对数似然变化。直觉:让策略模型对 chosen 的相对似然 高于 rejected。
Args: beta: KL 散度惩罚系数,越大越保守(更接近参考模型) Returns: scalar loss, 和三个用于监控的指标 """ # 对数比率(当前策略 vs 参考策略) chosen_logratio = policy_chosen_logps - ref_chosen_logps # (B,) rejected_logratio = policy_rejected_logps - ref_rejected_logps # (B,)
# DPO 的核心:chosen 的相对优势 logits = beta * (chosen_logratio - rejected_logratio) # (B,)
# 损失 = 二元交叉熵,label 全为 1(我们希望 chosen 赢) loss = -F.logsigmoid(logits).mean()
# 监控指标 chosen_rewards = beta * chosen_logratio.detach() rejected_rewards = beta * rejected_logratio.detach() accuracy = (chosen_rewards > rejected_rewards).float().mean() # 偏好准确率 margin = (chosen_rewards - rejected_rewards).mean() # 奖励间隔
return loss, accuracy, margin, chosen_rewards.mean(), rejected_rewards.mean()
# 模拟训练中的一步B = 4 # batch sizeseq_len = 128
# 假设我们已经用策略模型和参考模型分别计算了每个回答的 log 概率# (实际中需要对序列的 token-level log 概率求和)torch.manual_seed(42)policy_chosen = torch.randn(B, requires_grad=True) * 2 - 3 # 模型当前对 chosen 的 logppolicy_rejected = torch.randn(B, requires_grad=True) * 2 - 4 # 模型当前对 rejected 的 logpref_chosen = torch.randn(B) * 2 - 3 # 参考模型(不参与梯度)ref_rejected = torch.randn(B) * 2 - 4
loss, acc, margin, cr, rr = dpo_loss( policy_chosen, policy_rejected, ref_chosen, ref_rejected, beta=0.1)
print(f"DPO Loss: {loss.item():.4f}")print(f"偏好准确率: {acc.item():.2%}")print(f"奖励间隔: {margin.item():.4f}")print(f"Chosen reward: {cr.item():.4f} Rejected reward: {rr.item():.4f}")
loss.backward() # 梯度会流入 policy_chosen / policy_rejectedLabel Smoothing Cross-Entropy 实现
Section titled “Label Smoothing Cross-Entropy 实现”import torchimport torch.nn as nnimport torch.nn.functional as F
def label_smoothing_cross_entropy(logits, labels, smoothing=0.1): """ Label Smoothing Cross-Entropy(标签平滑交叉熵)。
将 one-hot 标签软化为: y_smooth = (1 - ε) * onehot + ε / K
然后计算与模型分布的交叉熵。
Args: logits: (N, C) labels: (N,) smoothing: ε,平滑因子,通常 0.1 """ K = logits.size(-1) # 类别数
# 构造软标签:(1-ε) 在正确位置,ε/K 在所有位置 with torch.no_grad(): smooth = torch.full_like(logits, smoothing / K) # (N, C) 全部 ε/K smooth.scatter_(1, labels.unsqueeze(1), 1.0 - smoothing + smoothing / K)
# 计算交叉熵: -Σ y_smooth * log_softmax(logits) log_probs = F.log_softmax(logits, dim=-1) # (N, C) loss = -(smooth * log_probs).sum(dim=-1).mean()
return loss
# 对比标准 CE vs Label Smoothing CElogits = torch.randn(8, 10)labels = torch.randint(0, 10, (8,))
standard_ce = F.cross_entropy(logits, labels).item()smoothed_ce = label_smoothing_cross_entropy(logits, labels, smoothing=0.1).item()
print(f"标准交叉熵: {standard_ce:.4f}")print(f"标签平滑 CE (ε=0.1): {smoothed_ce:.4f}")# 平滑版本通常略高,因为引入了对其他类别的"预留概率"Triplet Loss 用法
Section titled “Triplet Loss 用法”import torch.nn as nn
# 锚、正、负样本的嵌入向量(假设已通过同一个编码器提取)anchor = torch.randn(4, 128)positive = torch.randn(4, 128) # 与 anchor 同类negative = torch.randn(4, 128) # 与 anchor 异类
# Triplet Loss:拉近距离 positive,推远 negativetriplet = nn.TripletMarginLoss(margin=1.0, p=2) # p=2 即欧氏距离loss = triplet(anchor, positive, negative)print(f"Triplet Loss = {loss.item():.4f}")可视化:损失函数曲线对比
Section titled “可视化:损失函数曲线对比”"""绘制常见回归和分类损失函数的曲线,直观对比它们的梯度行为。运行: python visualize_losses.py"""import numpy as npimport matplotlib.pyplot as plt
# ============ 回归损失(误差的函数) ============error = np.linspace(-3, 3, 500)
mse = error ** 2mae = np.abs(error)delta = 1.0huber = np.where(np.abs(error) <= delta, 0.5 * error ** 2, delta * np.abs(error) - 0.5 * delta ** 2)
fig, axes = plt.subplots(1, 2, figsize=(14, 5))
# --- 左图:回归损失 ---ax = axes[0]ax.plot(error, mse, label='MSE (L2)', linewidth=2)ax.plot(error, mae, label='MAE (L1)', linewidth=2)ax.plot(error, huber, label=f'Huber (δ={delta})', linewidth=2)ax.set_xlabel('误差 (预测 - 真实)', fontsize=12)ax.set_ylabel('Loss', fontsize=12)ax.set_title('回归损失对比', fontsize=14)ax.legend(fontsize=11)ax.set_ylim(-0.5, 6)ax.axhline(y=0, color='gray', linewidth=0.5)ax.axvline(x=0, color='gray', linewidth=0.5)ax.grid(True, alpha=0.3)
# --- 右图:分类损失(预测概率的函数,假设正确类别 y=1) ---p = np.linspace(0.01, 0.99, 500) # 模型对正确类别的预测概率
ce = -np.log(p) # 标准交叉熵for gamma, color in [(0.5, '#FF9800'), (2.0, '#e91e63'), (5.0, '#9C27B0')]: focal = (1 - p) ** gamma * (-np.log(p)) # Focal Loss (归一化前) focal_normalized = focal / focal.max() * ce.max() # 归一化到与 CE 同尺度 axes[1].plot(p, focal_normalized, label=f'Focal (γ={gamma})', linewidth=2, color=color, linestyle='--')
axes[1].plot(p, ce, label='Cross-Entropy', linewidth=3, color='#2196F3')axes[1].set_xlabel('预测概率 p (正确类别)', fontsize=12)axes[1].set_ylabel('Loss', fontsize=12)axes[1].set_title('分类损失对比(归一化)', fontsize=14)axes[1].legend(fontsize=11)axes[1].grid(True, alpha=0.3)
plt.tight_layout()plt.savefig('loss_functions_comparison.png', dpi=150, bbox_inches='tight')plt.show()print("图表已保存: loss_functions_comparison.png")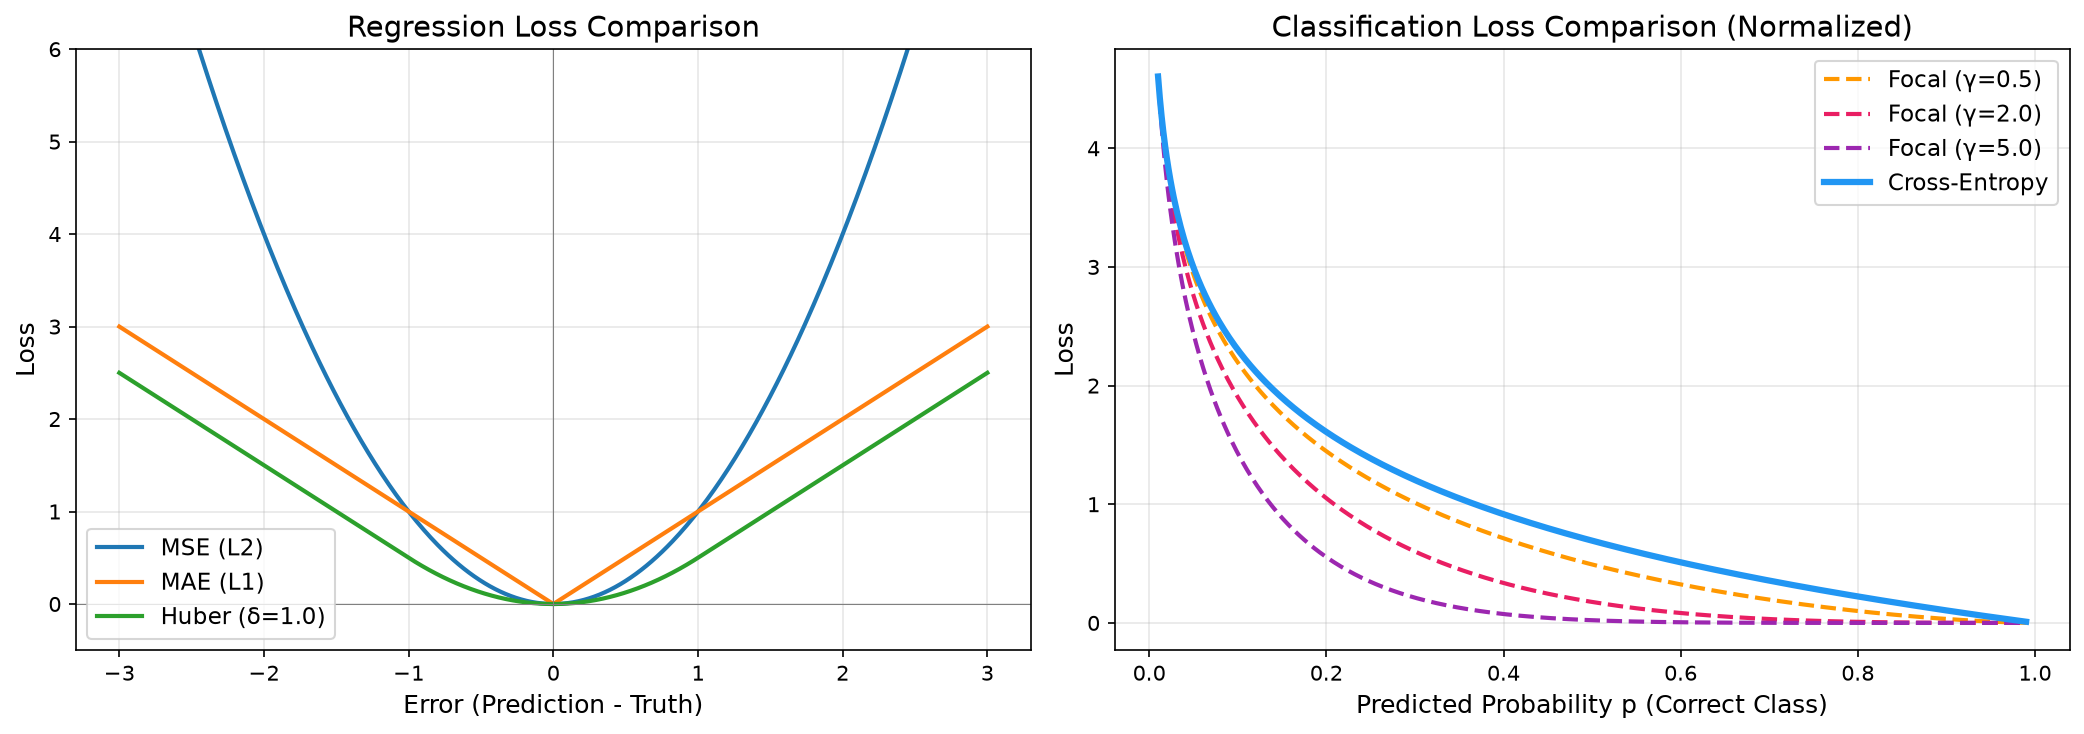
读图要点:
- 左图(回归):MSE 在大误差处急剧上升(对异常值敏感),MAE 线性增长(恒定梯度),Huber 在小误差处与 MSE 重合、大误差处与 MAE 平行。
- 右图(分类):当 (已分对),标准交叉熵仍有显著损失值,而 Focal Loss 的损失快速趋近于 0( 越大越激进)。这正是 Focal Loss 降低易样本权重的视觉体现。
- 回归默认用 MSE,如果数据有较多异常值,换 Huber Loss 或 MAE。MAE 梯度恒定,建议配合自适应优化器(如 Adam)使用。
- 分类默认用 CrossEntropyLoss:PyTorch 的
nn.CrossEntropyLoss内部已做 softmax,不要在模型最后一层再加 softmax,否则等于做了两次。 - 多标签分类用 BCEWithLogitsLoss:每个类别独立做二分类,不要用 CrossEntropyLoss。
- 类别极不平衡时用 Focal Loss:如目标检测中背景框远多于前景框。、 是 RetinaNet 中的经典默认值。
- 分割任务中 Dice + CE 组合常见:Dice 处理类别不平衡,CE 提供稳定的逐像素监督,二者加权求和效果通常优于单一损失。Lovász Loss 是更高级的替代。
- Triplet Loss 的关键在采样策略:随机选 negative 太容易(模型学不到东西)或太难(训练崩溃)。半难挖掘(Semi-Hard Mining)是实际中常用的折中方案。
- InfoNCE 的温度 很敏感: 太大判别力弱、太小梯度不稳定。SimCLR 用 0.5、CLIP 用 0.07 经 logistic 缩放。
- 知识蒸馏用 KL 散度损失:温度 T 通常取 4~8。T 太小学生学不到”暗知识”,T 太大学生输出过于平滑、丧失自身判断。
- DPO 训练用 控制偏离度: 太小模型偏离参考模型太远(可能输出有害内容), 太大学不到偏好信号。常见值 0.1~0.5。
- 图像分类:ImageNet 训练用多类交叉熵,Inception/ResNet 后期常用 Label Smoothing CE。详见CNN 卷积神经网络。
- 目标检测:RetinaNet / YOLO 用 Focal Loss 解决正负样本极度不平衡。详见目标检测与 YOLO。
- 图像分割:U-Net 等用 Dice Loss 或 Dice + CE 组合;Lovász Loss 用于直接优化 IoU。详见图像分割。
- 人脸识别:FaceNet 用 Triplet Loss 学习人脸嵌入,ArcFace 用改进的 Additive Margin Softmax。详见自监督与对比学习。
- 大语言模型预训练:GPT 系列用 token 级别的交叉熵(预测下一个词),PaLM/GPT-4 辅以 Z-loss 稳定训练。详见语言模型演进。
- LLM 对齐(Alignment):RLHF 用 PPO + 奖励模型;DPO 及其变体(IPO/KTO)用偏好损失直接优化。详见RLHF 与大模型训练。
- 对比学习:SimCLR / CLIP 用 InfoNCE 学习通用视觉-语言嵌入;SigLIP 用 sigmoid 变体扩展 batch size。详见自监督与对比学习。
- 知识蒸馏:DistilBERT 等用 KL 散度损失将大模型压缩为小模型。详见知识蒸馏。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| torch.nn | Python | PyTorch 内置损失函数:MSELoss、CrossEntropyLoss、BCEWithLogitsLoss、TripletMarginLoss、CosineEmbeddingLoss 等 |
| torch.nn.functional | Python | 函数式接口,灵活组合自定义损失(如 Focal Loss、DPO Loss) |
| tf.keras.losses | Python | TensorFlow / Keras 损失函数模块,覆盖类型与 PyTorch 对应 |
| torchvision.ops | Python | 提供 sigmoid_focal_loss 等视觉专用损失的官方实现 |
| segmentation_models_pytorch | Python | 分割库,内置 Dice Loss、Lovasz Loss 等分割专用损失 |
| trl | Python | Hugging Face 的 Transformer RL 库,提供 DPO、PPO、KTO 等 LLM 对齐损失的现成实现 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 损失函数 | Loss Function | 衡量模型预测与真实标签之间差距的函数,训练的目标是最小化它 |
| 均方误差 | MSE / L2 Loss | 预测值与真实值之差的平方均值,对大误差惩罚重 |
| 平均绝对误差 | MAE / L1 Loss | 预测值与真实值之差的绝对值均值,对异常值鲁棒 |
| Huber Loss | Huber Loss | 小误差区域用 MSE、大误差区域切换为 MAE,兼具两者优点 |
| 偏差-方差分解 | Bias-Variance Decomposition | 将 MSE 分解为偏差² + 方差 + 不可约噪声的理论框架 |
| 交叉熵 | Cross-Entropy | 信息论度量,分类任务的标准损失,惩罚预测概率偏离真实标签 |
| 标签平滑交叉熵 | Label Smoothing CE | 将 one-hot 标签软化为 ,起到正则化效果 |
| Focal Loss | Focal Loss | 交叉熵加调节因子,降低易分类样本权重,解决类别不平衡 |
| Hinge Loss | Hinge Loss | SVM 的标准损失,要求正确类得分比其他类高出至少一个间隔 |
| Triplet Loss | Triplet Loss | 拉近同类嵌入、推远异类嵌入的损失,用于人脸识别等嵌入学习 |
| 对比损失 | Contrastive Loss | 基于样本对的损失,正对拉近、负对推远 |
| 余弦嵌入损失 | Cosine Embedding Loss | 用余弦相似度衡量嵌入方向差异的损失,关注方向而非模长 |
| Dice Loss | Dice Loss | 基于集合重叠度的损失,常用于图像分割,对类别不平衡友好 |
| Lovász Loss | Lovász Loss | IoU/Jaccard 的凸代理,将离散的 IoU 连续化为可导函数 |
| InfoNCE | InfoNCE | 对比学习的核心损失,本质是”正样本 vs 一组负样本”的分类问题 |
| KL 散度损失 | KL Divergence Loss | 衡量两个概率分布差异的损失,知识蒸馏的核心损失 |
| DPO 损失 | DPO Loss | 直接偏好优化损失,绕过奖励模型直接从人类偏好数据训练 LLM |
| Z-loss | Z-loss | 惩罚 logsumexp 的辅助损失,防止 logits 爆炸,稳定大模型训练 |
| 温度系数 | Temperature τ | InfoNCE / 知识蒸馏中控制分布锐度的超参数 |
经典论文
- Lin et al.,「Focal Loss for Dense Object Detection」(ICCV 2017):Focal Loss 原始论文(RetinaNet),解决目标检测中正负样本极度不平衡问题,引用量极高。
- Schroff et al.,「FaceNet: A Unified Embedding for Face Recognition」(CVPR 2015):Triplet Loss 和 FaceNet 论文,奠定了人脸识别嵌入学习的基础。
- Oord et al.,「Representation Learning with Contrastive Predictive Coding」(2018):InfoNCE 损失的提出论文,现代对比学习的理论源头。
- Milletari et al.,「V-Net: Fully Convolutional Neural Networks for Volumetric Medical Image Segmentation」(2016):Dice Loss 的提出论文,3D 医学图像分割。
- Szegedy et al.,「Rethinking the Inception Architecture for Computer Vision」(CVPR 2016):Label Smoothing 的提出论文。
- Hinton et al.,「Distilling the Knowledge in a Neural Network」(2015):知识蒸馏开山之作,KL 散度损失 + 温度缩放。
- Berman et al.,「The Lovász-Softmax Loss」(CVPR 2018):Lovász Loss 原始论文,IoU 的凸代理。
- Goodfellow et al.,「Deep Learning」第 5–6 章:深度学习经典教材,系统讲解 MSE、交叉熵等损失函数的数学推导。
2023–2025 前沿论文
- Rafailov et al.,「Direct Preference Optimization: Your Language Model is Secretly a Reward Model」(NeurIPS 2023):DPO 原始论文,RLHF 的新范式,绕过显式奖励模型直接从偏好数据训练。
- Azar et al.,「A General Theoretical Paradigm to Understand Learning from Human Feedback」(2024):IPO 的提出论文,指出 DPO 的过拟合问题并用恒定学习率替代。
- Ethayarajh et al.,「KTO: Model Alignment as Prospect Theoretic Optimization」(ICML 2024):KTO 论文,只需二元反馈数据(而非成对偏好),利用前景理论建模。
- Zhai et al.,「Sigmoid Loss for Language Image Pre-Training」(ICCV 2023):SigLIP 论文,将 InfoNCE 的 softmax 损失替换为 sigmoid 形式,大幅扩展 batch size。
- Chowdhery et al.,「PaLM: Scaling Language Modeling with Pathways」(2022):Z-loss 辅助损失在大模型训练中的应用。
- Shazeer et al.,「Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer」(ICLR 2017):MoE 辅助负载均衡损失的起源。