
数据预处理
数据预处理是机器学习流水线的第一步,也是对最终效果影响最大的一步——行业里常说”Garbage In, Garbage Out”(垃圾进,垃圾出)。研究反复表明,数据科学家 60%–80% 的时间花在数据清洗与特征准备上,而更干净的数据往往比更复杂的模型更能提升效果。本页梳理从数值缩放、缺失值处理到类别编码、特征变换的完整预处理工具箱,并给出数学推导与可运行代码。前置阅读:线性代数基础、概率论基础、数值优化与数学基础。
把数据想象成食材,模型是菜谱——再好的菜谱也救不了变质的食材:
- 数值标准化(Z-Score) = 把所有食材切成一样大小的块,这样锅(优化器)能均匀加热每一块。有的特征值上万、有的特征值不到 1,直接喂给模型,值大的特征会完全主导。
- 数值归一化(Min-Max) = 把所有食材压到同一个盘子里(0 到 1 之间),保证大小一致。和标准化类似,但保留了”范围”信息,适合已知上下界的特征。
- 缺失值处理(Imputation) = 食材缺了一块怎么办?要么扔掉整道菜(删行)、要么拿替代品凑(填充均值/中位数)、要么让模型自己猜(插值)。Imputation 即”插补”,指用某种策略填补缺失值。
- 类别编码(One-Hot) = 颜色”红/绿/蓝”这种文本标签模型看不懂,用三条独立开关表示:红色 =
[1,0,0],绿色 =[0,1,0],蓝色 =[0,0,1]。 - 类别编码(Target Encoding) = 直接用”红色样本的平均房价”来替代”红色”这个标签——信息量更大,但要小心过拟合(Overfitting,即模型在训练集上记住了答案却不会泛化),相当于训练时偷看了答案。
- 异常值检测(Outlier Detection) = 在一篮子食材里挑出明显坏掉的——比如一个重达 500 公斤的”土豆”八成是录入错误,在烹饪之前就该扔掉。
为什么预处理如此关键:一个数学视角
Section titled “为什么预处理如此关键:一个数学视角”以最常见的梯度下降(Gradient Descent)为例,损失函数 对参数 的更新规则为:
其中 是学习率(Learning Rate)。当不同特征的量纲(Scale,即数值范围)差异巨大时,损失函数的等高线会变成一个细长的椭圆。形象地说,误差曲面像一个狭长的山谷——梯度方向并不指向最低点,优化器不得不呈”之”字形缓慢前进,收敛极慢。
条件数与收敛速度的严格推导
Section titled “条件数与收敛速度的严格推导”用数学语言描述:设损失函数在最优解 附近可以用二阶泰勒展开近似为二次型:
其中 是 Hessian 矩阵(二阶偏导数矩阵,)。梯度为:
代入梯度下降更新规则,令误差向量 :
将 做特征值分解(Eigendecomposition),其中 。在特征基(Eigenbasis)下:
即每个特征方向独立衰减:
经过 步迭代后:
为了让所有方向都收敛,需要 ,即 。学习率受最大特征值约束。但最小特征值方向 的衰减率为 ,当 时, 被迫取很小的值, 方向收敛极慢。
条件数(Condition Number)。可以证明,要使误差减小到初始的 ,所需迭代步数:
也就是说,迭代次数与条件数成正比。标准化让各维度方差接近,从而降低 ,让误差曲面更接近圆形碗,优化器能径直滑向最低点。
一句话记忆:标准化不是为了让数据”好看”,而是为了让优化器”好走”。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)n = 1000age = np.random.normal(40, 12, n).clip(18, 80)income = np.random.lognormal(11, 0.6, n)score = np.random.beta(2, 5, n) * 10
features = [("Age", age, "#e91e63", "#2196F3"),            ("Income", income, "#FF9800", "#4CAF50"),            ("Score", score, "#9C27B0", "#00BCD4")]
fig, axes = plt.subplots(2, 3, figsize=(14, 7))fig.patch.set_facecolor("white")
for i, (name, data, raw_color, scaled_color) in enumerate(features):    axes[0, i].hist(data, bins=50, color=raw_color, alpha=0.7, edgecolor="white", linewidth=0.5)    axes[0, i].axvline(data.mean(), color="black", linestyle="--", linewidth=1.5, label=f"mean={data.mean():.1f}")    axes[0, i].set_title(f"{name} (Raw)\nstd={data.std():.1f}", fontsize=10, fontweight="bold")    axes[0, i].legend(fontsize=8); axes[0, i].grid(axis="y", alpha=0.15, linestyle="--")
    standardized = (data - data.mean()) / data.std()    axes[1, i].hist(standardized, bins=50, color=scaled_color, alpha=0.7, edgecolor="white", linewidth=0.5)    axes[1, i].axvline(0, color="black", linestyle="--", linewidth=1.5, label="mean=0, std=1")    axes[1, i].set_title(f"{name} (Z-Score Standardized)\nstd=1.0", fontsize=10, fontweight="bold")    axes[1, i].legend(fontsize=8); axes[1, i].grid(axis="y", alpha=0.15, linestyle="--")
plt.suptitle("Feature Distributions: Before vs After Z-Score Standardization",             fontsize=13, fontweight="bold", y=1.01)plt.tight_layout()plt.savefig("/mnt/kvm_ata-Netac_SSD_480GB_AA000000000000000904-part1/proj/docs/img/generated/standardization-histogram.png",            dpi=180, bbox_inches="tight", facecolor="white")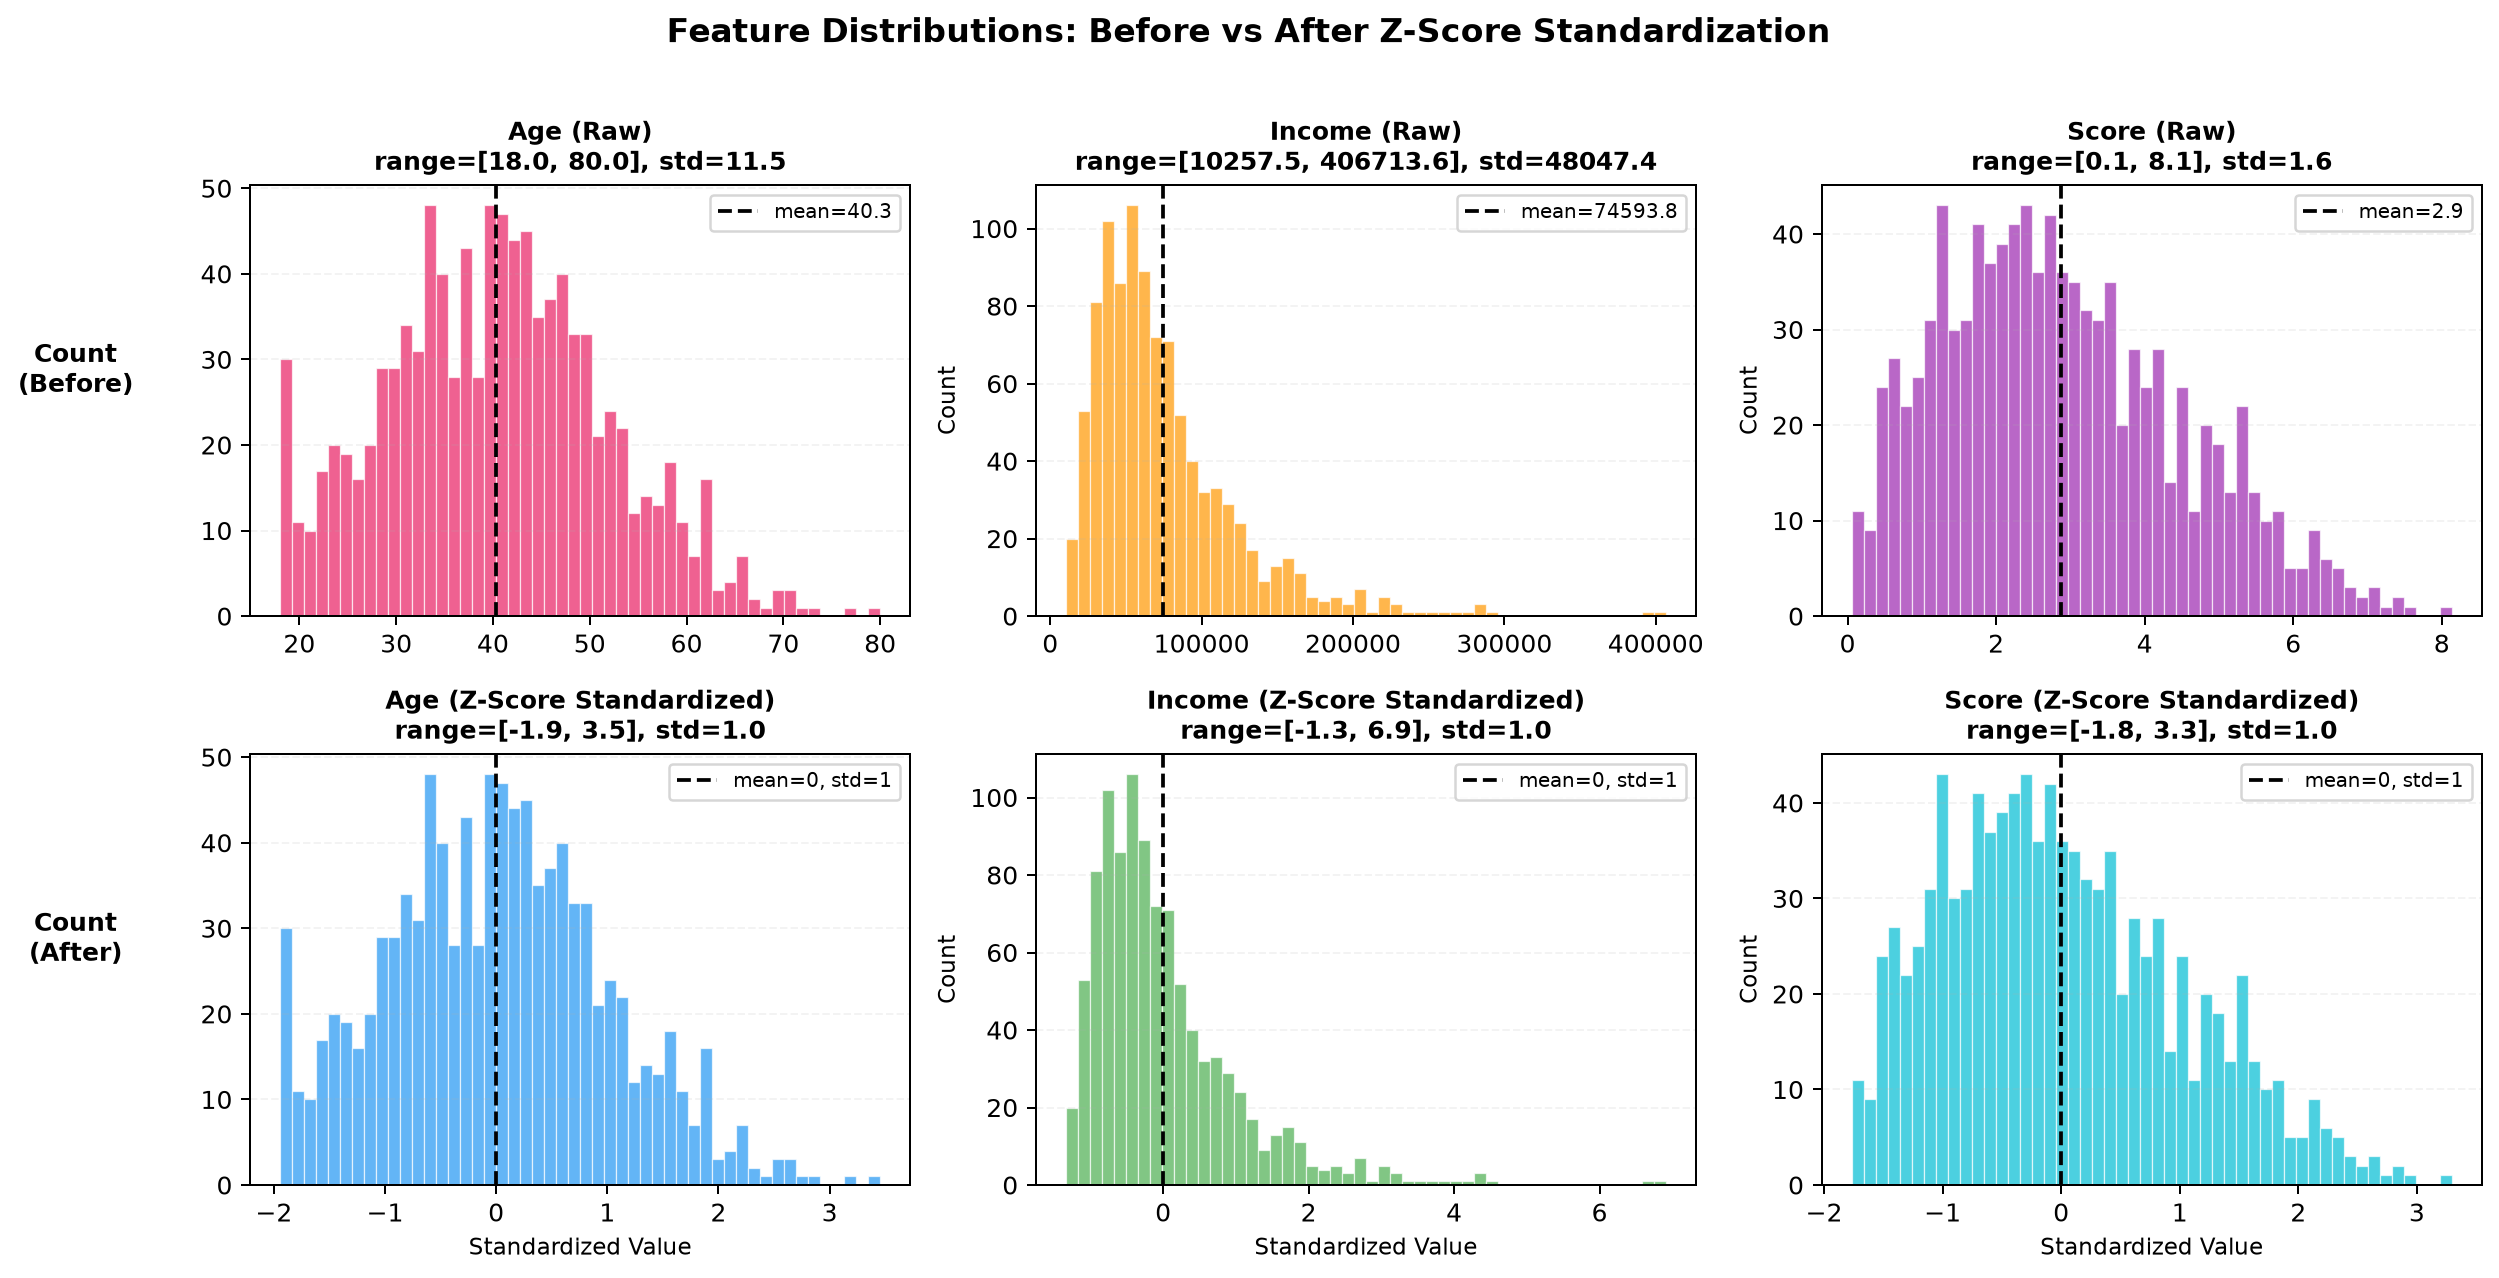
量纲如何影响 Hessian
Section titled “量纲如何影响 Hessian”考虑一个最简单的线性模型 ,均方误差损失。其 Hessian 矩阵恰好是特征协方差矩阵的 2 倍(加上正则化项):
如果 的量纲是 (如收入), 的量纲是 (如年龄),则 ,条件数极大。标准化后 ,条件数接近 1,收敛速度可提升数百倍。
数值型特征的缩放
Section titled “数值型特征的缩放”不同特征的量纲差异巨大(比如年龄 0–100,收入 0–1,000,000),会导致梯度下降收敛缓慢、距离度量失真。常见缩放方法:
Z-Score 标准化(Standardization)
Section titled “Z-Score 标准化(Standardization)”将特征变换为均值 0、标准差 1 的分布(即标准正态分布 ):
其中 和 是训练集上的均值和标准差。变换后 ,,但不保证落在 ——极端值仍可能超过 3 甚至更大。
为什么标准化对神经网络格外重要? 神经网络的每一层都是线性变换 + 非线性激活函数的组合。如果输入特征的量纲悬殊,第一层权重的梯度也会悬殊(因为 ),导致有些权重更新太快、有些几乎不动。Batch Normalization 和 Layer Normalization 本质上就是在网络内部自动做标准化,缓解这个问题。详见梯度下降与优化器。
适合场景:大多数机器学习算法,尤其是梯度下降优化的模型(神经网络、逻辑回归)和基于距离的算法(KNN、SVM)。详见梯度下降与优化器和SVM 支持向量机。
Min-Max 归一化(Normalization)
Section titled “Min-Max 归一化(Normalization)”将特征压缩到固定区间 (或任意 ):
若要映射到 :
变换后所有值严格落在 ,保留了原始分布形状。注意:新数据若超出 范围,缩放后会越界(clipping 到 0/1 是常见补救手段)。
适合场景:已知上下界的特征(如图像像素 0–255 归一化到 0–1)、不假设分布形状的场景,以及需要固定区间的神经网络激活函数(如 Sigmoid 的输入偏好 0 附近)。
Robust Scaler(鲁棒缩放)
Section titled “Robust Scaler(鲁棒缩放)”用中位数(Median,排序后处于中间位置的值)和四分位距(IQR, Interquartile Range,第 75 百分位与第 25 百分位之差)代替均值和标准差:
其中 分别是第 25、50、75 百分位数。由于中位数和 IQR 对极端值不敏感(即使最大值翻 100 倍, 也不变),这种方法对异常值(Outlier,偏离主体分布的极端数据点)稳健。
为什么中位数不受极端值影响? 设想一个村庄有 100 户人家,99 户年收入 10 万,1 户是亿万富翁年收入 10 亿。均值 万——被富翁拉高了 10 倍。但中位数仍然是第 50 名和第 51 名的平均值,即 10 万,完全不受那个极端值影响。这就是统计学中”鲁棒统计量”(Robust Statistics)的核心思想。
适合场景:数据中有大量离群点的场景,例如收入分布(少数亿万富翁拉高均值但拉不动中位数)。
Power Transform(幂变换)
Section titled “Power Transform(幂变换)”当数据严重偏斜(Skewed,即分布不对称,一侧拖着长尾)时,可以先做幂变换让它更接近正态分布,再做标准化:
- Box-Cox 变换(仅正数):
- Yeo-Johnson 变换(支持零和负数):
参数 通过最大似然估计(MLE)自动求解。具体做法是:对给定 ,计算变换后数据的对数似然(假设正态分布),然后优化 使对数似然最大化:
适合场景:线性模型、基于正态假设的统计检验,以及严重右偏的特征(如收入、交易额)。
Quantile Transform(分位数变换)
Section titled “Quantile Transform(分位数变换)”将特征映射到任意目标分布(通常选均匀分布 或标准正态分布 ):
其中 是经验累积分布函数(CDF), 是目标分布的分位数函数(逆 CDF)。直观理解:先算出 在数据中的百分位排名 (0 到 1),再找到标准正态分布中同样排名的值。
特点:
- 彻底消除异常值影响(无论多极端,排名总在 0 到 1 之间)。
- 强制输出分布为目标分布,对非线性模型(如随机森林)帮助不大,但对线性模型和距离度量有显著改善。
- 破坏了原始值的数值关系——两点之间的距离反映的是排名差,而非原始差异。
适合场景:分布形状未知或极度不规则的数据,以及线性模型场景。不适合树模型(树模型对单调变换不敏感)。
缩放方法选择速查
Section titled “缩放方法选择速查”| 方法 | 公式核心 | 对异常值 | 输出范围 | 典型场景 |
|---|---|---|---|---|
| Z-Score | 均值、标准差 | 敏感 | 不固定 | 神经网络、SVM、KNN |
| Min-Max | 最大最小值 | 极敏感 | 图像像素、已知边界 | |
| Robust | 中位数、IQR | 稳健 | 不固定 | 含离群点的数据 |
| Box-Cox | 幂函数 | 中等 | 不固定 | 偏斜分布趋近正态 |
| Quantile | 经验 CDF + 逆目标 CDF | 完全鲁棒 | 目标分布 | 极不规则分布 |
缺失值(Missing Value)在真实数据中无处不在——用户拒填问卷、传感器故障、日志丢失。处理策略取决于缺失机制(MCAR、MAR、MNAR,见下方术语表)和数据集特点。
三种缺失机制的严格定义
Section titled “三种缺失机制的严格定义”理解缺失机制对选择正确策略至关重要:
- MCAR(Missing Completely At Random):缺失概率与所有变量(已观测或未观测)均无关。例如数据采集设备随机故障。此时删除缺失行不会引入偏差。
- MAR(Missing At Random):缺失概率仅与已观测变量有关。例如年龄大的用户更可能拒填收入。只要模型中包含”年龄”这个变量,缺失就是可解释的。
- MNAR(Missing Not At Random):缺失概率与未观测值本身有关。例如高收入者更可能拒填收入。这是最难处理的情况,需要对缺失机制建模。
用数学语言描述,设 为缺失指示变量( 表示缺失), 为已观测部分, 为缺失部分:
删除法(Deletion)
Section titled “删除法(Deletion)”- 行删除(Listwise):直接删掉含有缺失值的整行。简单粗暴,适合缺失比例极低(低于 5%)的情况。
- 列删除:如果某列缺失超过 50%,通常直接删除该列——信息量太少,保留反而引入噪声。
- 成对删除(Pairwise):在计算协方差矩阵等统计量时,只用非缺失的配对。适合统计建模,但在机器学习中较少使用。
代价:删行会损失样本量,尤其当缺失分布不均匀时(比如某个重要特征缺失多的恰好是某类用户),会引入偏差。对于 MAR 和 MNAR 情况,直接删行会丢失信息并可能产生选择偏差(Selection Bias,即删除操作系统性偏向某一类样本)。
填充法(Simple Imputation)
Section titled “填充法(Simple Imputation)”| 特征类型 | 填充策略 | 说明 |
|---|---|---|
| 数值 | 均值 / 中位数 / 常数 | 中位数对异常值更稳健 |
| 类别 | 众数 / “Unknown” | 众数(Mode,出现频率最高的值) |
| 时间序列 | ffill / bfill / 线性插值 | ffill = 前向填充,取上一个已知值 |
线性插值的数学形式为:
其中 是缺失点前后的已知值。
均值填充的方差缩减效应:简单均值填充会人为降低特征方差,因为所有填充值都等于均值,不贡献波动。设原始特征有 个观测值和 个缺失值(用 填充),则填充后方差为:
这意味着均值填充让特征看起来比实际”更稳定”,可能误导后续的标准化和距离计算。更高级的插补方法(如 KNN、迭代插补)通过引入变化来缓解这个问题。
KNN 插补与模型预测填充
Section titled “KNN 插补与模型预测填充”- KNN Imputer:对每个缺失样本,找到特征空间中最近的 个完整样本,用它们的(加权)均值填充。公式为:
其中 是样本 的 近邻集合, 是距离, 是邻居 的第 个特征值。效果好但计算开销大( 距离计算)。
- 迭代插补(Iterative Imputer / MICE):将每个含缺失值的特征当作目标变量,用其他特征训练回归模型来预测。MICE(Multiple Imputation by Chained Equations)在多个迭代轮次中交替更新各特征的预测。
MICE 的算法流程:
- 初始化:对所有缺失值做简单填充(如均值),得到初始完整数据集 。
- 迭代(第 轮,):对每个含缺失值的特征 :
- 将 中已观测的部分作为训练集,其他特征作为输入,训练回归模型 。
- 用 预测 中缺失的部分,更新 。
- 收敛:重复迭代直到参数变化小于阈值。
- 多重插补:重复整个过程 次(每次加入随机噪声),得到 个完整数据集,分别建模后取平均——这能反映插补本身的不确定性。
异常值检测与处理
Section titled “异常值检测与处理”异常值(Outlier)是偏离主体分布的数据点,可能是录入错误、传感器故障,也可能是真实的罕见事件。异常值会严重扭曲均值、标准差等统计量,进而影响标准化效果。
- Z-Score 法:标记 的点为异常值(假设正态分布下,):
- 修正 Z-Score(MAD 法):用中位数和绝对中位差(MAD, Median Absolute Deviation)替代均值和标准差,更鲁棒:
常数 0.6745 是标准正态分布 分位数的倒数,使 在正态分布下与 可比。
- IQR 法(Boxplot 规则):标记超出 的点为异常值。
基于模型的方法
Section titled “基于模型的方法”- Isolation Forest(孤立森林):随机选择特征和分割值递归划分数据。异常点由于”稀少且不同”,平均只需要更少的划分次数就能被孤立。因此,从根到叶的路径长度越短,越可能是异常点。异常分数为:
其中 是样本 在所有树中的平均路径长度, 是二叉搜索树的平均路径长度(归一化因子)。 越接近 1 越可能是异常。
- DBSCAN 密度聚类:将数据点聚类,不属于任何簇的点标记为噪声/异常。详见无监督学习。
| 策略 | 适用场景 | 风险 |
|---|---|---|
| 直接删除 | 确认是录入错误 | 损失样本 |
| Winsorize(盖帽法) | 截断到分位数边界(如 1%/99%) | 改变真实值 |
| 对数变换 | 右偏分布的极端大值 | 仅适用于正值 |
| Robust Scaler | 保留但降低影响 | 不消除影响 |
| 单独标记 | 异常本身有预测意义 | 增加特征维度 |
关键决策:是”测量错误”还是”真实信号”?一个年收入 10 亿的用户可能是录入错误(多了一个零),也可能是真正的亿万富翁。这需要领域知识(Domain Knowledge)来判断——删除前务必检查原始数据来源。
类别特征编码
Section titled “类别特征编码”类别特征(Categorical Feature)是取值为离散标签的变量,如”城市""颜色""商品 ID”。模型只能处理数字,因此需要编码。
标签编码(Label Encoding)
Section titled “标签编码(Label Encoding)”把类别映射为整数:红色 = 0,绿色 = 1,蓝色 = 2。简单,但引入了虚假的数值大小关系(蓝色 = 2 比红色 = 0”大”,这在语义上毫无道理)。只适合树模型——树模型只看分裂阈值,不关心数值大小关系。
独热编码(One-Hot Encoding)
Section titled “独热编码(One-Hot Encoding)”为每个类别创建一个二值列。设类别有 种取值,则独热编码将每个样本映射为一个 维向量,只有对应位置为 1,其余为 0:
其中 是第 个标准基向量。优点:不引入虚假大小关系。缺点: 很大时(高基数,High Cardinality)会产生极度稀疏的高维矩阵——维度灾难(Curse of Dimensionality,高维空间中数据变得稀疏,距离失效),此时应考虑其他方案。详见特征工程。
独热编码与虚拟变量陷阱:当 个独热列加上截距项(bias)时,存在完全共线性(Perfect Multicollinearity)—— 列之和恒为 1,与截距项线性相关。这会导致矩阵 不可逆。解决方案是去掉一列(使用 个虚拟变量),称为”dummy encoding”。sklearn 的 OneHotEncoder(drop='first') 可自动实现。
目标编码(Target Encoding)
Section titled “目标编码(Target Encoding)”用该类别对应的目标变量均值来替代类别标签:
其中 是类别 的样本数, 是全局目标均值, 是平滑系数(Bayesian Smoothing,用先验拉低小样本类别的估计)。当 很小时, 接近全局均值 ,避免过拟合。
平滑系数的贝叶斯解释:这个公式本质上是 Beta-Binomial 模型(二分类)的后验均值。假设目标变量 服从伯努利分布(二分类),类别 的真实概率 有 Beta 先验 。观测到 个样本中 个正例后,后验为:
后验均值(即目标编码值)正是上式 。 越大,先验越强,对小样本类别的收缩越明显。
关键陷阱:如果用全量数据(含验证集)计算目标均值,相当于信息泄露。正确做法是用 K-fold 交叉验证:对每一折,只用训练折的标签计算编码,再应用到验证折。
其他高级编码方法
Section titled “其他高级编码方法”- Binary Encoding(二进制编码):先将类别映射为整数,再转为二进制,用各位作为独立特征。将 个类别压缩为 个特征,比 One-Hot 省空间,适合中高基数。
- Frequency Encoding(频率编码):用类别出现的频率替代标签。简单有效,假设”常见类别”和”罕见类别”有不同的预测力。
- Hash Encoding(哈希编码):用哈希函数将类别映射到固定维度的向量。不需要维护词表,适合在线学习和流式数据,但存在哈希冲突(不同类别映射到同一位置)。
- Leave-One-Out Encoding(留一编码):目标编码的变体,计算每个样本的编码时排除自身的目标值,进一步降低过拟合风险。
嵌入编码(Embedding)
Section titled “嵌入编码(Embedding)”将类别映射为低维稠密向量(Embedding,即一组可学习的实数参数)。这是深度学习处理高基数类别(如用户 ID、商品 ID)的标准方法,也是推荐系统和 NLP 的核心思路:
其中 是嵌入矩阵, 是嵌入维度(通常远小于 )。嵌入向量在模型训练中通过反向传播学习,自动捕捉类别间的语义关系。
嵌入维度的经验法则: 通常取 左右。太低会丢失信息,太高会过拟合且增加参数量。详见NLP 基础和句子嵌入。
特征变换与构造
Section titled “特征变换与构造”分箱(Binning / Discretization)
Section titled “分箱(Binning / Discretization)”将连续变量切分成若干区间,转为类别。例如年龄 → “青年/中年/老年”。适合线性模型捕捉非线性关系,也提升模型可解释性。常见策略:
- 等宽分箱:区间等长,
- 等频分箱:每箱样本数相等,按分位数切分
- 决策树分箱:用树模型自动找最优切分点
决策树分箱的原理是:训练一棵浅层决策树(如 DecisionTreeClassifier(max_depth=3)),树的叶节点自然形成分箱边界——这些边界是信息增益最大的切分点,比人为指定更有意义。
对数变换(Log Transform)
Section titled “对数变换(Log Transform)”对右偏数据(长尾在右侧)取对数可以”压缩”尾部:
这在处理收入、点击量、词频等”少数极大值”特征时极为有效,能让分布更接近正态,改善线性模型表现。
数学直觉:对数函数 的导数 ,即对大值的压缩程度更大。 从 10 到 100 差 90,但 ; 从 1000 到 1100 差 100,但 。这种”边际递减”效应恰好中和了右偏分布的”长尾”。
多项式特征(Polynomial Features)
Section titled “多项式特征(Polynomial Features)”对线性模型,可以显式构造非线性项:
这让线性模型能拟合非线性决策边界,代价是维度升高、过拟合风险增加,需配合正则化。详见正则化。
对于 个原始特征和 次多项式,生成后的特征数为 ,随 和 增长极快(例如 时产生 286 个特征)。因此多项式特征通常只用于特征数很少()的场景。
交互特征(Interaction Features)
Section titled “交互特征(Interaction Features)”手动构造特征间的交互项 、“比率”特征 、“差值”特征 等。这在领域知识丰富时非常有效——例如”单价 = 总价 / 面积”比单独的总价和面积更有预测力。
文本与图像预处理
Section titled “文本与图像预处理”文本预处理流水线
Section titled “文本预处理流水线”原始文本 → 分词(Tokenize) → 去停用词 → 词干化/词形还原 → 向量化- 分词(Tokenization):将句子切分成 Token(词或子词)。现代方法用 Subword 分词(BPE、WordPiece),能处理未登录词(OOV)。
- 去停用词(Stop Words Removal):去掉”的、是、the、a”等高频无信息量的词。注意:深度学习时代很多模型(如 BERT)不去停用词,因为注意力机制能自己学会忽略它们。
- 向量化:TF-IDF(词频-逆文档频率)或词嵌入(Word2Vec / BERT Embedding)。
TF-IDF 的公式为:
其中 是词 在文档 中的出现次数, 是文档总数, 是包含词 的文档数。TF 衡量词在单篇文档中的重要性,IDF 衡量词的全局区分度——出现在所有文档中的词(如”的”)IDF 接近 0,几乎不贡献信息。
BPE(Byte-Pair Encoding)分词的原理:从字符级别开始,迭代地合并出现频率最高的相邻字符对(byte pair),直到达到预设的词表大小。例如:
初始词表:l, o, w, e, r, n, ...频率最高的对:"l"+"o" → "lo" 加入词表下一步:频率最高的对可能是 "lo"+"w" → "low" 加入词表这样”lowering”会被分为 ["low", "er", "ing"] 而非 <UNK>(未登录词)。BPE 是 GPT 系列和大多数 LLM 的标准分词方法。
详见NLP 基础。
图像预处理流水线
Section titled “图像预处理流水线”原始图像 → 缩放到统一尺寸 → 归一化像素值 → 数据增强(训练时) → 送入模型- 归一化:除以 255 映射到 ,或用 ImageNet 均值方差做 Z-Score:
其中 (RGB 三通道均值),。
为什么用 ImageNet 的均值方差? 如果你的模型使用在 ImageNet 上预训练的权重(如 ResNet、ViT),输入分布应该与预训练时一致。否则,第一层卷积会遭遇分布偏移(Distribution Shift),需要更长微调才能恢复性能。如果你的模型从头训练,可以用自己数据集的统计量。
- 数据增强:翻转、裁剪、色彩抖动、MixUp 等。数据增强不是静态预处理——它在训练中动态生成,属于训练策略。详见数据增强。
预处理流水线全景
Section titled “预处理流水线全景”缩放方法的效果对比
Section titled “缩放方法的效果对比”标准化如何改善优化
Section titled “标准化如何改善优化”scikit-learn 预处理流水线
Section titled “scikit-learn 预处理流水线”import numpy as npimport pandas as pdfrom sklearn.preprocessing import StandardScaler, OneHotEncoder, RobustScalerfrom sklearn.impute import SimpleImputer, KNNImputerfrom sklearn.compose import ColumnTransformerfrom sklearn.pipeline import Pipelinefrom sklearn.linear_model import LogisticRegressionfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_score
# 模拟一份混合类型数据data = pd.DataFrame({ "age": [25, 30, np.nan, 45, 35, 50, 28, 40, 33, 38], "income":[50000, 80000, 60000, np.nan, 75000, 120000, 45000, 95000, 62000, 88000], "city": ["北京", "上海", "北京", "广州", "上海", "北京", "广州", "上海", "广州", "北京"], "label": [0, 1, 0, 1, 1, 1, 0, 1, 0, 1],})num_cols = ["age", "income"]cat_cols = ["city"]
# 数值列:中位数填充 + Z-Score 标准化num_pipe = Pipeline([ ("impute", SimpleImputer(strategy="median")), ("scale", StandardScaler()),])# 类别列:众数填充 + One-Hot 编码cat_pipe = Pipeline([ ("impute", SimpleImputer(strategy="most_frequent")), ("onehot", OneHotEncoder(handle_unknown="ignore")),])pre = ColumnTransformer([("num", num_pipe, num_cols), ("cat", cat_pipe, cat_cols)])# 整合为完整流水线:预处理 + 模型model = Pipeline([("pre", pre), ("clf", LogisticRegression())])
X_train, X_test, y_train, y_test = train_test_split( data.drop("label", axis=1), data["label"], test_size=0.3, random_state=42)model.fit(X_train, y_train)pred = model.predict(X_test)print(f"准确率: {accuracy_score(y_test, pred):.2%}")print("预测:", model.predict(data.drop("label", axis=1)[:2]))关键:Pipeline 自动保证”只在训练集上 fit,在测试集上 transform”,杜绝数据泄露。
numpy 手写 Z-Score、Min-Max 与 Robust Scaler
Section titled “numpy 手写 Z-Score、Min-Max 与 Robust Scaler”import numpy as np
x = np.array([10, 20, 30, 40, 50], dtype=float) # 原始数据
# Z-Score 标准化:均值 0,标准差 1z = (x - x.mean()) / x.std()print("Z-Score:", z.round(3)) # 均值≈0, 标准差≈1
# Min-Max 归一化:范围 [0, 1]m = (x - x.min()) / (x.max() - x.min())print("Min-Max:", m.round(3)) # 范围 0-1
# Robust Scaler(用中位数和四分位距)median, q1, q3 = np.median(x), np.percentile(x, 25), np.percentile(x, 75)r = (x - median) / (q3 - q1)print("Robust:", r.round(3))
# 验证标准化后均值和标准差print(f"标准化后: 均值={z.mean():.6f}, 标准差={z.std():.6f}")
# 加入一个异常值,看各方法的差异x_outlier = np.append(x, [10000])z_out = (x_outlier - x_outlier.mean()) / x_outlier.std()r_out = (x_outlier - np.median(x_outlier)) / (np.percentile(x_outlier, 75) - np.percentile(x_outlier, 25))print(f"\n加入异常值 10000 后:")print(f" Z-Score: {z_out.round(3)} ← 均值和标准差被异常值严重扭曲")print(f" Robust: {r_out.round(3)} ← 中位数和 IQR 几乎不受影响")Power Transform 与 Quantile Transform 的效果对比
Section titled “Power Transform 与 Quantile Transform 的效果对比”import numpy as npfrom sklearn.preprocessing import PowerTransformer, QuantileTransformer
# 生成严重右偏的对数正态分布数据np.random.seed(42)x = np.random.lognormal(mean=2, sigma=1.5, size=(1000, 1))print(f"原始数据: 偏度={float(np.mean(((x - x.mean())/x.std())**3)):.3f}, " f"范围=[{x.min():.1f}, {x.max():.1f}]")
# Box-Cox 变换bc = PowerTransformer(method="box-cox", standardize=True)x_bc = bc.fit_transform(x)print(f"Box-Cox: 偏度={float(np.mean(((x_bc - x_bc.mean())/x_bc.std())**3)):.3f}, " f"范围=[{x_bc.min():.2f}, {x_bc.max():.2f}]")print(f" 最优 lambda = {bc.lambdas_[0]:.3f}")
# Yeo-Johnson 变换(支持负数)yj = PowerTransformer(method="yeo-johnson", standardize=True)x_yj = yj.fit_transform(x)print(f"Yeo-Johnson: 偏度={float(np.mean(((x_yj - x_yj.mean())/x_yj.std())**3)):.3f}")
# Quantile Transform → 强制正态分布qt = QuantileTransformer(output_distribution="normal", n_quantiles=100)x_qt = qt.fit_transform(x)print(f"Quantile: 偏度={float(np.mean(((x_qt - x_qt.mean())/x_qt.std())**3)):.3f} ← 最接近正态")异常值检测实战
Section titled “异常值检测实战”import numpy as npfrom sklearn.ensemble import IsolationForestfrom scipy import stats
np.random.seed(42)# 正常数据 + 5% 异常值x_normal = np.random.normal(50, 10, 200)x_outliers = np.array([200, -50, 300, 500, 0]) # 人造异常x_all = np.concatenate([x_normal, x_outliers]).reshape(-1, 1)
# 方法 1: Z-Score 法z_scores = np.abs(stats.zscore(x_all.flatten()))z_outliers = np.where(z_scores > 3)[0]print(f"Z-Score 法: 检测到 {len(z_outliers)} 个异常值, 索引={z_outliers}")
# 方法 2: 修正 Z-Score(MAD 法)median = np.median(x_all)mad = np.median(np.abs(x_all.flatten() - median))mod_z = 0.6745 * (x_all.flatten() - median) / madmad_outliers = np.where(np.abs(mod_z) > 3.5)[0]print(f"MAD 法: 检测到 {len(mad_outliers)} 个异常值, 索引={mad_outliers}")
# 方法 3: Isolation Forestiso = IsolationForest(contamination=0.025, random_state=42)labels = iso.fit_predict(x_all)iso_outliers = np.where(labels == -1)[0]print(f"IsoForest: 检测到 {len(iso_outliers)} 个异常值, 索引={iso_outliers}")PyTorch 图像预处理与自定义归一化
Section titled “PyTorch 图像预处理与自定义归一化”import torchimport torchvision.transforms as Tfrom PIL import Image
# 标准 ImageNet 预处理流水线transform = T.Compose([ T.Resize(256), # 短边缩放到 256 T.CenterCrop(224), # 中心裁剪 224×224 T.ToTensor(), # 转张量,自动除以 255 → [0,1] T.Normalize( # 用 ImageNet 均值方差标准化 mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225], ),])
img = Image.open("example.jpg")x = transform(img).unsqueeze(0) # 增加 batch 维度 → [1, 3, 224, 224]print(f"输入张量形状: {x.shape}")print(f"像素值范围: [{x.min():.3f}, {x.max():.3f}]")PyTorch 自定义 Batch 归一化(用于表格数据)
Section titled “PyTorch 自定义 Batch 归一化(用于表格数据)”import torchimport torch.nn as nn
class TabularPreprocessor(nn.Module): """可训练的数值特征标准化层(在模型内部完成预处理)。 适合特征量纲未知或在线学习的场景。""" def __init__(self, n_features: int): super().__init__() # 学习仿射变换参数,而非固定统计量 self.bn = nn.BatchNorm1d(n_features)
def forward(self, x: torch.Tensor) -> torch.Tensor: return self.bn(x)
# 用法x = torch.randn(32, 10) # batch=32, 10 个数值特征prep = TabularPreprocessor(10)x_scaled = prep(x)print(f"输出均值: {x_scaled.mean(dim=0).round(decimals=3)}")print(f"输出标准差: {x_scaled.std(dim=0).round(decimals=3)}")PyTorch Embedding 编码高基数类别
Section titled “PyTorch Embedding 编码高基数类别”import torchimport torch.nn as nn
# 模拟推荐系统场景:10 万个商品 IDn_items = 100_000embed_dim = 32 # 嵌入维度
# Embedding 层本质上是一个可查找的查找表embedding = nn.Embedding(num_embeddings=n_items, embedding_dim=embed_dim)
# 初始化方式(影响训练收敛速度)nn.init.normal_(embedding.weight, mean=0, std=0.01) # 小随机值初始化
# 输入一批商品 ID,获取对应的嵌入向量item_ids = torch.tensor([0, 42, 999, 50000]) # 4 个商品 IDitem_embeddings = embedding(item_ids) # → [4, 32]
print(f"商品 ID: {item_ids}")print(f"嵌入矩阵形状: {embedding.weight.shape}") # [100000, 32]print(f"输出嵌入形状: {item_embeddings.shape}") # [4, 32]print(f"参数总量: {embedding.weight.numel():,}") # 3,200,000
# 嵌入向量会随模型训练自动学习,语义相近的商品会获得相近的向量实战案例:从原始数据到模型训练
Section titled “实战案例:从原始数据到模型训练”下面是一个完整的端到端案例,模拟金融风控场景——预测用户是否会违约:
import numpy as npimport pandas as pdfrom sklearn.preprocessing import StandardScaler, OneHotEncoderfrom sklearn.impute import SimpleImputerfrom sklearn.compose import ColumnTransformerfrom sklearn.pipeline import Pipelinefrom sklearn.ensemble import IsolationForestfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import roc_auc_score, classification_report
# ---- 1. 构造模拟数据 ----np.random.seed(42)n = 2000data = pd.DataFrame({    "age": np.random.randint(18, 70, n),    "income": np.random.lognormal(10.5, 0.8, n).astype(int),  # 右偏收入    "debt_ratio": np.random.beta(2, 5, n),                     # 0-1 之间    "num_loans": np.random.poisson(2, n),    "employment": np.random.choice(["employed", "self-employed", "unemployed"], n),    "default": np.random.binomial(1, 0.15, n),})
# 人为注入缺失值和异常值data.loc[data.sample(frac=0.05).index, "income"] = np.nandata.loc[data.sample(frac=0.03).index, "age"] = np.nandata.loc[data.sample(frac=0.02).index, "income"] = 9999999  # 异常值
print("=== 数据概况 ===")print(f"样本数: {len(data)}, 缺失率:\n{data.isnull().mean().round(3)}")print(f"\n收入分布(含异常值):\n{data['income'].describe()}")
# ---- 2. 预处理流水线 ----num_cols = ["age", "income", "debt_ratio", "num_loans"]cat_cols = ["employment"]
num_pipe = Pipeline([    ("impute", SimpleImputer(strategy="median")),    ("scale", StandardScaler()),])cat_pipe = Pipeline([    ("impute", SimpleImputer(strategy="most_frequent")),    ("onehot", OneHotEncoder(handle_unknown="ignore")),])
preprocessor = ColumnTransformer([    ("num", num_pipe, num_cols),    ("cat", cat_pipe, cat_cols),])
full_pipeline = Pipeline([    ("preprocess", preprocessor),    ("clf", LogisticRegression(class_weight="balanced", max_iter=1000)),])
# ---- 3. 训练与评估 ----from sklearn.model_selection import train_test_splitX_train, X_test, y_train, y_test = train_test_split(    data.drop("default", axis=1), data["default"], test_size=0.2, random_state=42)
full_pipeline.fit(X_train, y_train)y_pred = full_pipeline.predict(X_test)y_proba = full_pipeline.predict_proba(X_test)[:, 1]
print(f"\n=== 评估结果 ===")print(f"AUC: {roc_auc_score(y_test, y_proba):.4f}")print(classification_report(y_test, y_pred, target_names=["正常", "违约"]))
# ---- 4. 持久化预处理参数(部署必备) ----import joblibjoblib.dump(full_pipeline, "risk_model.pkl")# 部署时: model = joblib.load("risk_model.pkl"); model.predict(new_data)工程要点:上面的 Pipeline 将预处理和模型封装为一个对象。部署时只需加载一个
.pkl文件,新数据经过完全相同的变换,保证训练-推理一致性。
- 永远只在训练集上 fit,在验证/测试集上 transform:标准化参数(均值、标准差、最大最小值)必须从训练集计算,然后直接应用到验证和测试集。如果在全量数据上 fit,等于让模型偷看了测试集的统计信息(数据泄露,Data Leakage),评估结果会过于乐观。
- 用 Pipeline 封装:把预处理和模型串联成 scikit-learn Pipeline,既避免数据泄露,又方便整体持久化和部署。
- 树模型不需要缩放:随机森林、XGBoost 等树模型基于分裂阈值,对特征量纲不敏感。但梯度提升树(如 LightGBM 的直方图优化)在某些实现中对缺失值有原生支持,不需要预处理填充。详见集成学习。
- 高基数类别警惕 One-Hot:用户 ID、商品 ID 这种几万个取值的类别,One-Hot 后维度爆炸。应使用 Target Encoding 或 Embedding。
- 异常值检测在缩放之前:先识别和处理异常值,否则 Z-Score 的均值和标准差会被异常值带偏,标准化效果大打折扣。
- 数据增强不是预处理:数据增强是在训练中动态生成的,不属于静态预处理流水线,但图像缩放和归一化属于预处理。详见数据增强。
- 保留映射器以便部署:生产环境中,新数据必须用训练时保存的 Scaler / Encoder 做相同变换。务必用
joblib.dump(scaler)序列化并随模型一起部署。 - 数值稳定性:当 极小或某列方差为 0(常数列)时,Z-Score 会除零。实践中应检查并移除常数列,或给 加一个极小的 。
- 注意缺失值的语义:缺失有时本身包含信息(“用户拒绝填写收入”可能本身预测性强)。可以额外加一个布尔列
is_missing记录缺失与否,再对原始列做填充。 - 监控数据漂移(Data Drift):上线后定期检查新数据的分布是否与训练集一致。如果收入分布突然变了(例如经济危机导致整体收入下降),用旧均值标准化的结果会失真,需要重新校准。
- 表格数据建模:金融风控、广告 CTR(Click-Through Rate,点击率)预测中,混合数值/类别特征的表格数据是主要形态,预处理流水线直接影响 AUC。详见监督学习。
- 推荐系统:用户 ID 和商品 ID 是典型高基数类别,用 Embedding 编码是标配。详见推荐系统。
- 图像分类:ImageNet 均值方差标准化 + 随机裁剪翻转增强是标准配方。详见CNN 卷积神经网络。
- NLP 文本分类:BERT 分词器做 Subword 分词 + 词表映射,是现代 NLP 预处理的标准。详见NLP 基础。
- 时间序列预测:前向填充缺失值 + 差分去趋势 + 滑动窗口构建特征。详见时间序列分析。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| scikit-learn.preprocessing | Python | 标准化、归一化、编码、分箱等全套预处理工具 |
| scikit-learn.impute | Python | SimpleImputer、KNNImputer、IterativeImputer 等缺失值填充器 |
| scikit-learn.pipeline | Python | Pipeline 和 ColumnTransformer,串联预处理与模型 |
| pandas | Python | DataFrame 数据清洗、缺失值处理、类型转换 |
| category_encoders | Python | 专门做类别编码的库:Target、Binary、Hash 编码等 |
| torchvision.transforms | Python | PyTorch 图像预处理与数据增强 |
| transformers tokenizer | Python | HuggingFace 文本分词与编码(BERT、GPT 等分词器) |
| feature-engine | Python | 基于 pandas 的特征工程库,API 更贴近数据科学工作流 |
| cleanlab | Python | 自动检测标签错误和样本质量问题 |
| great_expectations | Python | 数据质量验证框架,定义数据”期望”并自动检查 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 标准化 | Standardization / Z-Score | 将特征变换为均值 0、标准差 1 的分布,适合梯度下降和距离度量 |
| 归一化 | Normalization / Min-Max | 将特征压缩到固定区间(通常 ),保留原始分布形状 |
| 鲁棒缩放 | Robust Scaler | 用中位数和四分位距缩放,对异常值不敏感 |
| 幂变换 | Power Transform | Box-Cox / Yeo-Johnson,将偏斜分布变换为近似正态 |
| 分位数变换 | Quantile Transform | 用经验 CDF 将特征映射到目标分布(正态或均匀) |
| 独热编码 | One-Hot Encoding | 为每个类别值创建一个二值列,适合低基数类别特征 |
| 目标编码 | Target Encoding | 用类别对应的目标变量均值替代类别标签,信息密度高但易过拟合 |
| 嵌入编码 | Embedding | 将类别映射为低维稠密向量,深度学习处理高基数类别的标准方法 |
| 缺失值插补 | Imputation | 用统计量(均值/中位数/众数)或模型预测来填充缺失值 |
| 数据泄露 | Data Leakage | 预处理时无意中引入了测试集信息,导致评估结果虚高 |
| 条件数 | Condition Number | Hessian 矩阵最大与最小特征值之比,越大梯度下降收敛越慢 |
| MCAR | Missing Completely At Random | 缺失与任何变量完全无关,删行无偏 |
| MAR | Missing At Random | 缺失仅与已观测变量有关,合适插补可无偏 |
| MNAR | Missing Not At Random | 缺失与未观测值本身有关,最难处理 |
| 异常值 | Outlier | 偏离主体分布的极端数据点,可能是错误或真实罕见事件 |
| 绝对中位差 | MAD (Median Absolute Deviation) | 各点与中位数之绝对偏差的中位数,鲁棒的离散度度量 |
| 维度灾难 | Curse of Dimensionality | 随维度增加,数据在高维空间变得稀疏,距离和密度估计失效 |
- scikit-learn 官方文档 - Preprocessing data:最权威的预处理工具参考,每种方法的数学定义和代码示例都有,是日常查阅的首选。
- Kuhn & Johnson,「Applied Predictive Modeling」(2013):第 3 章系统讲解预处理策略,从工程实践角度讨论何时用哪种方法。
- Zheng & Casari,「Feature Engineering for Machine Learning」(2018):深入讲解类别编码、缺失值处理、特征缩放的实战技巧。
- Hadley Wickham,「Tidy Data」(2014):数据清洗的经典论文,定义了”整洁数据”的标准格式,是数据预处理的理论基础。
- category_encoders 库文档:对比了十几种类别编码方法(One-Hot、Target、Hash、Leave-One-Out 等)的适用场景和优缺点。
- van Buuren,「Flexible Imputation of Missing Data」(2nd ed., 2018):MICE 多重插补的权威教材,开源免费。
- Leo Breiman,「Isolation Forest」(2008):孤立森林原始论文,异常值检测的经典方法。
最新进展(2025–2026)
Section titled “最新进展(2025–2026)”以下趋势基于截至 2026 年中的技术进展整理,部分具体数字请查阅最新论文核实。
1. LLM 时代改变了文本预处理的范式
Section titled “1. LLM 时代改变了文本预处理的范式”在 ChatGPT 之后,文本预处理从”分词 + TF-IDF”大规模转向”直接交给大模型”。主流趋势:
- Tokenization 内置于模型:BPE(Byte-Pair Encoding)和 SentencePiece 已经成为所有主流 LLM 的标准分词方案。开发者不再手动分词,而是直接调用
tokenizer(text)。2025 年 GPT-4o 系列和 Claude 3.5/4 的分词器压缩率进一步提升,同等文本消耗的 Token 数更少,直接降低了推理成本。详见HuggingFace 快速上手。 - Embedding 即预处理:传统 NLP 流水线中的”去停用词 → 词干化 → TF-IDF”正在被 Sentence Embedding(如 BGE-M3、E5-Mistral、OpenAI
text-embedding-3-large)取代。2025 年的嵌入模型在 MTEB 排行榜上全面突破,支持多语言、多粒度(稠密+稀疏+ColBERT 三路输出),一段文本直接编码为一个稠密向量,下游任务用向量检索或简单分类器即可。详见句子嵌入。 - 结构化数据的 LLM 编码:2024–2025 年的研究(如 TabLLM、Table-to-Text、ElasticTabular)探索将表格数据”文本化”后喂给 LLM,让大模型直接做分类或推理,绕过传统预处理流水线。但在精度上仍不及 XGBoost 等专用模型,目前主要用于零样本(Zero-shot)场景和快速原型验证。
2. 表格基础模型(Tabular Foundation Models)
Section titled “2. 表格基础模型(Tabular Foundation Models)”2025–2026 年最重要的趋势之一是”表格基础模型”的兴起——用大规模表格数据预训练的通用模型,推理时零样本泛化,不需要传统预处理流水线:
- TabPFN v2(2025):在数百万合成表格数据上预训练的 Transformer 模型,对小到中等规模(<10K 样本)的分类任务,不做任何预处理即可达到甚至超越 XGBoost + AutoML 的效果。
- TabICL、CartBoost 等跟进工作探索不同的表格预训练范式。
- 影响:如果这一方向成熟,传统表格预处理流水线(缩放、编码、缺失值处理)的大部分工作可能被”直接喂给表格基础模型”取代,正如 LLM 取代了传统 NLP 流水线一样。
3. 自动机器学习(AutoML)中的预处理自动化
Section titled “3. 自动机器学习(AutoML)中的预处理自动化”2025 年的主流 AutoML 框架(如 AutoGluon 1.x、H2O Driverless AI、Google Vertex AI AutoML)已经将预处理选择自动化:
- 自动类型推断:根据列的统计分布自动判断是数值、类别还是文本。AutoGluon 用启发式规则结合试探性建模来决定列类型。
- 自动编码选择:根据类别基数和目标相关性,自动在 One-Hot、Target Encoding、Embedding 间选择。
- 自动缺失值策略:基于缺失率和模型类型,自动在删除/填充/KNN 插补间决策。
- 神经架构搜索(NAS)联合预处理:一些研究将预处理参数(如分箱数量、嵌入维度)与模型架构一起纳入搜索空间。
4. 大模型训练数据的预处理流水线
Section titled “4. 大模型训练数据的预处理流水线”训练 LLM 本身的预处理流水线也在快速进化,数据工程已成为模型质量的核心瓶颈:
- Deduplication(去重)成为核心步骤:研究(如 Lee et al. 2022 的”Deduplicating Training Data Makes Language Models Better”)表明,训练数据去重显著提升模型泛化能力、降低记忆效应。2025 年的主流做法是 MinHash + LSH 近似去重,结合精确去重。Common Crawl 级别的去重需要分布式计算(如 Spark)。
- 数据过滤与质量评分:Common Crawl 等网络爬取数据需要经过严格的质量过滤。2025 年的主流方法用小模型(如 fasttext 分类器、判别式质量模型、甚至用 LLM 自身给数据打分)给每条数据打分,保留高质量子集。这就形成了一个”鸡生蛋”循环——好模型用来过滤数据,好数据又训练出更好的模型。DeepSeek 和 Llama 3 系列的技术报告都披露了详细的数据过滤策略。
- 分词器优化:多语言 LLM(如 Qwen2.5/3、Llama 3/4)的分词器覆盖上百种语言,词表大小从 3 万扩展到 25 万+。2025 年的研究表明,压缩率(Compression Ratio,每 Token 对应的字符数)对训练成本有显著影响——压缩率提升 10% 意味着同等文本的 Token 数减少 10%,直接节省 10% 的训练和推理算力。
- 合成数据(Synthetic Data)在预处理中的角色:2025–2026 年,用强模型(如 GPT-4、Claude)生成高质量合成数据来扩充训练集已成为标准操作。但合成数据本身也需要预处理——去重、质量过滤、检测”模型坍塌”(Model Collapse,即合成数据训练的模型逐渐退化)。
5. 隐私保护下的预处理
Section titled “5. 隐私保护下的预处理”- 差分隐私(Differential Privacy, DP)预处理:在标准化、编码等步骤中加入噪声,使预处理输出不泄露个体信息。2025 年 DP-SGD 训练流程中,预处理阶段的隐私预算分配成为研究热点。差分隐私标准化的形式为:
其中 是各统计量的灵敏度(Sensitivity,加入/移除一条数据对统计量的最大影响), 由隐私预算 决定。
- 联邦学习中的预处理对齐:各客户端数据分布不同(Non-IID),标准化参数无法集中计算。联邦标准化(如 FedAvg 的变体)用局部统计量近似全局参数。一种安全聚合方案是各客户端只上传局部均值和计数,服务器聚合后再分发全局统计量。
6. 多模态预处理统一
Section titled “6. 多模态预处理统一”随着 GPT-4o、Gemini 2.0、Claude 3.5 Sonnet 等多模态模型的兴起,预处理流水线正在从”单模态各自处理”走向”统一嵌入空间”:
- 文本 → Token Embedding
- 图像 → Vision Transformer(ViT)Patch Embedding:图像被切分为固定大小的 Patch(如 16×16),每个 Patch 经线性投影为一个向量,处理方式与文本 Token 完全一致
- 音频 → Mel 频谱图 → 1D Conv 或 Audio Encoder
- 视频 → 采样关键帧 → 每帧按图像处理 → 时间维度 Attention
- 所有模态的输出投影到统一的隐藏维度后拼接
这意味着传统意义上”各模态独立的预处理流水线”正在被端到端模型吸收,预处理与模型架构的边界越来越模糊。
7. 实时数据预处理与流式机器学习
Section titled “7. 实时数据预处理与流式机器学习”随着在线学习和实时推理需求的增长,2025–2026 年的预处理正在向”流式”演进:
- 在线标准化(Online Standardization):用 Welford 算法(Welford’s Online Algorithm)逐样本更新均值和方差,无需存储全部历史数据:
其中 即第 步的方差。这使得在数据流(如实时推荐、在线广告竞价)中也能做标准化。
- 概念漂移(Concept Drift)自适应:当数据分布随时间变化(如用户行为季节性变化、突发事件),用滑动窗口或指数衰减来更新预处理统计量,而非固定使用训练时的值。
- 特征存储(Feature Store):如 Feast、Tecton 等特征存储平台将预处理逻辑与模型解耦,保证训练和推理时使用一致的特征定义。
展望:随着基础模型(Foundation Model)和 Token-based 统一接口的普及,“手动预处理”在越来越多的场景中被”预处理已内置于模型”取代。但对于表格数据、时间序列、以及需要精细控制和可解释性的工业场景,理解本文所述的经典预处理方法仍然不可或缺。