
直方图比较
本教程中你将学到如何:
- 使用函数 cv::compareHist 得到一个数值参数,用以表示两幅直方图相互匹配的程度。
- 使用不同的度量来比较直方图
- 要比较两幅直方图( 与 ),首先我们要选择一个度量(),用以表示两幅直方图匹配的程度。
- OpenCV 实现了函数 cv::compareHist 来执行比较。它还提供了 6 种不同的度量来计算匹配度:
- 相关(Correlation,cv::HISTCMP_CORREL)
$$d(H_1,H_2) = \frac{\sum_I (H_1(I) - \bar{H_1}) (H_2(I) - \bar{H_2})}{\sqrt{\sum_I(H_1(I) - \bar{H_1})^2 \sum_I(H_2(I) - \bar{H_2})^2}}$$其中$$\bar{H_k} = \frac{1}{N} \sum _J H_k(J)$$为直方图 bin 的总数。
1. **卡方(Chi-Square,cv::HISTCMP_CHISQR)**$$d(H_1,H_2) = \sum _I \frac{\left(H_1(I)-H_2(I)\right)^2}{H_1(I)}$$1. **交集(Intersection,cv::HISTCMP_INTERSECT)**$$d(H_1,H_2) = \sum _I \min (H_1(I), H_2(I))$$1. **巴塔查里雅距离(Bhattacharyya distance,cv::HISTCMP_BHATTACHARYYA)**$$d(H_1,H_2) = \sqrt{1 - \frac{1}{\sqrt{\bar{H_1} \bar{H_2} N^2}} \sum_I \sqrt{H_1(I) \cdot H_2(I)}}$$1. **替代卡方(Alternative Chi-Square,cv::HISTCMP_CHISQR_ALT)**$$d(H_1,H_2) = 2 * \sum _I \frac{\left(H_1(I)-H_2(I)\right)^2}{H_1(I)+H_2(I)}$$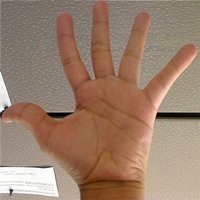
1. **Kullback-Leibler 散度(Kullback-Leibler divergence,cv::HISTCMP_KL_DIV)**$$d(H_1,H_2) = \sum _I H_1(I) \log \left(\frac{H_1(I)}{H_2(I)}\right)$$-
这个程序做什么?
- 载入一幅基准图像与 2 幅要与它比较的测试图像。
- 生成 1 幅取自基准图像下半部分的图像
- 将这些图像转换为 HSV 格式
- 为所有图像计算 H-S 直方图,并对它们进行归一化以便比较。
- 将基准图像的直方图分别与那 2 幅测试直方图、基准图像下半部分图像的直方图,以及基准图像自身的直方图进行比较。
- 显示得到的数值匹配参数。
-
可下载代码:点击 这里
-
代码一览: 代码见下方示例
-
可下载代码:点击 这里
-
代码一览: 代码见下方示例
-
可下载代码:点击 这里
-
代码一览: 代码见下方示例
-
载入基准图像(src_base)及另外两幅测试图像:
-
将它们转换为 HSV 格式:
-
同时,创建一幅取自基准图像下半部分的图像(HSV 格式):
-
初始化用于计算直方图的参数(bin、范围以及通道 H 与 S)。
-
为基准图像、2 幅测试图像以及基准图像的下半部分图像计算直方图:
-
依次在基准图像直方图(hist_base)与其余直方图之间应用 6 种比较方法:
-
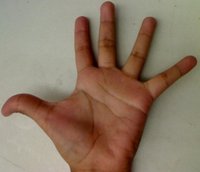
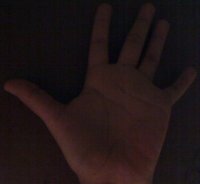
我们使用以下图像作为输入:
其中第一幅是基准(用来与其他图像比较),另外 2 幅是测试图像。我们还会把第一幅图像分别与它自身,以及与基准图像的下半部分图像进行比较。
-
当我们将基准图像直方图与它自身比较时,应当期望得到完美匹配。此外,与基准图像下半部分直方图相比时,由于两者来自同一来源,也应当呈现较高的匹配度。对于另外两幅测试图像,可以观察到它们的光照条件差异很大,因此匹配度不应太好:
-
以下是我们用 OpenCV 4.12.0 得到的数值结果:
方法 基准 - 基准 基准 - 下半 基准 - 测试 1 基准 - 测试 2 相关 1.000000 0.880438 0.20457 0.065752 卡方 0.000000 0.328307 181.674 80.1494 交集 1.000000 0.75005 0.315061 0.0908022 巴塔查里雅 0.000000 0.237866 0.679825 0.873709 替代卡方 0.000000 0.395046 2.31572 3.41024 KL 散度 0.000000 0.321064 2.6616 9.55412 对于相关与交集方法,度量值越高,匹配越准确。可以看到,正如预期,基准-基准的匹配度在所有结果中最高。还可以观察到,基准-下半是第二好的匹配(正如我们所预测)。对于其余四种度量,结果越小,匹配越好。