
数据库与中间件
本页聚焦 AI 系统的数据层与消息基础设施——从关系型数据库到向量数据库,从缓存中间件到消息队列,这些组件构成了 AI 应用的”地基”。如果说模型是发动机,那么数据层就是燃料供给系统:再强的模型,没有高效的数据存取与流转,也无法在生产环境中稳定运行。
本页是 AI 后端开发 的姊妹篇——后者关注”如何把模型封装成服务”,本页关注”服务背后的数据如何存储、缓存、检索和流转”。两者合在一起,才是一个完整的 AI 工程数据栈。
一句话总结: 关系型数据库管”结构化业务数据”,Redis 管”热数据缓存”,MongoDB 管”灵活的非结构化元数据”,Milvus 管”向量相似度搜索”,Kafka/RabbitMQ 管”异步消息流”,MQTT 管”IoT 设备通信”——每个组件解决一个特定瓶颈。
AI 工程中的数据栈可以用一条流水线来理解:
- 写入路径:数据先进入消息队列,由 worker 异步消费,写入各类数据库。
- 读取路径:API 服务优先查 Redis 缓存,缓存未命中再查数据库。
- AI 推理路径:用户 query 先 embedding,再在向量数据库中做 ANN 搜索,取回相关上下文交给 LLM。
关系型数据库:MySQL 与 PostgreSQL
Section titled “关系型数据库:MySQL 与 PostgreSQL”关系型数据库(RDBMS, Relational Database Management System)是所有后端系统的基石。AI 工程中,用户账户、模型元数据、训练日志、业务流水等结构化数据几乎都存在这里。
B+ 树索引原理
Section titled “B+ 树索引原理”MySQL 的 InnoDB 引擎和 PostgreSQL 默认都使用 B+ 树(B+ Tree) 作为索引结构。理解 B+ 树,才能理解为什么索引能加速查询、以及什么时候索引会失效。
B+ 树结构示意(3 阶):
           [10 | 20]                ← 根节点(内部节点)          /    |    \   [1|3|7] [10|12|15] [20|25|28]     ← 叶子节点(存储实际数据指针)     ↔        ↔          ↔           ← 叶子节点之间用双向链表连接
B+ 树的关键特征:
- 所有数据都在叶子节点:内部节点只存索引键(用于路由),不存实际数据。这让每个内部节点能容纳更多键,从而降低树的高度。
- 叶子节点形成有序链表:范围查询(如
WHERE id BETWEEN 100 AND 200)只需定位到起点,然后沿链表顺序扫描即可。 - 树高通常 3–4 层:3 层 B+ 树可索引数十亿条记录,任意一次查找只需 3–4 次磁盘 I/O。
为什么不用二叉树? 二叉查找树(BST)高度为 ,对于 10 亿条记录约需 30 层——每层一次磁盘 I/O,30 次随机 I/O 在机械硬盘上约需 300ms,完全不可接受。B+ 树通过多路分支(一个节点存几百个键),将高度压缩到 3–4 层,I/O 次数降到常数级。
B+ 树查询的时间复杂度:
其中 为树的阶数(每个节点的最大子节点数), 为记录总数。由于 通常为数百,即使 达到 , 也只有 3–4。
查询优化:EXPLAIN ANALYZE
Section titled “查询优化:EXPLAIN ANALYZE”在 PostgreSQL 中,EXPLAIN ANALYZE 不仅显示查询计划,还会实际执行并报告每一步的耗时:
-- 查看查询计划 + 实际执行时间EXPLAIN ANALYZESELECT u.name, COUNT(m.id) AS model_countFROM users uJOIN models m ON m.user_id = u.idWHERE u.created_at > '2025-01-01'GROUP BY u.nameORDER BY model_count DESCLIMIT 10;
-- 典型输出:-- Limit  (cost=50.12..50.15 rows=10 width=32) (actual time=3.2..3.25 rows=10 loops=1)--   -> Sort  (cost=50.12..52.50 rows=950 width=32) (actual time=3.1..3.15 rows=50 loops=1)--         Sort Key: (count(m.id)) DESC--         -> Hash Join  (cost=5.00..40.00 rows=950 width=32) (actual time=0.5..2.8 rows=950 loops=1)--               Hash Cond: (m.user_id = u.id)--               -> Seq Scan on models m  (actual time=0.1..1.2 rows=2000 loops=1)--               -> Hash  (actual time=0.3..0.3 rows=500 loops=1)--                     -> Index Scan using idx_users_created on users u  (actual time=0.05..0.2 rows=500 loops=1)--                             Index Cond: (created_at > '2025-01-01')
关键看 Seq Scan(全表扫描,慢)vs Index Scan(索引扫描,快)。如果一张大表出现了 Seq Scan,通常意味着缺少索引或索引失效。
连接池:PgBouncer
Section titled “连接池:PgBouncer”每个数据库连接都会占用内存(PostgreSQL 中每个连接 fork 一个进程,约 5–10MB)。如果每个 API 请求都新建连接,连接数会迅速耗尽。
PgBouncer 是 PostgreSQL 的轻量级连接池中间件,它维护一组到数据库的持久连接,API 应用连接 PgBouncer 而非直连数据库:
# pgbouncer.ini 核心配置[databases]mydb = host=127.0.0.1 port=5432 dbname=aidb
[pgbouncer]listen_addr = 0.0.0.0listen_port = 6432pool_mode = transaction ; 事务级池化:一个事务结束后连接可被复用max_client_conn = 1000 ; 允许 1000 个客户端连接default_pool_size = 25 ; 但只对数据库维护 25 个后端连接池化模式:
session(会话级,最保守)、transaction(事务级,推荐)、statement(语句级,限制最多——不能用 prepared statements)。
ACID 事务
Section titled “ACID 事务”ACID 是关系型数据库事务的四大保证:
| 属性 | 全称 | 含义 | 举例 |
|---|---|---|---|
| A | Atomicity(原子性) | 事务内操作要么全部成功,要么全部回滚 | 转账时扣款和加款必须同时成功或同时失败 |
| C | Consistency(一致性) | 事务执行前后,数据库必须满足所有约束 | 外键、唯一约束、CHECK 约束不被违反 |
| I | Isolation(隔离性) | 并发事务之间互不干扰 | 两人同时抢同一商品,不能超卖 |
| D | Durability(持久性) | 事务提交后,数据不会因宕机丢失 | WAL(Write-Ahead Log)保证刷盘 |
PostgreSQL 的隔离级别:
-- 查看当前隔离级别SHOW transaction_isolation;-- 默认: read committed(读已提交)
-- AI 场景中常用 read committed 即可;-- 需要防止"不可重复读"时用 repeatable read;-- 极端一致性场景用 serializable(性能开销大)
PostgreSQL pgvector 扩展
Section titled “PostgreSQL pgvector 扩展”PostgreSQL 通过 pgvector 扩展可以直接存储和检索向量,适合中小规模(百万级以下 embedding)的场景,省去单独部署向量数据库的运维成本:
-- 安装扩展CREATE EXTENSION IF NOT EXISTS vector;
-- 创建带向量列的表CREATE TABLE documents (    id BIGSERIAL PRIMARY KEY,    content TEXT,    embedding VECTOR(1536)  -- OpenAI text-embedding-ada-002 维度);
-- 创建 HNSW 索引加速相似度搜索CREATE INDEX ON documents USING hnsw (embedding vector_cosine_ops);
-- 余弦相似度搜索(找最相关的文档)SELECT id, content, 1 - (embedding <=> $1::vector) AS similarityFROM documentsORDER BY embedding <=> $1::vectorLIMIT 10;-- <=> 是余弦距离运算符;<-> 是 L2 距离;<#> 是负内积
pgvector vs 专用向量数据库:百万级以下用 pgvector 足矣(运维简单、可与业务数据 JOIN);千万级以上 embedding 需要专用向量数据库(如 Milvus、Qdrant),后者在 ANN 索引构建和分布式检索上有显著优势。
Redis:缓存、会话与消息
Section titled “Redis:缓存、会话与消息”Redis(Remote Dictionary Server)是内存键值数据库,单线程 + 事件驱动,读写延迟通常在亚毫秒级。在 AI 工程中,它的三大用途:缓存热数据、管理用户会话、pub/sub 消息广播。
常用数据类型
Section titled “常用数据类型”| 类型 | 说明 | 典型 AI 场景 |
|---|---|---|
| String | 最基本类型,存字符串/数字/序列化数据 | 缓存 LLM 响应结果、API 限流计数器 |
| Hash | 字段-值映射,类似 Python dict | 存储用户会话信息(user_id → name, role, expire) |
| List | 有序列表,两端可推入/弹出 | 任务队列(轻量替代 RabbitMQ)、推理结果缓冲 |
| Set | 无序集合,自动去重 | 标签管理、在线用户列表 |
| ZSet | 有序集合,按 score 排序 | 排行榜、按时间戳排序的最近活动流 |
import redisimport json
r = redis.Redis(host='localhost', port=6379, db=0, decode_responses=True)
# ---- String: 缓存 LLM 响应 ----r.setex("llm:response:abc123", 3600, " Paris is the capital of France.")  # TTL 1小时cached = r.get("llm:response:abc123")  # 缓存命中时直接返回,无需再调 LLM API
# ---- Hash: 用户会话 ----r.hset("session:user:42", mapping={    "username": "alice",    "role": "admin",    "api_quota": "1000",})r.expire("session:user:42", 1800)  # 30 分钟过期session = r.hgetall("session:user:42")
# ---- ZSet: 最近推理记录(按时间戳排序)----r.zadd("user:42:history", {"summarize_task_001": 1700000000})recent = r.zrevrange("user:42:history", 0, 9, withscores=True)  # 最近 10 条
# ---- List: 轻量任务队列 ----r.lpush("inference_queue", json.dumps({"model": "gpt-4o", "prompt": "Hello"}))task = r.brpop("inference_queue", timeout=30)  # 阻塞式弹出,等待 30s
缓存三大问题
Section titled “缓存三大问题”缓存穿透(Cache Penetration):大量请求查询不存在的 key,缓存和数据库都没有,每次都打到数据库。解决方案:对查询结果为空的 key 也缓存空值(短 TTL),或用 布隆过滤器(Bloom Filter) 提前拦截。
缓存击穿(Cache Breakdown):某个热点 key 过期瞬间,大量并发请求同时打到数据库。解决方案:用互斥锁(
SETNX)只让一个请求查数据库并回填缓存,其他请求等待。
缓存雪崩(Cache Avalanche):大量 key 同时过期,数据库瞬间过载。解决方案:给 TTL 加随机偏移(如
ttl = base_ttl + random(0, 300)),避免集中过期。
TTL 过期策略
Section titled “TTL 过期策略”Redis 的 key 过期采用两种策略结合:
- 惰性删除(Lazy Expiration):访问 key 时才检查是否过期——优点是 CPU 友好,缺点是冷数据长期占内存。
- 定期删除(Active Expiration):Redis 每秒执行 10 次采样,随机抽取部分设置了 TTL 的 key 检查过期——配合惰性删除,兼顾 CPU 和内存。
当内存达到 maxmemory 上限时,触发淘汰策略(Eviction Policy):
| 策略 | 行为 |
|---|---|
noeviction | 拒绝写入,返回错误(默认) |
allkeys-lru | 从所有 key 中淘汰最久未使用的(推荐缓存场景) |
volatile-lru | 仅从设了 TTL 的 key 中淘汰 LU |
allkeys-lfu | 淘汰使用频率最低的(Redis 4.0+) |
MongoDB:文档数据库
Section titled “MongoDB:文档数据库”MongoDB 是文档型数据库,数据以 BSON(Binary JSON) 格式存储,每条记录是一个灵活的文档。AI 工程中,它特别适合存储非结构化或半结构化元数据——比如训练配置、模型 artifact 描述、prompt 模板等。
// 一条 MongoDB 文档示例:模型训练记录{ "_id": ObjectId("65a1b2c3..."), "model_name": "resnet50-finetune", "experiment_id": "exp_20250115_003", "config": { "backbone": "resnet50", "learning_rate": 0.001, "batch_size": 64, "augmentation": ["flip", "rotate", "color_jitter"] }, "metrics": { "val_accuracy": 0.942, "val_loss": 0.183, "best_epoch": 47 }, "tags": ["classification", "finetune", "resnet"], "created_at": ISODate("2025-01-15T10:30:00Z")}无 Schema(Schema-less)的灵活性:MongoDB 不要求所有文档有相同的字段。第一条记录可以有
config.augmentation,第二条可以没有——这在快速迭代的 AI 实验中非常实用,因为实验配置经常变。但”无 Schema”不等于”不需要设计”,合理的字段规划和索引仍然是性能的关键。
与关系型数据库的对比
Section titled “与关系型数据库的对比”| 特性 | 关系型数据库(MySQL/PostgreSQL) | MongoDB |
|---|---|---|
| 数据模型 | 表 + 行(严格 Schema) | 集合 + 文档(灵活 Schema) |
| 关联查询 | 强大的 JOIN | 弱化 JOIN,鼓励嵌套文档 |
| 事务 | 完整 ACID(4.0 起多文档事务) | 多文档事务支持(4.0+),性能开销较大 |
| 扩展方式 | 主要垂直扩展(scale-up) | 原生支持水平分片(sharding) |
| 适合场景 | 强一致性业务逻辑、复杂关联 | 快速迭代、非结构化数据、日志 |
| AI 典型用途 | 用户/订单/计费 | 实验记录、模型元数据、prompt 日志 |
Milvus:向量数据库
Section titled “Milvus:向量数据库”当 embedding 规模达到千万甚至亿级时,传统数据库的精确搜索(逐条比较距离)完全无法满足延迟要求。向量数据库(Vector Database)通过 ANN(Approximate Nearest Neighbor,近似最近邻) 算法,用微小的精度损失换取数量级的速度提升。
Milvus 是目前最流行的开源向量数据库,专为十亿级向量的相似度搜索设计。
ANN 搜索原理
Section titled “ANN 搜索原理”给定一个 query 向量 ,目标是在 个向量中找到 top- 个最相似的——即距离 最近的 个向量。精确搜索(Flat / Brute Force)需要计算 次距离,( 为向量维度),十亿级数据完全不可行。
ANN 的核心思路:通过预先构建索引,将搜索空间大幅缩小,只对一小部分候选向量做精确距离计算,从而在”几乎不损失精度”的情况下实现亚秒级搜索。
精度 vs 速度的权衡:ANN 返回的结果是”大概率正确的 top-”,衡量指标是 Recall@——即返回的 个结果中有多少是真正的 top-。工业实践中,Recall@10 ≥ 95% 通常已足够。
索引类型对比
Section titled “索引类型对比”Milvus 支持多种 ANN 索引,核心三种的对比:
| 索引类型 | 原理 | 内存占用 | 查询速度 | Recall | 适用场景 |
|---|---|---|---|---|---|
| IVF_FLAT | 先聚类分桶(K-Means),搜索时只扫部分桶 | 高(存原始向量) | 中 | 高 | 中等数据量、追求高精度 |
| IVF_SQ8 | IVF + 标量量化(32-bit float → 8-bit int) | 低(压缩 4 倍) | 快 | 中 | 内存受限、大规模数据 |
| HNSW | 分层小世界图(Hierarchical Navigable Small World) | 很高(存图结构) | 最快 | 最高 | 低延迟、高精度(推荐首选) |
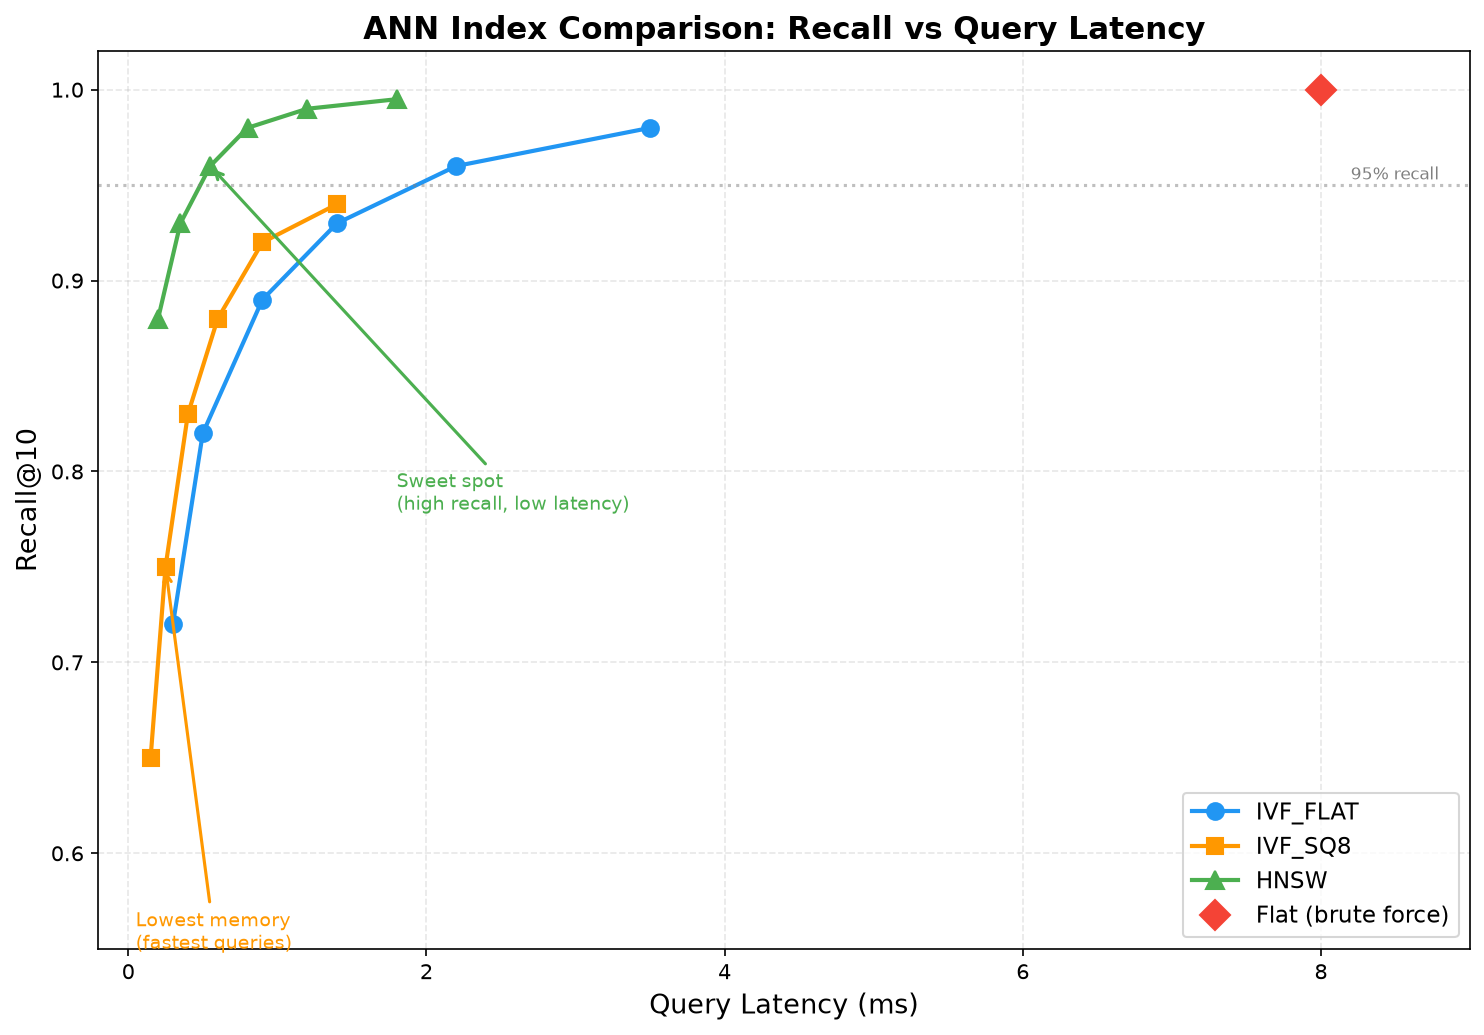
上图展示了三种索引在不同参数设置下的 Recall@10 与查询延迟关系。可以看到 HNSW 在低延迟区间的 Recall 优势最为明显——这也是为什么它逐渐成为向量数据库的默认索引。
from pymilvus import MilvusClient
# 连接 Milvusclient = MilvusClient(uri="http://localhost:19530")
# 1. 创建 Collection(类似数据库中的"表")client.create_collection(    collection_name="documents",    dimension=1536,  # 向量维度(必须与 embedding 模型一致))
# 2. 插入向量 + 元数据data = [    {"id": 1, "vector": [0.1, 0.2, ...], "text": "Transformer 架构介绍", "category": "deep-learning"},    {"id": 2, "vector": [0.3, 0.1, ...], "text": "扩散模型原理", "category": "generative-ai"},]client.insert(collection_name="documents", data=data)
# 3. ANN 搜索results = client.search(    collection_name="documents",    data=[[0.15, 0.18, ...]],  # query embedding    limit=10,                   # top-k    output_fields=["text", "category"],    search_params={"metric_type": "COSINE", "params": {"nprobe": 10}},)
# 4. 标量过滤(混合搜索:向量相似度 + 元数据过滤)results = client.search( collection_name="documents", data=[query_embedding], filter='category == "deep-learning"', # 只在深度学习类别中搜索 limit=5,)- Collection:类似关系数据库的表,包含 schema(字段定义)和 index(索引)。
- Schema:定义字段——至少一个向量字段(
FloatVector)和可选的标量字段(int, varchar 等)。 - Index:建在向量字段上,决定 ANN 算法类型。一个 collection 可建多个索引。
- Partition:Collection 的物理分区,可实现”按分区搜索”,减少扫描范围。
与 RAG 的配合:在 RAG(Retrieval-Augmented Generation)系统中,Milvus 负责存储和检索知识库的 embedding。用户提问 → embedding → Milvus ANN 搜索 → 取回 top-k 相关文档 → 拼入 prompt 交给 LLM。详见 LangChain 与 RAG。
Kafka:高吞吐消息队列
Section titled “Kafka:高吞吐消息队列”Kafka 是分布式流处理平台,最初由 LinkedIn 开发,现已成为大数据和 AI 基础设施的事实标准。它的核心设计目标是超高吞吐(单集群百万消息/秒)和持久化存储。
- Topic(主题):消息的逻辑分类,如
model-logs、inference-requests。 - Partition(分区):Topic 物理拆分为多个分区,分区是并行度的单位——一个消费者组内,每个分区只能被一个消费者消费,因此分区数 = 最大并行消费者数。
- Consumer Group(消费者组):同组内消费者分担负载(每个分一个分区),不同组各自独立消费全量消息。
- Offset(偏移量):每条消息在分区内的序号,消费者通过提交 offset 来记录消费进度。
为什么 Kafka 这么快? 三个关键设计:(1) 顺序写磁盘——消息追加到分区日志末尾,顺序 I/O 速度接近内存;(2) 零拷贝(Zero-copy)——数据从页缓存直接经网卡发出,不经过用户态;(3) 批量压缩——消息批量发送,减少网络往返。
from kafka import KafkaProducer, KafkaConsumerimport json
# ---- Producer: 发送推理日志 ----producer = KafkaProducer(    bootstrap_servers=['localhost:9092'],    value_serializer=lambda v: json.dumps(v).encode('utf-8'),    acks='all',  # 等待所有副本确认,最高可靠性)
# 发送消息producer.send('inference-logs', {    'model': 'yolov8',    'image_id': 'img_001',    'latency_ms': 42,    'num_objects': 7,})producer.flush()
# ---- Consumer: 消费并处理 ----consumer = KafkaConsumer(    'inference-logs',    bootstrap_servers=['localhost:9092'],    group_id='monitoring-service',    auto_offset_reset='latest',      # 只消费启动后的新消息    enable_auto_commit=True,          # 自动提交 offset    value_deserializer=lambda x: json.loads(x.decode('utf-8')),)
for message in consumer:    log = message.value    print(f"[{message.partition}:{message.offset}] {log['model']} "          f"latency={log['latency_ms']}ms")
典型 AI 场景:推理请求日志收集 → Kafka → Flink/Spark Streaming 做实时统计 → 写入 ClickHouse 供监控面板查询。这种”日志收集管道”是 AI 监控系统的标准架构。
RabbitMQ:任务队列
Section titled “RabbitMQ:任务队列”RabbitMQ 是基于 AMQP(Advanced Message Queuing Protocol) 协议的消息代理,与 Kafka 的”日志流”理念不同,它更侧重于任务分发和工作队列——消息被消费后即从队列删除。
Exchange / Queue / Binding 模型
Section titled “Exchange / Queue / Binding 模型”- Exchange(交换机):接收生产者的消息,根据 binding(绑定规则) 路由到一个或多个队列。
- Exchange 类型:
direct(精确匹配 routing key)、fanout(广播到所有绑定队列)、topic(通配符匹配)。 - Queue(队列):存储消息,等待消费者处理。
- Binding(绑定):Exchange 和 Queue 之间的路由规则。
Worker 模式与 Celery
Section titled “Worker 模式与 Celery”Python 生态中,Celery 是最流行的分布式任务队列框架,通常搭配 RabbitMQ 作为 broker:
# tasks.py — 定义异步任务from celery import Celery
app = Celery('ai_tasks', broker='pyamqp://localhost//')
@app.task(bind=True, max_retries=3)def run_inference(self, image_url, model_name):    """异步推理任务:下载图片 → 模型推理 → 返回结果"""    try:        image = download_image(image_url)        result = model.predict(image)        return {"objects": result, "model": model_name}    except Exception as exc:        # 失败自动重试,最多 3 次        raise self.retry(exc=exc, countdown=60)
# 调用方(API 服务中)from tasks import run_inferenceresult = run_inference.delay("https://example.com/img.jpg", "yolov8")# result.id 可用于后续轮询结果
Kafka vs RabbitMQ 选型
Section titled “Kafka vs RabbitMQ 选型”| 维度 | Kafka | RabbitMQ |
|---|---|---|
| 设计理念 | 日志流(消息持久保留) | 任务队列(消息消费即删除) |
| 吞吐量 | 极高(百万/秒) | 中等(万/秒) |
| 消息顺序 | 分区内严格有序 | 单队列内 FIFO |
| 消息保留 | 按 retention 策略保留(可数天) | 消费后即删除 |
| 消费模型 | 拉取(pull),可回放旧消息 | 推送(push),不可回放 |
| 典型 AI 场景 | 日志收集、事件溯源、实时流处理 | 异步推理任务、邮件通知、批处理 |
经验法则:需要”消息洪流”和高吞吐 → Kafka;需要”可靠的任务分发”和复杂路由 → RabbitMQ。
MQTT:IoT 轻量通信
Section titled “MQTT:IoT 轻量通信”MQTT(Message Queuing Telemetry Transport) 是为物联网设计的轻量级发布/订阅协议——协议头仅 2 字节,适合网络带宽有限、设备资源受限的场景。
- Broker:消息中转服务器(如 Mosquitto,开源轻量 MQTT broker)。
- Topic(主题):层级化的消息地址,如
factory/line1/temperature。 - 通配符:
+匹配单层(factory/+/temp),#匹配多层(factory/#)。
QoS 服务质量等级
Section titled “QoS 服务质量等级”| QoS 级别 | 交付保证 | 握手次数 | 适用场景 |
|---|---|---|---|
| QoS 0 | 至多一次(fire and forget) | 1 次 | 高频低价值数据(温度采样) |
| QoS 1 | 至少一次(可能重复) | 2 次 | 一般业务数据(设备状态) |
| QoS 2 | 恰好一次(无重复) | 4 次 | 关键数据(计费、控制指令) |
import paho.mqtt.client as mqtt
def on_connect(client, userdata, flags, rc):    print(f"Connected with result code {rc}")    client.subscribe("factory/line1/#", qos=1)
def on_message(client, userdata, msg):    print(f"Topic: {msg.topic} | Payload: {msg.payload.decode()}")
client = mqtt.Client()client.on_connect = on_connectclient.on_message = on_message
client.connect("localhost", 1883, 60)client.loop_forever()
在工业 AI 场景中,MQTT 是工厂设备数据采集的标准协议。详见 工业通信协议,那里深入讨论了 Modbus、OPC UA 等工业协议与 MQTT 的集成方式。
数据库选型决策树
Section titled “数据库选型决策树”面对一个 AI 项目的数据需求,如何选择合适的数据存储?以下决策树可作为参考:
连接池是第一道防线。无论是
psycopg2连 PostgreSQL、redis-py连 Redis、还是pymilvus连 Milvus,生产环境中必须使用连接池。每次请求新建连接的 TCP 握手开销,在 QPS 高时会成为瓶颈。
给所有缓存设 TTL。Redis 中没有 TTL 的 key 是”永久居民”——它们会一直占用内存,最终触发 OOM。养成习惯:
SETEX优先于SET,或SET ... EX一步到位。
向量数据库的索引需要调参。HNSW 的
efConstruction(建索引时)和efSearch(查询时)是关键参数:efConstruction越大索引质量越高但构建越慢;efSearch越大 Recall 越高但延迟增加。建议在自己的数据集上做 Recall-latency 曲线,找到最佳平衡点。
Kafka 分区数不要过多。分区数 = 最大并行消费者数,但每个分区都有副本和元数据开销。经验值:分区数 ≈ 预期消费者数的 1–3 倍,单集群不超过数千分区。
MongoDB 的索引和关系型一样重要。“无 Schema”容易被误以为”不需要设计索引”,但 MongoDB 的查询如果没命中索引,同样会触发全集合扫描(
COLLSCAN),在百万级文档上会非常慢。
2025–2026 最新进展
Section titled “2025–2026 最新进展”向量数据库的融合与标准化
Section titled “向量数据库的融合与标准化”2025 年,向量数据库领域出现了两个显著趋势:
- PostgreSQL pgvector 性能大幅提升:pgvector 0.7+ 引入了并行 HNSW 构建(利用多核 CPU),构建速度提升 5–10 倍,使 pgvector 在千万级向量场景下也变得可行。
- 向量数据库标准化接口:多家厂商(Milvus、Qdrant、Weaviate、Pinecone)逐步趋同于统一的 API 模式(collection → index → search),降低了切换成本。
Redis 向量搜索能力增强
Section titled “Redis 向量搜索能力增强”Redis Stack(原 RediSearch 模块)在 2025 年持续增强向量搜索功能,支持 HNSW 和 Flat 两种索引。对于已经在用 Redis 做缓存的项目,可以零成本增加向量搜索——不需要再部署独立的向量数据库。这使得 Redis 在小型 RAG 系统中成为有竞争力的”一体化”方案。
Kafka 的 AI 管道角色
Section titled “Kafka 的 AI 管道角色”随着实时 AI 推理需求增长,Kafka 在 特征平台(Feature Store) 中扮演越来越核心的角色:在线特征通过 Kafka 低延迟推送给推理服务,离线特征通过 Kafka 批量同步到训练管道。2025 年,Confluent 等厂商推出了 “AI Native” 消息管道产品,内置 schema registry 与 feature store 集成。
DuckDB 的崛起
Section titled “DuckDB 的崛起”DuckDB(嵌入式分析数据库)在 AI 数据工程中快速崛起——它像 SQLite 一样轻量(无需 server),但支持列式存储和向量化执行,单机分析数 GB 数据只需秒级。许多 AI 团队开始用 DuckDB 替代 Pandas 做大规模数据分析,因为它不需要把所有数据加载到内存。
| 术语 | 英文 | 说明 |
|---|---|---|
| 关系型数据库 | RDBMS (Relational Database Management System) | 基于关系模型(表)的数据库,支持 SQL 和 ACID 事务 |
| B+ 树 | B+ Tree | 多路平衡搜索树,所有数据在叶子节点,叶子间有链表,适合磁盘存储 |
| ACID | Atomicity, Consistency, Isolation, Durability | 事务四大特性:原子性、一致性、隔离性、持久性 |
| 连接池 | Connection Pool | 预创建一组数据库连接复用,避免频繁建连的开销 |
| 向量数据库 | Vector Database | 专为高维向量相似度搜索优化的数据库 |
| 近似最近邻 | ANN (Approximate Nearest Neighbor) | 用近似算法加速最近邻搜索,以微小精度损失换取大幅提速 |
| HNSW | Hierarchical Navigable Small World | 分层导航小世界图索引,当前最优的 ANN 算法之一 |
| 倒排文件 | IVF (Inverted File) | 先聚类分桶再在桶内搜索的 ANN 方法 |
| 标量量化 | Scalar Quantization (SQ8) | 将 32-bit 浮点向量压缩为 8-bit 整数,减少内存占用 |
| 文档数据库 | Document Database | 以灵活文档(如 BSON/JSON)为存储单元的数据库 |
| 发布/订阅 | Pub/Sub (Publish/Subscribe) | 消息模式:发布者发消息到频道,订阅者从频道收消息 |
| 消费者组 | Consumer Group | Kafka 中共享消费进度的消费者集合,组内分区分摊 |
| 消息队列 | Message Queue / Broker | 异步消息中间件,解耦生产者和消费者 |
| 交换机 | Exchange (AMQP) | RabbitMQ 中接收消息并按规则路由到队列的组件 |
| 服务质量等级 | QoS (Quality of Service) | MQTT 的消息交付可靠性等级,分 0/1/2 三级 |
| 布隆过滤器 | Bloom Filter | 空间高效的概率数据结构,用于判断元素是否在集合中(可能有假阳性) |
| 缓存击穿 | Cache Breakdown | 热点 key 过期瞬间大量请求直达数据库 |
| 缓存雪崩 | Cache Avalanche | 大量 key 同时过期导致数据库过载 |
| 特征平台 | Feature Store | 统一管理 ML 特征的存储与服务系统 |
- AI 后端开发 — 本页姊妹篇:如何把模型封装为 API 服务
- Python 工程进阶 — 数据库操作的 Python 侧最佳实践
- LangChain 与 RAG — Milvus 向量数据库在 RAG 系统中的实战应用
- 工业通信协议 — MQTT 与工业协议(Modbus、OPC UA)的深度集成
- MLOps — 数据管道在机器学习运维中的角色
- PostgreSQL 官方文档 — EXPLAIN、索引、事务的权威参考
- Milvus 官方文档 — 向量索引类型与性能调优指南
- Redis 官方文档 — 数据类型、淘汰策略、向量搜索
- ann-benchmarks — 各 ANN 算法的公开基准测试