
时间序列分析
本页介绍时间序列分析(Time Series Analysis)——从按时间排列的历史数据中找规律,预测未来。它是金融、零售、能源、气象等行业的核心技术。从 ARIMA 等经典统计方法到 LSTM、Transformer 等深度学习方法,再到 2024-2025 年的时序基础模型(Time Series Foundation Models),时间序列分析正经历从”每个任务单独训练”到”预训练大模型零样本预测”的范式转变。前置阅读:监督学习、特征工程。
时间序列分析的本质:历史会重演——找到规律,就能预测未来。但”规律”有不同的层次:
- 趋势 Trend = 大方向:数据整体往上走(如 GDP 增长)、往下走(如人口下降)、还是持平?趋势是最容易识别的长期规律。
- 季节性 Seasonality = 周期性重复:冰淇淋销量夏天高冬天低,地铁客流工作日多周末少——这些固定周期的波动就是季节性。
- 残差 Residual = 剩下的随机噪音:去掉趋势和季节性后,剩下的就是不可预测的随机波动——模型的目标是尽量解释前两者,残差越小模型越好。
三类方法的直觉:
- 经典统计方法(ARIMA)= 让过去的值预测未来:自回归(AR)用历史值的线性组合预测;差分(I)把非平稳序列变平稳;移动平均(MA)用历史预测误差修正。ARIMA = AR + I + MA 三者结合。
- 机器学习方法 = 特征工程 + 树模型:把时间序列问题转化为表格问题——用滞后值(过去 N 步的值)、滑动窗口统计量(均值/方差/最大值)、时间特征(小时/星期/月份)作为特征,用 XGBoost 等模型预测。详见特征工程和梯度提升树详解。
- 深度学习方法 = 自动学时序模式:LSTM 通过记忆单元捕捉长短期依赖;Transformer 用注意力机制建模全局关系;TCN(时序卷积网络)用因果卷积保证只用过去信息。深度学习无需手动构造特征,但需要更多数据。
2024-2025 新范式:时序基础模型
Section titled “2024-2025 新范式:时序基础模型”就像 LLM 改变了 NLP 一样,时序基础模型(Time Series Foundation Models)正在改变时间序列领域:
- TimesFM(Google,2024):一个 200M 参数的 Decoder-Only Transformer,在 1000 亿个真实世界时间序列数据点上预训练。给定一段历史序列,可以直接在从未见过的新数据集上做零样本(Zero-shot)预测——无需任何训练。
- Chronos(Amazon,2024):把时间序列”分词”为离散 token,然后用标准的语言模型(如 T5)做自回归预测。巧妙地将 LLM 的成熟技术迁移到时序领域。
- Moirai(Salesforce,2024):大规模时间序列基础模型,支持多变量输入和概率预测(输出预测区间而非点估计)。
- TimeGPT(Nixtla,2023):商业化时序基础模型 API,声称在多个基准上零样本预测超越传统方法。
范式转变:传统流程是”收集数据 → 手动调参 ARIMA 或训练 LSTM → 预测”;新范式是”拿预训练模型 → 直接零样本预测 → 如有需要则少量微调”。这大幅降低了时间序列预测的工程门槛。
时间序列分解
Section titled “时间序列分解”任何时间序列可以被分解为三个组成部分:
其中 是趋势项(Trend), 是季节项(Seasonality), 是残差项(Residual)。这是加法模型;当季节波动幅度随趋势增大而增大时,更适合用乘法模型 (取对数后变为加法模型)。
两种经典分解方法:
- 经典分解(Classical Decomposition):用移动平均提取趋势,用月/季度均值提取季节性。简单但对异常值敏感。
- STL 分解(Seasonal and Trend decomposition using Loess):用局部回归(LOESS)平滑提取趋势和季节性,更灵活、更鲁棒,是当前最常用的分解方法。
平稳性与 ADF 检验
Section titled “平稳性与 ADF 检验”平稳性(Stationarity)是时间序列的基石概念:一个平稳序列的统计特性(均值、方差、自相关)不随时间变化。ARIMA 等方法要求输入序列平稳(或经过差分后平稳)。
ADF 检验(Augmented Dickey-Fuller Test)是检验平稳性的标准方法:
- 原假设 :序列有单位根(Unit Root,即非平稳)
- 备择假设 :序列平稳
- 如果 p 值 < 0.05,拒绝 ,认为序列平稳
单位根的直觉:随机游走 是非平稳的——它的方差随时间无限增大。差分一次后 变成了白噪声(平稳)。这就是 ARIMA 中差分阶数 的含义:差分几次能让序列平稳。
ARIMA 模型
Section titled “ARIMA 模型”ARIMA(p, d, q) 是经典时间序列模型的集大成者,三个参数分别对应三种机制:
自回归 AR(p)
Section titled “自回归 AR(p)”当前值是过去 个值的线性组合加上噪声:
其中 是自回归系数, 是白噪声(White Noise,均值为零、方差恒定的随机序列)。
直觉:今天的气温和昨天有关——如果昨天气温突然升高,今天大概率也会偏高。AR 模型就是在量化这种”惯性”。
差分 I(d)
Section titled “差分 I(d)”对非平稳序列做 次差分使其平稳。一阶差分 可以消除线性趋势。ARIMA 中的 I 代表”Integrated”——最终预测需要”反差分”还原到原始尺度。
移动平均 MA(q)
Section titled “移动平均 MA(q)”当前值是过去 个预测误差的线性组合加上当前噪声:
直觉:如果你的预测昨天偏低了 10 度(误差 +10),今天应该把预测往上调一些——MA 就是在用过去的”失误”来修正今天的预测。
季节性扩展 SARIMA
Section titled “季节性扩展 SARIMA”当数据有季节性时,ARIMA 扩展为 SARIMA(p,d,q)(P,D,Q,s),其中大写字母是季节性对应的参数, 是季节周期(如月度数据 )。
指数平滑(Exponential Smoothing)是 ARIMA 的有力替代,核心思想是给近期的数据更大的权重:
- 简单指数平滑(SES):,其中 。权重呈指数衰减——最近的数据权重最大。
- Holt 线性趋势法:在 SES 基础上增加趋势项,适合有线性趋势但无季节性的数据。
- Holt-Winters 三参数法:再加季节项,适合既有趋势又有季节性的数据。三种变体:加法季节、乘法季节、阻尼趋势。
LSTM 时序预测
Section titled “LSTM 时序预测”LSTM(Long Short-Term Memory)通过门控机制(遗忘门、输入门、输出门)解决 RNN 的梯度消失问题,适合捕捉长短期依赖:
- 输入:过去 步的序列 (滑动窗口)
- 输出:未来 步的预测
- 优势:自动学习时间依赖,不需要手动指定 AR 阶数;能处理多变量输入
- 劣势:需要大量数据训练,容易过拟合,训练慢
Transformer 时序模型
Section titled “Transformer 时序模型”2020 年以来,研究者开始用 Transformer 架构处理时间序列,核心优势是注意力机制可以直接建模任意远距离的依赖关系:
- Informer(Zhou et al., AAAI 2021):用 ProbSparse 自注意力处理长序列,解决了标准注意力 的问题。
- PatchTST(Nie et al., ICLR 2023):借鉴 ViT 的 patch 思想——把时间序列切分为多个 patch,每个 patch 做一个 token,大幅提升效率和效果。
- TimesNet(Wu et al., ICLR 2023):发现 1D 时间序列可以通过 FFT 转为 2D 张量——同时捕捉”周期内”和”周期间”两种变化模式。
- iTransformer(Liu et al., ICLR 2024):反转维度——在变量维度上做注意力而非时间维度,简单有效。
Transformer 在时序上的争议:2023 年 Zeng et al. 的论文 “Are Transformers Effective for Time Series Forecasting?” 用一个简单的线性模型 DLinear 打败了多个 Transformer 变体,引发激烈讨论。核心问题是:很多 Transformer 时序模型在长序列预测中并未真正利用长距离依赖,而是主要靠近期的简单趋势。但 PatchTST 和 iTransformer 等后续工作证明了 Transformer 的潜力。
时间序列分解
Section titled “时间序列分解”任何时间序列可以分解为趋势 + 季节性 + 残差:
方法选择决策
Section titled “方法选择决策”时序基础模型工作流
Section titled “时序基础模型工作流”STL 分解 + ADF 平稳性检验
Section titled “STL 分解 + ADF 平稳性检验”import numpy as npimport matplotlib.pyplot as pltfrom statsmodels.tsa.seasonal import STLfrom statsmodels.tsa.stattools import adfuller
# 生成带趋势和季节性的模拟数据(120 个月)np.random.seed(42)t = np.arange(120)data = 10 + 0.5 * t + 5 * np.sin(2 * np.pi * t / 12) + np.random.randn(120) * 2
# STL 分解(比经典分解更灵活、更鲁棒)stl = STL(data, period=12, robust=True)result = stl.fit()fig, axes = plt.subplots(4, 1, figsize=(12, 10), sharex=True)axes[0].plot(data); axes[0].set_title('原始数据')axes[1].plot(result.trend); axes[1].set_title('趋势 Trend')axes[2].plot(result.seasonal); axes[2].set_title('季节性 Seasonal')axes[3].plot(result.resid); axes[3].set_title('残差 Residual')plt.tight_layout(); plt.savefig('stl_decomposition.png', dpi=150)
# ADF 检验:检查残差是否平稳(应该平稳)adf_stat, p_value = adfuller(result.resid)[:2]print(f"ADF 统计量: {adf_stat:.3f}, p-value: {p_value:.4f}")print(f"残差{'平稳' if p_value < 0.05 else '非平稳'}")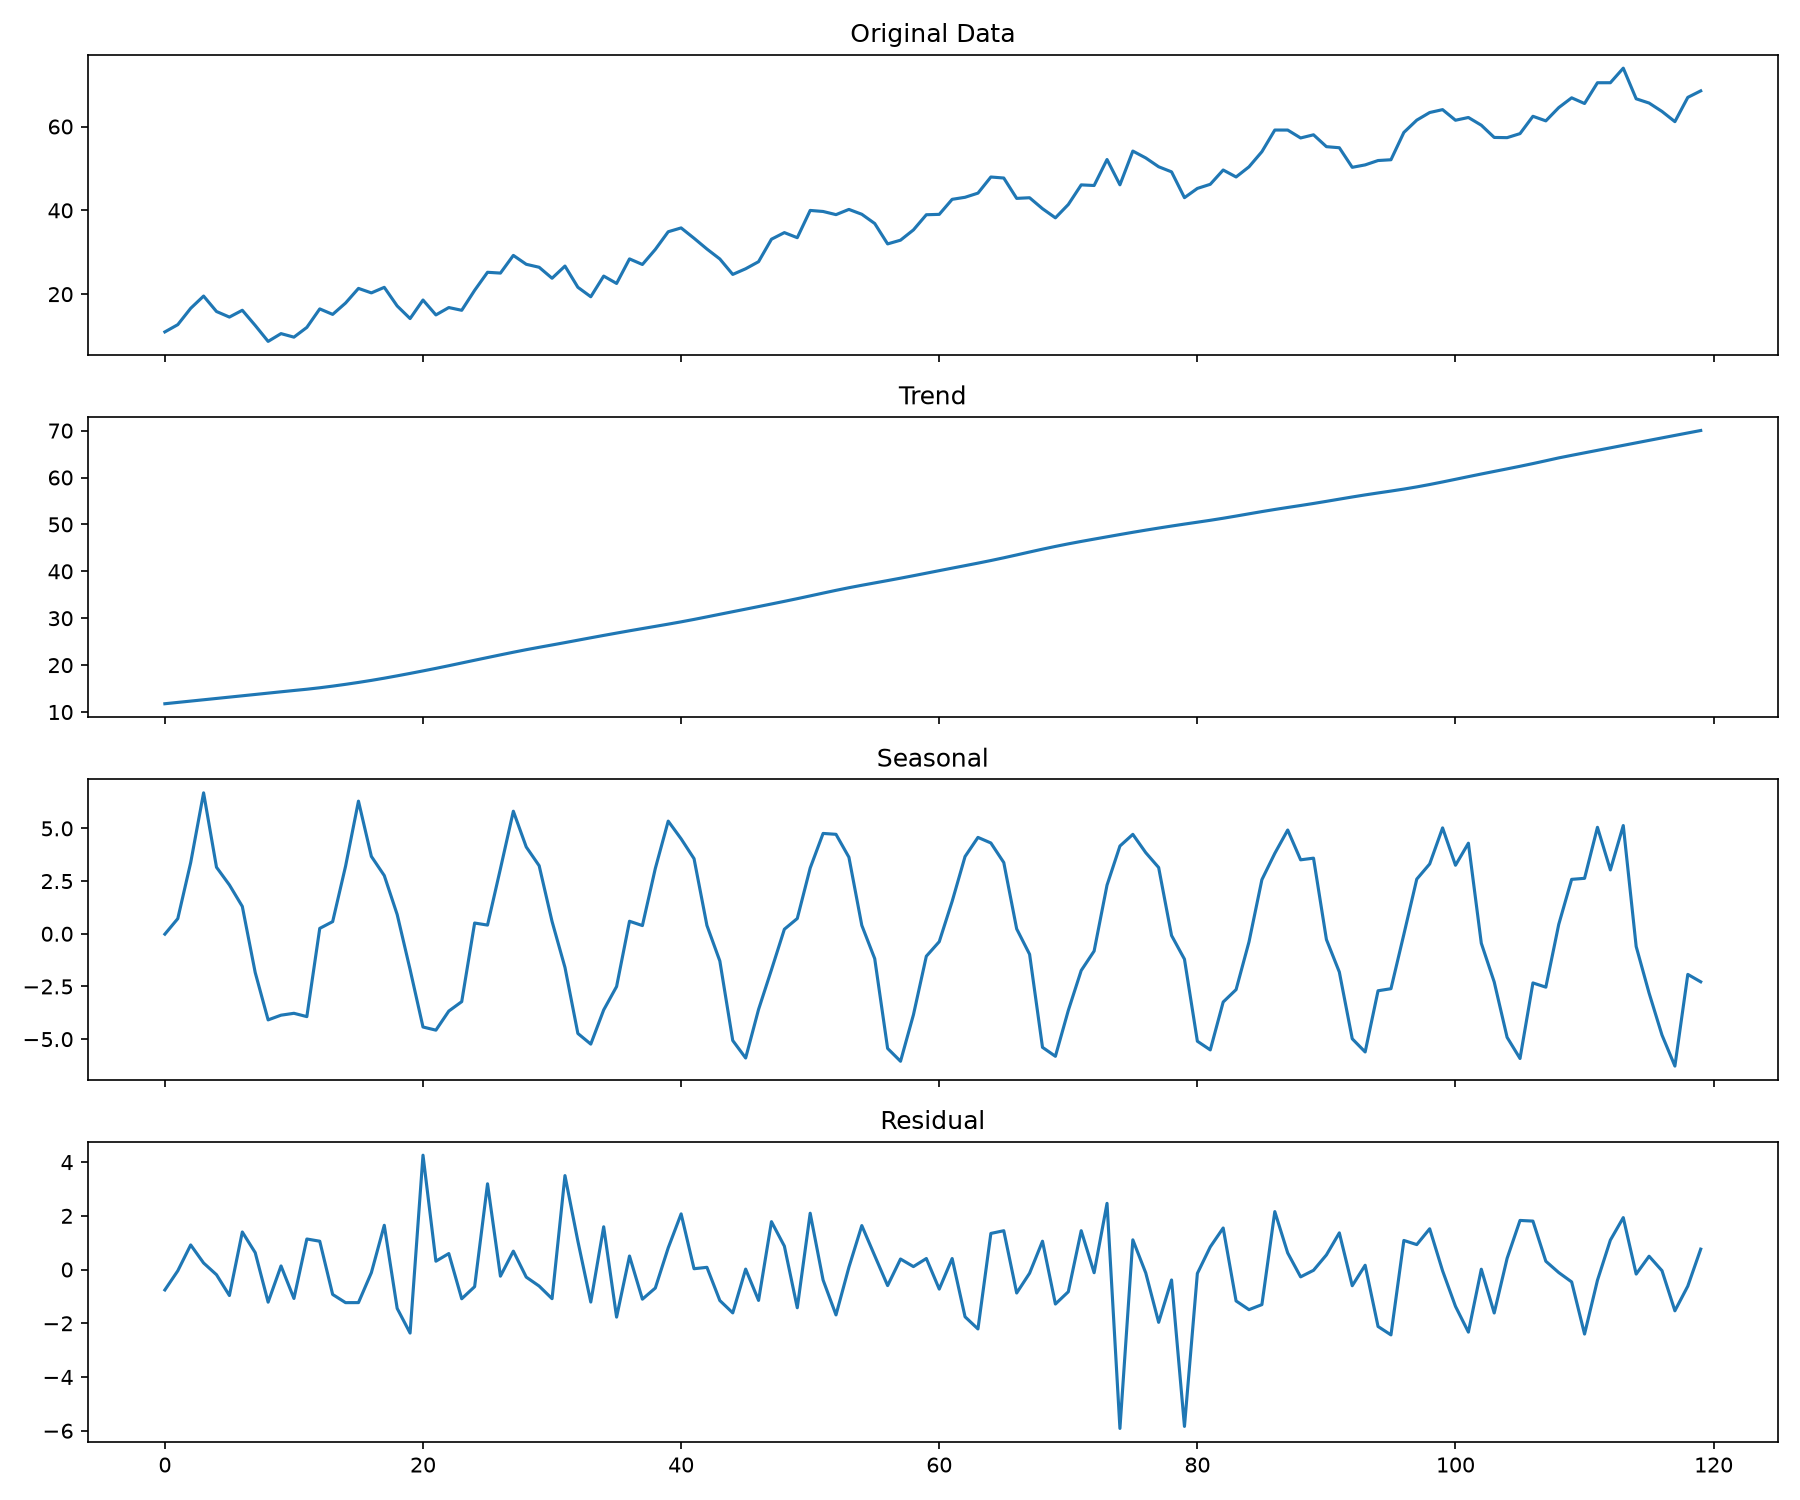
ARIMA 预测(statsmodels)
Section titled “ARIMA 预测(statsmodels)”from statsmodels.tsa.arima.model import ARIMA
# ARIMA(p, d, q): p=自回归阶数, d=差分阶数, q=移动平均阶数model = ARIMA(data, order=(2, 1, 1))fitted = model.fit()print(fitted.summary()) # 查看模型参数和 AIC
# 预测未来 12 个月forecast = fitted.forecast(steps=12)print(f"未来 12 个月预测值: {forecast.round(1)}")
# 模型诊断:残差应该是白噪声(无自相关)residuals = fitted.residauto_arima 自动参数搜索
Section titled “auto_arima 自动参数搜索”# pip install pmdarimafrom pmdarima import auto_arimaimport numpy as np
np.random.seed(42)t = np.arange(120)data = 10 + 0.5 * t + 5 * np.sin(2 * np.pi * t / 12) + np.random.randn(120) * 2
# 自动搜索最优 (p,d,q),按 AIC 排序model = auto_arima(data, seasonal=True, m=12, # m=季节周期 d=None, D=None, # 自动确定差分阶数 trace=True, # 打印搜索过程 error_action='ignore', suppress_warnings=True)print(f"最优 SARIMA 阶数: {model.order} x {model.seasonal_order}")Prophet:Facebook 的业务预测工具
Section titled “Prophet:Facebook 的业务预测工具”# pip install prophetimport pandas as pdfrom prophet import Prophet
# Prophet 要求数据框有两列: ds(日期) 和 y(值)np.random.seed(42)dates = pd.date_range('2020-01-01', periods=120, freq='M')y = 10 + 0.5 * np.arange(120) + 5 * np.sin(2 * np.pi * np.arange(120) / 12) + np.random.randn(120) * 2df = pd.DataFrame({'ds': dates, 'y': y})
# Prophet 自动处理趋势、季节性、节假日m = Prophet(yearly_seasonality=True, changepoint_prior_scale=0.05)m.fit(df)
# 预测未来 12 个月future = m.make_future_dataframe(periods=12, freq='M')forecast = m.predict(future)print(forecast[['ds', 'yhat', 'yhat_lower', 'yhat_upper']].tail(12).round(1))# yhat: 点预测, yhat_lower/upper: 80% 预测区间XGBoost 时序预测(特征工程方法)
Section titled “XGBoost 时序预测(特征工程方法)”import numpy as npimport pandas as pdfrom sklearn.model_selection import train_test_splitimport xgboost as xgbfrom sklearn.metrics import mean_squared_error
# 生成数据np.random.seed(42)t = np.arange(365)y = 20 + 0.1 * t + 10 * np.sin(2 * np.pi * t / 365) + np.random.randn(365) * 3
# 构造表格特征:把时序问题转化为表格问题def make_features(y, lags=[1, 2, 3, 7, 14, 28], window=7): df = pd.DataFrame({'y': y}) for lag in lags: df[f'lag_{lag}'] = df['y'].shift(lag) # 滞后特征 df['rolling_mean'] = df['y'].shift(1).rolling(window).mean() # 滑动均值 df['rolling_std'] = df['y'].shift(1).rolling(window).std() # 滑动标准差 return df.dropna()
feat = make_features(y)X = feat.drop('y', axis=1).valuesy_train = feat['y'].values
X_tr, X_te, y_tr, y_te = train_test_split(X, y_train, test_size=0.2, shuffle=False)model = xgb.XGBRegressor(n_estimators=200, learning_rate=0.05, max_depth=5)model.fit(X_tr, y_tr)pred = model.predict(X_te)rmse = np.sqrt(mean_squared_error(y_te, pred))print(f"XGBoost RMSE: {rmse:.3f}")时序基础模型零样本预测(概念示例)
Section titled “时序基础模型零样本预测(概念示例)”"""使用 Google TimesFM 进行零样本时间序列预测的概念示例。TimesFM 是在 1000 亿个时间序列点上预训练的 Decoder-Only Transformer。"""# pip install timesfm (需要 Python 3.10+, 较新版本 PyTorch)# import timesfm
# 初始化预训练模型# tfm = timesfm.TimesFm(# hparams=timesfm.TimesFmHparams(# backend="gpu",# per_core_batch_size=32,# horizon_len=128, # 预测未来 128 步# ),# checkpoint=timesfm.TimesFmCheckpoint(# huggingface_repo_id="google/timesfm-1.0-200m-pytorch"# ),# )
# 零样本预测:无需任何训练,直接输入历史序列# context = [your_time_series_data] # 一段历史数据# forecast = tfm.forecast(context)# forecast_point = forecast[0].mean # 点预测# forecast_interval = forecast[0].quantiles # 预测区间
# 对比:传统 ARIMA 需要为每个序列单独拟合,# 而 TimesFM 可以对任意新序列直接零样本预测——# 这是时序领域从"每个任务从头训练"到"预训练+零样本"的范式转变- 先检查平稳性:ARIMA 要求时间序列平稳(均值和方差不随时间变化)。用 ADF 检验判断是否平稳,不平稳就做差分(
d参数)使其平稳。 - ARIMA 参数选择:
p(AR 阶数)和q(MA 阶数)可以通过 ACF/PACF 图辅助选择(截尾处即为阶数),也可以用auto_arima(pmdarima 库)自动搜索最优参数。 - 不要忘了基线模型:在尝试复杂模型前,先跑一个朴素基线(Naive Baseline)——“明天的值等于今天的值”或”下个月的值等于去年同月的值”。如果你的复杂模型还不如基线,说明方向错了。这是时间序列实践中最常见的错误。
- 深度学习不一定更好:在很多时间序列任务上,精心调参的 ARIMA 或 XGBoost 可以打败 LSTM。2023 年的研究(Zeng et al.)甚至表明简单线性模型在某些基准上超越了 Transformer 变体。深度学习的优势在多变量、非线性复杂关系和大规模数据场景。
- 注意数据泄露:时间序列的特征工程中,不能用未来信息预测过去——所有滞后特征必须严格使用 ()的数据。交叉验证要用
TimeSeriesSplit,不能用普通随机划分。 - 评估指标:时间序列常用 MAE(平均绝对误差)、MAPE(平均绝对百分比误差,便于理解但 y=0 时不可用)、RMSE(均方根误差,对大误差敏感)和 MASE(平均绝对缩放误差,相对于朴素基线的改进比例,MASE < 1 表示比基线好)。
- 概率预测优于点预测:输出预测区间(如 80%/95% 置信区间)比单一点预测更有业务价值——你可以知道”最坏情况是什么”。Prophet 和 Chronos 都支持概率预测。
- 多变量 vs 单变量:如果外部变量(天气、促销)对目标有显著影响,多变量模型通常更好;但如果外部变量本身就难以预测,简单的单变量模型反而更稳健。
- 2025 年实践建议:
- 先跑朴素基线和 SARIMA/XGBoost 建立基线
- 然后尝试时序基础模型(TimesFM、Chronos)的零样本预测
- 如果零样本不够好,做少量微调(Few-shot Fine-tuning)
- 只有在上述都不够时,才考虑从头训练 Transformer 或 LSTM
- 销量预测 → 零售/电商:预测未来一周/月各商品销量,指导备货和库存管理——沃尔玛、京东用销量预测优化供应链,减少缺货和积压,直接转化为利润。
- 电力负荷预测 → 能源:预测未来 24 小时各区域用电量,电网据此调度发电机组——电力不可大规模存储,负荷预测准确度直接关系电网安全和成本。
- 金融预测 → 量化交易/风险管理:股价、汇率、利率的走势预测是量化交易的基础(虽然有效市场假说认为长期不可预测,但短期波动模式可挖掘);VaR(风险价值)计算依赖波动率预测。
- 交通流量预测 → 智慧交通:预测各路段未来时段的车流量,导航软件(高德/百度地图)据此推荐最优路线,交管部门据此优化信号灯配时。
- 天气预测 → 气象:气温、降水、风速的时间序列预测——从数值天气预报到深度学习辅助预测,天气预报是人类最重要的预测任务之一。
- 服务器负载预测 → 云计算运维:预测 CPU/内存/带宽需求,指导弹性扩容——Netflix、AWS 用时间序列预测实现自动伸缩(Auto-scaling),节省成本。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| statsmodels | Python | 经典统计时序库,提供 ARIMA、SARIMAX、指数平滑、STL 分解、ADF 检验等 |
| pmdarima | Python | ARIMA 自动参数搜索库,类似 R 的 auto.arima |
| Prophet | Python/R | Facebook 开源,擅长处理节假日和季节性的业务预测,简单易用 |
| darts | Python | 统一接口的时序库,覆盖从 ARIMA 到 Transformer 的全谱方法 |
| sktime | Python | 基于 scikit-learn API 的机器学习时序工具库 |
| NeuralProphet | Python | Prophet 的神经网络增强版,融合可解释性与深度学习 |
| TimesFM | Python | Google 时序基础模型,零样本预测 |
| Chronos | Python | Amazon 基于语言模型的时序预测 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 平稳性 | Stationarity | 时间序列的统计特性(均值/方差/自相关)不随时间变化 |
| 差分 | Differencing | 用相邻观测值之差使非平稳序列变平稳的操作 |
| 自回归 | AutoRegressive (AR) | 用历史值的线性组合预测当前值的模型 |
| 移动平均 | Moving Average (MA) | 用历史预测误差的线性组合修正预测的模型 |
| ACF / PACF | Auto/Partial Auto-Correlation Function | 自相关/偏自相关函数,用于选择 ARIMA 参数 |
| 季节性 | Seasonality | 时间序列中以固定周期重复的规律性波动 |
| 滞后特征 | Lag Feature | 用过去若干步的值作为预测当前值的特征 |
| 时序交叉验证 | TimeSeriesSplit | 保证训练数据在时间上早于测试数据的交叉验证方式 |
| STL 分解 | STL Decomposition | 基于 LOESS 回归的时间序列分解方法,提取趋势和季节性 |
| 单位根 | Unit Root | 使时间序列非平稳的特征,ADF 检验的目标 |
| 时序基础模型 | Time Series Foundation Model | 在海量时序数据上预训练的通用模型,支持零样本预测 |
| 零样本预测 | Zero-shot Forecasting | 无需任何训练,直接在未见过的时序数据上做预测 |
| 概率预测 | Probabilistic Forecasting | 输出预测分布(区间)而非单一点估计 |
- 经典方法谱系:ARIMA(Box & Jenkins 1970,时间序列分析的”圣经”级框架)→ SARIMA(加入季节项)→ 指数平滑(Holt 1957 / Winters 1960,Holt-Winters 三参数法)→ State Space 模型 / Kalman 滤波。这些方法至今仍是时间序列分析的基石。推荐教材:Hyndman & Athanasopoulos,《Forecasting: Principles and Practice》(3rd ed., 2021,免费在线),时序预测的最佳入门书。
- Prophet:Taylor & Letham 2018 “Forecasting at Scale”(PeerJ),Facebook 的业务预测工具,擅长处理节假日效应和变点检测。
- 机器学习方法谱系:特征工程(滞后值 + 滑动窗口 + 时间编码)+ 树模型(XGBoost / LightGBM)是 M4 等时序竞赛中的强力方案。集成方法见集成学习与随机森林。
- 深度学习方法谱系:LSTM(Hochreiter & Schmidhuber 1997,解决 RNN 长依赖问题)→ TCN(时序卷积网络,Bai et al. 2018)→ Informer(Zhou et al. 2021,稀疏注意力处理长序列)→ PatchTST(Nie et al. ICLR 2023,把 Transformer 的 patch 思路引入时序)→ TimesNet(Wu et al. ICLR 2023,将一维时序转为二维以同时捕捉周期内和周期间变化)→ iTransformer(Liu et al. ICLR 2024,反转维度做注意力)。Transformer 架构见Transformer 架构。
- 时序基础模型:TimesFM(Das et al., Google, ICML 2024)、Chronos(Ansari et al., Amazon, 2024)、Moirai(Woo et al., Salesforce, ICML 2024)——代表时序领域的”Foundation Model”路线,用海量时序数据预训练实现零样本预测。
- 争议与反思:Zeng et al. 2023 “Are Transformers Effective for Time Series Forecasting?”(AAAI 2023)用简单线性模型 DLinear 质疑 Transformer 在时序上的有效性,引发重要讨论。