
工业视觉工程
工业视觉(Industrial Vision)是工业 AI 系统的感知层入口——所有”看”的环节都从这里开始。无论是产线上的缺陷检测、尺寸测量,还是自动对位、机器人引导,第一步都是把物理世界的图像采集进来并做处理。本页聚焦视觉数据从采集到推理的工程化问题:如何解码 RTSP 视频流、如何同时管理几十路摄像头、如何在有限算力下把 FPS 拉满、如何保证断流后自动恢复。
如果你更关心视觉模型的原理(CNN、目标检测、图像分割),请先阅读 CNN 主线、目标检测与 YOLO、图像分割。本页假设你已经了解这些模型,专注于”怎么把模型高效地喂上图像”。各技术最终如何组装成完整系统,请参考 工业 AI 系统。
工业视觉工程的本质矛盾是:摄像头产生的数据量,远超你能实时处理的量。
一路 1080p @ 30fps 的摄像头,原始数据流量约 。16 路就是约 3 GB/s。这些数据必须在几十毫秒内完成解码 → 预处理 → 推理 → 后处理 → 决策的完整链路。
因此工业视觉工程的核心工作不是”写模型”,而是围绕这条链路做性能工程——把延迟压低、把吞吐拉高、把多路并发管好、把异常恢复做好。可以把它类比成一条流水线:
这条链路的每一环都可能成为瓶颈,而工程师的工作就是找到瓶颈并消除它。
OpenCV 工业应用
Section titled “OpenCV 工业应用”OpenCV(Open Source Computer Vision Library)是工业视觉中最基础的工具库,提供从图像读取到传统视觉算法的完整能力。在深度学习时代,OpenCV 的角色从”做检测”退化为”做预处理和传统辅助算法”——但它在工业现场依然不可替代,因为大量场景(定位、对位、标定)用传统方法反而比深度学习更快更稳。
模板匹配(Template Matching)
Section titled “模板匹配(Template Matching)”模板匹配(用 cv2.matchTemplate 实现)是工业对位最常用的算法:拿一张小图(模板)在大图里滑动搜索,找到匹配度最高的位置。典型用途是工件定位——先找到零件在画面里的精确坐标,后续的缺陷检测只在这个 ROI(Region of Interest,感兴趣区域)内做,大幅减少计算量。
"""模板匹配工件定位示例场景:相机拍摄传送带上的金属零件,需要实时找到零件中心坐标。"""import cv2import numpy as np
# 读取场景图(相机实时帧)和模板图(提前截取的零件标准外观)scene = cv2.imread("scene.png", cv2.IMREAD_GRAYSCALE)template = cv2.imread("template.png", cv2.IMREAD_GRAYSCALE)h, w = template.shape[:2]
# matchTemplate 在 scene 上以滑窗方式计算模板与局部区域的相似度# TM_CCOEFF_NORMED:归一化相关系数,值域 [-1, 1],越接近 1 匹配越好result = cv2.matchTemplate(scene, template, cv2.TM_CCOEFF_NORMED)min_val, max_val, min_loc, max_loc = cv2.minMaxLoc(result)
# max_loc 是最佳匹配位置的左上角坐标top_left = max_loccenter_x = top_left[0] + w // 2center_y = top_left[1] + h // 2confidence = max_val  # 置信度,用于判断是否找到
if confidence > 0.85: print(f"工件定位成功:中心=({center_x}, {center_y}),置信度={confidence:.3f}") # 后续:只在此 ROI 区域做缺陷检测,节省推理算力else: print(f"未找到工件(置信度 {confidence:.3f} 低于阈值 0.85)")工程提示:纯模板匹配对光照变化和旋转非常敏感。工业现场通常配合光照控制(恒定光源)和多角度模板(提前截取多个旋转角度的模板分别匹配)来提升鲁棒性。如果零件有任意旋转,考虑用特征点匹配(SIFT/ORB)替代。
形态学操作(Morphological Operations)
Section titled “形态学操作(Morphological Operations)”形态学操作(Morphology)是基于数学形态学的图像处理方法,用一个小结构元素(kernel)对二值图或灰度图做膨胀(dilate)、腐蚀(erode)等操作,用途是去噪、填充孔洞、连接断裂区域。在预处理阶段非常常用。
"""形态学操作示例:去除二值化掩码中的小噪点并填充孔洞"""import cv2import numpy as np
mask = cv2.imread("defect_mask.png", cv2.IMREAD_GRAYSCALE)kernel = np.ones((5, 5), np.uint8)
# 开运算(Opening)= 先腐蚀后膨胀 → 去除小的前景噪点opened = cv2.morphologyEx(mask, cv2.MORPH_OPEN, kernel)
# 闭运算(Closing)= 先膨胀后腐蚀 → 填充前景内的小孔洞closed = cv2.morphologyEx(mask, cv2.MORPH_CLOSE, kernel)
# 组合:先开运算去噪,再闭运算填孔 → 得到干净的目标区域clean_mask = cv2.morphologyEx(opened, cv2.MORPH_CLOSE, kernel)| 操作 | 公式 | 效果 | 典型用途 |
|---|---|---|---|
| 腐蚀 erode | 缩小前景 | 去除微小噪点、分离粘连物体 | |
| 膨胀 dilate | 扩大前景 | 连接断裂区域、填充缝隙 | |
| 开运算 opening | 去除小前景 | 消除散点噪声 | |
| 闭运算 closing | 填充小孔洞 | 补全目标区域 |
边缘检测(Edge Detection)
Section titled “边缘检测(Edge Detection)”边缘检测用于提取物体的轮廓信息。Canny 算法是工业中最常用的边缘检测器,它包含多步:高斯模糊降噪 → Sobel 梯度计算 → 非极大值抑制 → 双阈值滞后处理。
import cv2
gray = cv2.imread("part.png", cv2.IMREAD_GRAYSCALE)# Canny 双阈值:低于 threshold1 的边缘被丢弃,高于 threshold2 的保留为强边缘edges = cv2.Canny(gray, threshold1=50, threshold2=150)# edges 是二值图,白色像素即为检测到的边缘
边缘检测结果常作为后续霍夫变换(检测直线/圆)或轮廓提取(
cv2.findContours)的输入,用于尺寸测量和形状检测。
FFmpeg:视频解码与推流利器
Section titled “FFmpeg:视频解码与推流利器”FFmpeg 是音视频领域的瑞士军刀,在工业视觉中承担视频解码、编码、转码、抽帧、推流等任务。几乎所有 AI 视觉项目在处理 RTSP 视频流时,底层都直接或间接依赖 FFmpeg(OpenCV 的 VideoCapture 在读取视频文件/流时底层就调用 FFmpeg)。
常用命令行实战
Section titled “常用命令行实战”# 1. RTSP 转码为更易处理的格式(降低分辨率,方便 AI 推理)ffmpeg -rtsp_transport tcp \ -i "rtsp://admin:pass123@192.168.1.100:554/Streaming/Channels/101" \ -c:v libx264 -s 1280x720 -r 25 -preset ultrafast \ -f rtsp "rtsp://localhost:8554/processed"
# 2. 从视频中每隔 1 秒抽一帧(生成训练数据集)ffmpeg -i input.mp4 -vf "fps=1" frames/frame_%06d.jpg
# 3. 推流到 RTMP 服务器(直播/远程监控)ffmpeg -re -i output.mp4 -c copy -f flv "rtmp://server/live/stream_key"
# 4. 只提取第 100~200 帧之间的片段ffmpeg -i input.mp4 -vf "select=between(n\,100\,200)" -vsync 0 clips/segment.mp4各参数含义:
| 参数 | 含义 | 常用值 |
|---|---|---|
-i | 输入源(文件/RTSP/RTMP/设备) | URL 或文件路径 |
-r | 帧率(fps) | 25, 30 |
-s | 输出分辨率 | 1280x720, 1920x1080 |
-c:v | 视频编解码器 | libx264(H.264), libx265(H.265), h264_nvenc(NVIDIA 硬件编码) |
-preset | 编码速度/压缩率权衡 | ultrafast ~ veryslow |
-rtsp_transport | RTSP 传输方式 | tcp(可靠)或 udp(低延迟) |
-vf | 视频滤镜链 | fps=1, scale=640:480 |
硬件加速:NVDEC / NVENC
Section titled “硬件加速:NVDEC / NVENC”纯软件解码(CPU)在处理多路高分辨率视频时很快成为瓶颈。NVIDIA GPU 提供了专用的硬件编解码引擎:
- NVDEC(NVIDIA Decoder):GPU 硬件解码,一块 GPU 可同时解码几十路 1080p 流
- NVENC(NVIDIA Encoder):GPU 硬件编码,用于输出处理后的视频
# 使用 NVDEC 硬件解码 RTSP 流,再用 NVENC 硬件编码输出ffmpeg -hwaccel cuda -c:v h264_cuvid \ -i "rtsp://admin:pass@192.168.1.100/stream" \ -c:v h264_nvenc -preset p1 -tune ll \ -f rtsp "rtsp://localhost:8554/output"# -hwaccel cuda → 启用 CUDA 硬件加速# h264_cuvid → NVDEC H.264 解码器# h264_nvenc → NVENC H.264 编码器# -tune ll → 低延迟调优硬件解码的另一个巨大优势是零拷贝:解码后的帧直接留在 GPU 显存中,可以直接送入深度学习模型推理,避免 GPU→CPU→GPU 的来回搬运。NVIDIA 的 DeepStream SDK 正是围绕这一能力构建的高性能视频分析管线。
FFmpeg 解码后的帧通常会送入分割模型做进一步处理,相关原理请参考 图像分割。
RTSP 协议详解
Section titled “RTSP 协议详解”RTSP(Real-Time Streaming Protocol,实时流传输协议)是工业摄像头最常用的视频流协议。理解 RTSP 的 URL 格式和传输方式,是接入工业相机的基础。
RTSP URL 格式
Section titled “RTSP URL 格式”rtsp://[user:password@]host[:port][/path]user:password:认证信息(如果摄像头启用了密码认证)host:摄像头 IP 地址port:RTSP 端口,默认554path:流路径,不同品牌不同:
| 品牌 | 典型 RTSP 路径 |
|---|---|
| 海康威视(Hikvision) | rtsp://admin:pass@IP:554/Streaming/Channels/101 |
| 大华(Dahua) | rtsp://admin:pass@IP:554/cam/realmonitor?channel=1&subtype=0 |
| 宇视(Uniview) | rtsp://admin:pass@IP:554/media/video1 |
| 通用 ONVIF | rtsp://user:pass@IP:554/onvif1 |
RTSP 支持两种 HTTP 风格的认证:
- Basic 认证:用户名密码以 Base64 明文编码放在请求头中,不安全,容易被抓包窃取。
- Digest 认证(摘要认证):使用 challenge-response 机制,密码不以明文传输,安全性更高。大多数现代摄像头默认使用 Digest。
UDP vs TCP 传输
Section titled “UDP vs TCP 传输”RTSP 负责流控制,但实际的媒体数据(RTP 包)可以使用不同传输层:
| 传输方式 | 特点 | 适用场景 |
|---|---|---|
| UDP | 无连接、不保证可靠、延迟低(无重传) | 局域网、对延迟极敏感、允许少量丢帧 |
| TCP | 面向连接、保证可靠、延迟稍高(有重传) | 跨网段、网络质量不稳定、需要完整性 |
工业现场建议:绝大多数工业视觉部署在局域网内,但网络抖动偶有发生。建议优先使用 TCP(
-rtsp_transport tcp),因为视觉推理对帧完整性要求高——丢帧会导致推理跳变,而稍微增加的延迟(几毫秒)在工业场景中通常可以接受。
OpenCV 接入 RTSP
Section titled “OpenCV 接入 RTSP”"""OpenCV 通过 RTSP 读取工业摄像头视频流"""import cv2
# 构造 RTSP URL(海康威视示例)rtsp_url = "rtsp://admin:YourPass@192.168.1.100:554/Streaming/Channels/101"
# 关键:设置环境变量强制使用 TCP 传输,避免 UDP 丢包导致花屏import osos.environ["OPENCV_FFMPEG_CAPTURE_OPTIONS"] = "rtsp_transport;tcp"
cap = cv2.VideoCapture(rtsp_url, cv2.CAP_FFMPEG)
if not cap.isOpened(): raise RuntimeError(f"无法打开 RTSP 流: {rtsp_url}")
while True: ret, frame = cap.read() if not ret: print("读取帧失败,可能断流") break
# 在这里做预处理 + 推理 # result = model(frame)
cv2.imshow("RTSP Stream", frame) if cv2.waitKey(1) & 0xFF == ord('q'): break
cap.release()cv2.destroyAllWindows()多路视频管理
Section titled “多路视频管理”工业现场往往有十几路甚至几十路摄像头同时工作。如何高效管理多路视频流是工业视觉工程的核心挑战之一。
为什么不能单线程处理多路?
Section titled “为什么不能单线程处理多路?”直觉上,一个循环轮流读取每路摄像头似乎可行。但实际上,cap.read() 是阻塞调用——如果某一路因为网络抖动延迟了 200ms,整个循环就会被卡住,导致其他所有路的帧积压、延迟雪崩式增长。
下图直观展示了不同多路策略的吞吐量差异:
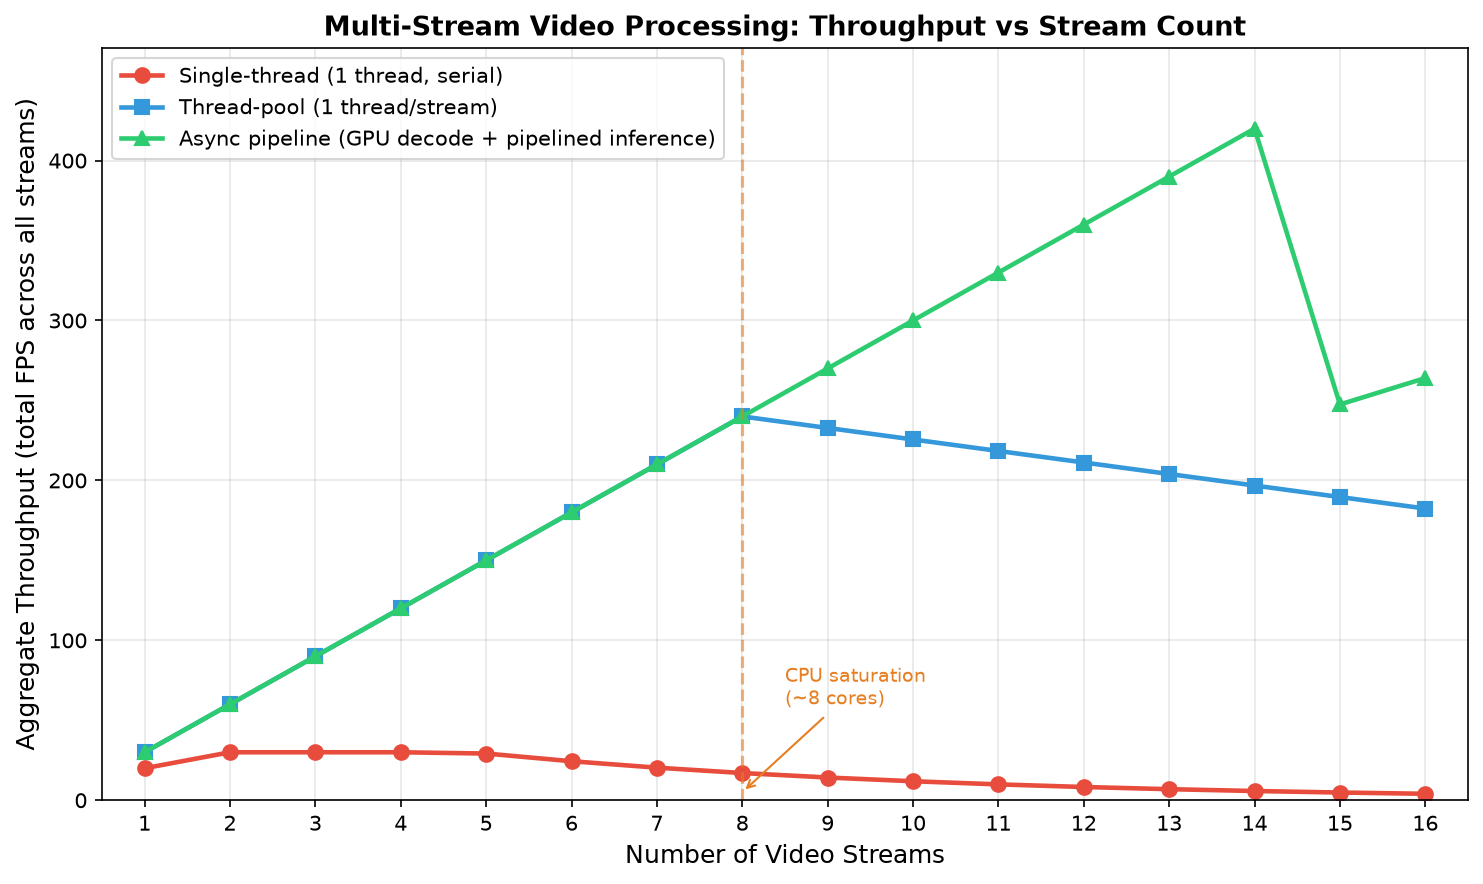
如图所示,单线程方案在路数增加时总吞吐量不升反降;线程池方案在 CPU 核心数耗尽后停止扩展;异步管线方案(GPU 硬件解码 + 推理流水线)扩展性最好。
方案一:线程池(每路一个线程)
Section titled “方案一:线程池(每路一个线程)”最直接的方案是给每路摄像头分配一个独立线程负责读取帧,主线程只做推理。
"""多路视频线程池方案每个 RTSP 源一个独立线程,持续将最新帧写入共享缓冲区。主线程轮询各缓冲区做推理。"""import cv2import threadingimport time
class StreamThread(threading.Thread):    def __init__(self, rtsp_url, name):        super().__init__(daemon=True)        self.rtsp_url = rtsp_url        self.name = name        self.frame = None          # 共享变量:只保留最新帧        self.lock = threading.Lock()        self.running = True
    def run(self):        cap = cv2.VideoCapture(self.rtsp_url, cv2.CAP_FFMPEG)        while self.running:            ret, frame = cap.read()            if not ret:                print(f"[{self.name}] 断流,2 秒后重连...")                time.sleep(2)                cap.release()                cap = cv2.VideoCapture(self.rtsp_url, cv2.CAP_FFMPEG)                continue            with self.lock:                self.frame = frame  # 覆盖旧帧——只处理最新的        cap.release()
    def get_frame(self):        with self.lock:            return self.frame.copy() if self.frame is not None else None
# 启动多路streams = [    StreamThread("rtsp://admin:pass@192.168.1.101/stream", "CAM-01"),    StreamThread("rtsp://admin:pass@192.168.1.102/stream", "CAM-02"),    StreamThread("rtsp://admin:pass@192.168.1.103/stream", "CAM-03"),]for s in streams:    s.start()
# 主循环:轮询各路最新帧做推理while True: for s in streams: frame = s.get_frame() if frame is not None: # result = model(frame) # 推理 pass time.sleep(0.001)关键设计:缓冲区只保留最新一帧,积压的旧帧直接丢弃。这保证了推理永远处理最新的画面,延迟不会累积。这比用一个
Queue缓存所有帧要好得多——后者会导致延迟越来越大。
方案二:GStreamer Pipeline
Section titled “方案二:GStreamer Pipeline”GStreamer 是一个灵活的多媒体管线框架,比 FFmpeg 命令行更模块化。可以通过字符串描述整个处理链路:
"""通过 GStreamer pipeline 接入 RTSP 并做硬件加速解码"""import cv2
pipeline = (    "rtspsrc location=rtsp://admin:pass@192.168.1.100/stream latency=0 ! "    "rtph264depay ! h264parse ! "    "nvv4l2decoder ! "             # NVIDIA 硬件解码(NVDEC)    "nvvidconv ! "                 # 格式转换(GPU → CPU)    "video/x-raw, format=BGRx ! "    "videoconvert ! "    "video/x-raw, format=BGR ! appsink")cap = cv2.VideoCapture(pipeline, cv2.CAP_GSTREAMER)
方案三:NVIDIA DeepStream
Section titled “方案三:NVIDIA DeepStream”当路数达到几十路时,最专业的方案是 DeepStream SDK,它基于 GStreamer 但深度优化了 GPU 硬件解码和批量推理,能在一块 GPU 上同时处理 30+ 路高清视频流,并内置目标追踪、 OSD 叠加、消息发布等工业功能。
FPS 优化策略
Section titled “FPS 优化策略”在算力有限的边缘设备上,把推理 FPS 拉满是最常见的优化目标。以下策略按性价比从高到低排列。
1. 分辨率降采样
Section titled “1. 分辨率降采样”大多数工业视觉任务不需要 1080p 的分辨率。降到 720p 或更低,计算量可减少 以上:
例如从 降到 :,计算量降为原来的 44%。
# 推理前 resize 到更小尺寸inference_frame = cv2.resize(frame, (640, 360))result = model(inference_frame)2. ROI 裁剪
Section titled “2. ROI 裁剪”如果只关心画面的某个区域(如传送带中央),预先裁剪 ROI 可以大幅减少无效计算:
# 只裁剪传送带所在的中间区域roi = frame[200:800, 400:1500]result = model(roi)3. 跳帧策略
Section titled “3. 跳帧策略”并非每一帧都需要做完整推理。可以交替执行轻量推理(每帧)和重量推理(每 N 帧):
frame_count = 0skip_interval = 3  # 每 3 帧做一次完整推理
while True:    ret, frame = cap.read()    frame_count += 1
    if frame_count % skip_interval == 0:        last_result = heavy_model(frame)  # 重量模型:YOLO 检测    else:        last_result = light_tracker(frame, last_result)  # 轻量跟踪:延续上次结果
4. 异步推理(推理与解码并行)
Section titled “4. 异步推理(推理与解码并行)”把解码和推理放在不同线程,用队列连接,使二者并行执行:
import threadingimport queue
frame_queue = queue.Queue(maxsize=2)  # 限制队列长度防止积压
def decode_thread(rtsp_url):    """线程 A:持续解码最新帧"""    cap = cv2.VideoCapture(rtsp_url, cv2.CAP_FFMPEG)    while True:        ret, frame = cap.read()        if ret:            # 队列满时丢弃旧帧,只保留最新            if frame_queue.full():                try:                    frame_queue.get_nowait()                except queue.Empty:                    pass            frame_queue.put(frame)
def inference_thread():    """线程 B:从队列取帧做推理"""    while True:        frame = frame_queue.get()        result = model(frame)        # 处理 result...
threading.Thread(target=decode_thread, args=(rtsp_url,), daemon=True).start()threading.Thread(target=inference_thread, daemon=True).start()工业控制场景中,延迟(latency)可能比吞吐量更重要——机械臂引导要求端到端延迟在 100ms 以内。延迟控制的核心原则是永不积压。
帧缓冲策略:只处理最新帧
Section titled “帧缓冲策略:只处理最新帧”如前述线程池方案所示,缓冲区设计为”只保留最新帧”。如果用传统的 Queue 把所有解码帧都缓存起来,推理处理不过来时队列会越来越长,延迟线性增长——这是新手最常犯的错误。
经验法则:缓冲区长度永远设为 1(或最多 2)。宁可丢帧,不要积压。工业视觉中”丢失几帧”远比”延迟 2 秒”可接受。
零拷贝(Zero-copy)
Section titled “零拷贝(Zero-copy)”在 GPU 推理场景中,CPU 和 GPU 之间的数据拷贝(cudaMemcpy)是显著的延迟来源。零拷贝技术让解码后的帧直接留在 GPU 显存中,推理时无需搬运:
Pipeline 并行
Section titled “Pipeline 并行”将整个链路拆分为多个 stage(解码 → 预处理 → 推理 → 后处理),每个 stage 在独立线程/GPU stream 上运行,像工厂流水线一样重叠执行,从而把端到端延迟从”各阶段之和”降到”最慢阶段的时间”。
工业摄像头部署在现场,网络抖动、摄像头重启、交换机过载都可能导致 RTSP 流断开。系统必须能自动检测断流并重连,否则需要人工巡检干预。
定期检查 cap.isOpened() 和 cap.read() 的返回值。如果连续 N 次读取失败,判定为断流:
import time
class ReconnectingCapture:    """带自动重连的 RTSP 捕获器"""    def __init__(self, rtsp_url, max_retries=5):        self.rtsp_url = rtsp_url        self.max_retries = max_retries        self.cap = None        self.consecutive_failures = 0        self._connect()
    def _connect(self):        if self.cap is not None:            self.cap.release()        self.cap = cv2.VideoCapture(self.rtsp_url, cv2.CAP_FFMPEG)
    def read(self):        """读取一帧。失败时自动重连(指数退避)。"""        for attempt in range(self.max_retries):            ret, frame = self.cap.read()            if ret:                self.consecutive_failures = 0                return True, frame
            self.consecutive_failures += 1            # 指数退避:1s, 2s, 4s, 8s, 16s ...            backoff = 2 ** attempt            print(f"断流!第 {attempt + 1}/{self.max_retries} 次重连,"                  f"等待 {backoff}s ...")            time.sleep(backoff)            self._connect()
        print("重连失败,放弃此路流。")        return False, None
# 使用capture = ReconnectingCapture("rtsp://admin:pass@192.168.1.100/stream")while True:    ret, frame = capture.read()    if ret:        result = model(frame)
指数退避(Exponential Backoff)
Section titled “指数退避(Exponential Backoff)”重连时不能以固定频率疯狂重试——如果交换机宕机了,所有摄像头同时疯狂重连只会让情况更糟(“惊群效应”)。指数退避策略让重连间隔随失败次数翻倍( 秒),既保证最终能恢复,又避免重连风暴。
2025–2026 最新进展
Section titled “2025–2026 最新进展”- NVIDIA DeepStream 7.x:引入对新一代 Blackwell GPU 的支持,单卡可同时解码 + 推理 60+ 路 1080p 流;新增对 H.265 / AV1 硬件解码的完整支持,降低带宽消耗。
- AV1 编码普及:新一代工业摄像头开始支持 AV1 编码,同等画质下码率比 H.265 再降 30%,对多路高分辨率场景的带宽压力缓解明显。FFmpeg 7.0+ 已稳定支持 AV1 的 libdav1d / libsvtav1 解码/编码。
- 边缘 AI SoC 视觉能力集成:NVIDIA Jetson Orin Nano / Orin NX、瑞芯微 RK3588 等边缘平台将 ISP(图像信号处理器)、硬件编解码器和 NPU 集成在同一芯片上,实现了从传感器到推理的全链路零拷贝,功耗低至 5–15W。
- GStreamer 1.24+:改进了
nvstreammux的零拷贝路径,减少了一次 GPU→CPU→GPU 中转,多路管线延迟降低 15–20%。 - AI 辅助摄像头标定:基于 AR 标定板 + SLAM 的自动标定工具链(如 OpenCV 5.x 的
cv2.aruco增强)大幅降低了多相机系统的标定成本,工业现场部署时间从数小时缩短到分钟级。 - 视频大模型(Video LLM)进入工业:2025 年起,Video-LLaVA、Gemini 等视频理解大模型开始在高端质检场景试点,能直接对一段视频做自然语言推理(“这段视频中零件是否有划痕”),挑战传统”逐帧检测”范式。
| 术语 | 英文全称 | 释义 |
|---|---|---|
| 工业视觉 | Industrial Vision / Machine Vision | 用摄像头和算法让机器”看见”并理解工业场景 |
| 模板匹配 | Template Matching | 用模板图在大图中滑动搜索匹配位置的定位算法 |
| 形态学操作 | Morphological Operations | 用结构元素对图像做腐蚀/膨胀等操作的图像处理方法 |
| ROI | Region of Interest | 感兴趣区域,图像中只处理特定部分以减少计算量 |
| RTSP | Real-Time Streaming Protocol | 实时流传输协议,工业摄像头最常用的视频流协议 |
| RTP | Real-time Transport Protocol | 实际承载音视频数据的传输层协议,通常配合 RTSP 使用 |
| NVDEC | NVIDIA Decoder | NVIDIA GPU 的专用硬件解码引擎 |
| NVENC | NVIDIA Encoder | NVIDIA GPU 的专用硬件编码引擎 |
| 零拷贝 | Zero-copy | 数据在 GPU 显存中直接流转,避免 CPU-GPU 间反复拷贝 |
| 指数退避 | Exponential Backoff | 重连间隔随失败次数指数增长的重试策略 |
| DeepStream | NVIDIA DeepStream SDK | NVIDIA 的高性能视频分析管线 SDK |
| GStreamer | — | 模块化的开源多媒体管线框架 |
| 开运算 | Opening | 先腐蚀后膨胀,去除小噪点 |
| 闭运算 | Closing | 先膨胀后腐蚀,填充小孔洞 |
| Canny | Canny Edge Detector | 多步骤边缘检测算法 |
| 端到端延迟 | End-to-end Latency | 从图像采集到决策输出的总耗时 |