
使用语义分割导航(SAM3,AMD Strix Halo)
本教程介绍如何在边缘端为 Nav2 运行一个实时的、可通过文本提示(text-promptable)的语义分割代价地图。方案使用 Meta 的 SAM3 基础模型,运行在 AMD Strix Halo 上。完成本教程后,你将获得:
- 一个在 Strix Halo GPU 上运行、以 5–10 Hz 发布高分辨率逐像素类别掩码的 SAM3 推理节点。
- 一个配置好的 Nav2 栈,通过 semantic_segmentation_layer 代价地图插件接收这些掩码,并根据地形和/或障碍物类型设置代价。
- 基于地形语义、难以察觉的小障碍物、动态智能体等进行规划和控制的能力。
SAM3 的核心优势在于文本提示:你告诉它要找什么(「person」「pallet」「wet floor sign」「curb」「mud」「ceiling」……),它就会为每个类别返回掩码。 无需针对每个类别单独训练。 同一模型即可处理室内地板、室外地形、自行车道和各种障碍物——只需编辑一个字符串列表,就能让代价地图适应新环境。
为什么选择 SAM3 + 为什么选择 Strix Halo
Section titled “为什么选择 SAM3 + 为什么选择 Strix Halo”传统的导航感知只能告诉你障碍物在哪里(来自深度相机或激光雷达),却无法告诉你它们是什么,也不知机器人该如何应对。 它在处理薄、低矮物体(电缆、路缘、碎片、液体泼洒物)以及超出深度传感器有效范围的目标时也力不从心。 语义分割通过对彩色图像的每个像素打标签来弥补这一空白,即使深度数据有噪声或缺失也能正常工作。
SAM3 的新颖之处在于文本提示。
旧的分割网络在训练时就固定了类别列表,想添加新物体就需要收集数据并重新训练。
SAM3 则接收描述分割内容的任意字符串,可以是完整的句子或短语。
「类别列表」就是你在启动参数中输入的内容,还能在运行时通过 ~/change_prompt 服务更改。
这一关键特性使得单一模型无需重新训练即可应用于仓库、人行道、农场和建筑工地。
这使得相机数据流变为机器人环境的实时、本地运行的文本/图像分割,Nav2 可据此进行地形感知导航、检测小的或难以察觉的障碍物、感知不断变化的情境上下文、处理动态障碍物等。
- 在规划和控制中对不同表面做出权衡。例如优先走人行道而非草地(同时严格避开街道),优先选择开阔区域而非狭窄通道,尽量避开泼洒物或水坑等。
- 以通用方式检测地面上的小物体(如电缆、碎片),或距离较远、难以被深度相机或激光雷达捕捉但对应用很重要的物体,无需预先枚举所有可能遇到的物体。
- 根据机器人当前所处情境做出决策,以调整行为或算法。例如判断是处于狭窄空间还是开阔空间,是否在接近另一个机器人/人/车辆,或以不同方式对待特定物体。这在行为树中可能很有用。
- 无需针对每种类型单独训练即可找到常见的动态物体,将其从静态场景中移除,用于改进动态跟踪和/或定位。
- 用途还有很多。只要合理设计,就可集成到行为树、导航算法或代价地图层中,尤其适合特定应用场景。
在机器人上以 5–10 Hz 运行服务器级基础模型是另一个核心挑战。 AMD Strix Halo(Ryzen AI Max+ 395)将 NPU 和 Radeon GPU 与 32 个 x86 内核及统一内存封装在单个芯片中,因此 SAM3 无需外部加速器即可在边缘端运行。 同样的算力还可用于现代机器人可能需要在本地运行的其他任务(如检测器、VLM、VLA、LLM、规划器),无需额外配备 GPU 设备。 Strix Halo 拥有与高端 AMD 笔记本电脑相当的 CPU 算力,以及与 Jetson 相当的 GPU 算力,两者的结合使这一切成为可能。
本教程假定你已经具备:
- 运行 Ubuntu 的 AMD Strix Halo。我们使用 GMKtec EVO-X2 AI Mini PC
- 已安装 ROS 2 Jazzy 或更新版本
- 配备深度或立体相机的机器人平台。我们使用 Orbbec Gemini 355 和 Intel RealSense 系列,更大的视场角(FOV)和视差会更有优势。
- 用于运行 SAM3 的
conda/miniforgePython 环境。安装说明:miniforge。
该流水线接收来自相机的同步且已对齐的 RGB 图像和点云,运行 SAM3 推理以生成类别标签掩码。
随后,label_mask 与点云一起被缩小到较低分辨率,传递给代价地图层进行处理。
缩小标签掩码并非必需,但这是降低代价地图层计算负载的常见做法。
对于 3–10 米范围的局部代价地图,以约 2–5 厘米分辨率的栅格使用 504×504 或 1008×1008 的掩码几乎没有意义。
大约 400×200 或更小就足够了。
最终,规划器和控制器利用带有语义标注的代价地图栅格及其关联代价来影响导航行为——阻止经过某些空间,优先选择某些表面,或以特定方式对待某些物体。
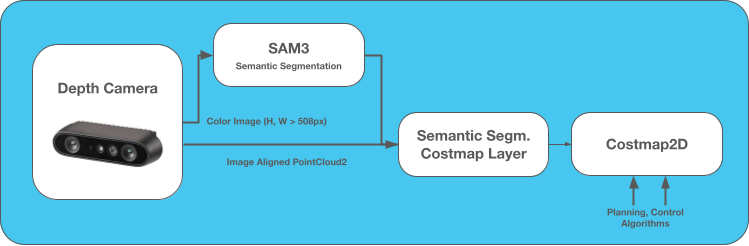
如果你的传感器不输出配准的 RGB + 深度数据,sensor_processing_pipeline.launch.py 可以为你完成降采样和对齐。
SAM3 节点本身只需要一个彩色图像话题作为输入;配准的点云则用于代价地图层。
SAM3 节点订阅彩色图像话题,运行检测以及可选的跟踪器(在完整检测间隔期间运行),然后发布:
~/label_mask(sensor_msgs/Image,mono8)像素值 = 类别 ID,0 表示「未检测到」。~/label_info(vision_msgs/LabelInfo)类别 ID 到类别名称的映射,供下游使用。~/segmentation_mask(sensor_msgs/Image,rgb8)源帧的按类别着色叠加层,用于调试和演示。
语义代价地图层接收这三路数据:掩码、标签和配准的点云。
它使用点云将每个带标签的掩码像素投影到 3D 空间,并在每个代价地图瓦片上累积观测以设置其类别类型。
在内部,semantic_segmentation_layer 维护一个瓦片地图(tile map),在滑动窗口内存储这些观测,用于填充代价地图。
0- 克隆仓库
Section titled “0- 克隆仓库”cd <your_ros2_ws>/srcgit clone --recursive https://github.com/open-navigation/opennav_amd_semantic_navigation.git如果你克隆时没有加 --recursive(为了获取代价地图层子模块):
cd opennav_amd_semantic_navigationgit submodule update --init --recursive1- 安装 ROCm 和 Python 依赖
Section titled “1- 安装 ROCm 和 Python 依赖”opennav_sam3_inference 软件包附带一个一键安装脚本,会安装指定版本的 ROCm 7.2 软件栈、打过补丁的 MIGraphX 2.15、一个包含 ROCm-nightly PyTorch + onnxruntime-migraphx 的 opennav-sam3-inference conda 环境,以及(可选)模型权重。
看起来内容不少,但实质上是安装正确版本的 AMD 软件、AI 优化库和 PyTorch,确保各组件协同工作,避免依赖冲突。
安装脚本内容透明,可直接查看了解其具体操作。
cd <your_ros2_ws>/src/opennav_amd_semantic_navigation/opennav_sam3_inference./setup.sh2- 获取 SAM3 权重
Section titled “2- 获取 SAM3 权重”SAM3 的权重(约 3.3 GB)不随仓库分发,需从 Hugging Face 获取。
如无账户请先注册,然后前往 https://huggingface.co/facebook/sam3 并接受许可协议。
权限传播可能需要几分钟才能生效。
在 https://huggingface.co/settings/tokens 创建 HF_TOKEN,并用 hf auth login 登录。
建议将该令牌导出为环境变量以便日后使用。
最后执行:
hf download facebook/sam3 model.safetensors --local-dir model/sam33- 构建 SAM3 推理产物
Section titled “3- 构建 SAM3 推理产物”SAM3 模型需编译为用于 GPU 的 ONNX/MIGraphX 产物。 每个分辨率只需运行一次,默认的 504 像素输入大约需要 18 分钟。 也可以使用完整的 1008 分辨率,但推理时间更长,而掩码质量几乎没有提升。
conda activate opennav-sam3-inferencecd <your_ros2_ws>/src/opennav_amd_semantic_navigation/opennav_sam3_inference
# 单一分辨率(504 像素约 18 分钟)python scripts/export/build.py --pipeline text --imgsz 504 # 1008 also optional
工作目录中将出现一个包含构建产物的 onnx_files_504/ 目录。
将 model/sam3/ 和 onnx_files_504/ 目录移动到机器上的固定位置(例如 /opt/opennav/sam3/ 或 ~/opennav-sam3-models/)。
编辑 opennav_sam3_inference/config/sam3_inference.yaml,指定权重和构建产物的位置:
sam3_inference: ros__parameters: checkpoint: /absolute/path/to/model/sam3 # contains the model onnx_dir: /absolute/path/to/onnx_files_504 # contains the optimized ONNX files prompts: ["floor", "wall"] class_ids: [1, 2] device: cuda # correct on ROCm - PyTorch reuses CUDA names for HIP score_threshold: 0.5 max_objects_per_prompt: 5 redetect_interval_ms: 0.0 queue_depth: 5 start_enabled: true以下是你最常调整的参数说明:
prompts/class_ids:每个提示对应一个类别,在检测到的每个像素处将匹配的 ID 写入~/label_mask。ID 必须在[1, 255]范围内且唯一(0 保留给「未检测到」)。score_threshold/mask_threshold:完整检测和逐像素二值化的置信度阈值。redetect_interval_ms:每 N 毫秒运行一次完整的 SAM3 检测;其余时间仅进行跟踪。0表示每帧都重新检测;增大该值可降低计算量,但发现新物体的速度会变慢。max_objects_per_prompt:每个提示同时跟踪的实例数量上限。超出上限的实例(得分最低的)会被剔除,跟踪器不再传播它们。
系统还提供了服务(services),用于在运行时启用/禁用或更改提示和类别 ID。
提示设计的一些经验:
提示可以是长短语,将多个物理对象归入同一个 ID——例如 "car, bus, plane, or motorcycle" 是一个提示。
提示越少运行越快,因为 SAM3 会对每个提示逐一处理。尽量合并提示,或善用运行时更改提示的服务。
5- 构建 ROS 2 工作空间
Section titled “5- 构建 ROS 2 工作空间”在 conda 环境中构建 SAM3 推理软件包,确保 SAM3 节点使用正确的 Python。 构建完成后,无需再激活 conda 环境 —— 启动节点时会自动正确处理环境。
conda activate opennav-sam3-inferencesource /opt/ros/jazzy/setup.bashcd <your_ros2_ws>colcon build --packages-select \ opennav_sam3_inferenceconda deactivate其余软件包可以在 conda 环境内或外构建。 通常建议在环境外构建。
cd <your_ros2_ws>colcon build --packages-skip \ opennav_sam3_inference构建完成后,source 工作空间。
source <your_ros2_ws>/install/setup.bash6- 启动 SAM3 推理节点
Section titled “6- 启动 SAM3 推理节点”ros2 launch opennav_sam3_inference sam3_inference.launch.py \ image_topic:=<your image topic>几秒钟内应能看到三个话题被发布。 可视化分割掩码话题有助于查看检测叠加效果,确认节点正常工作。
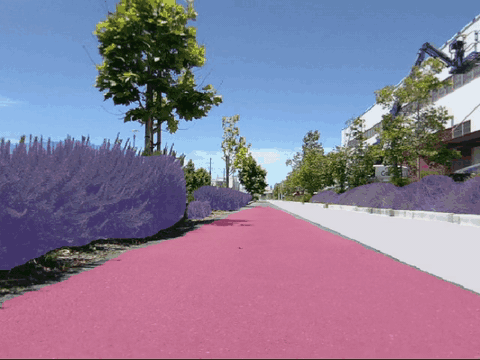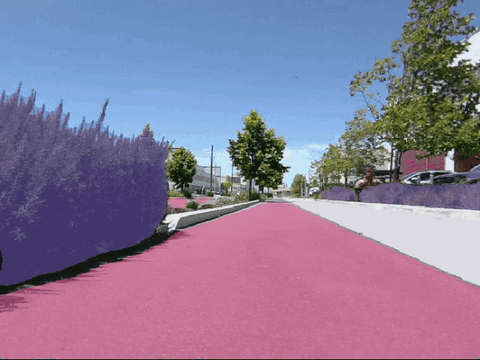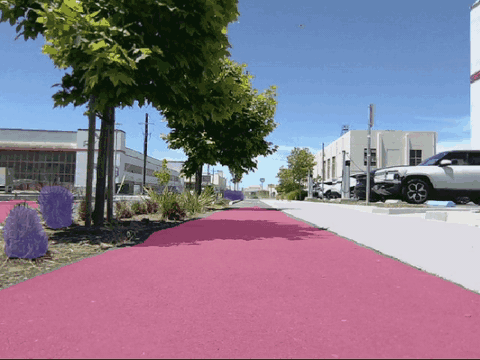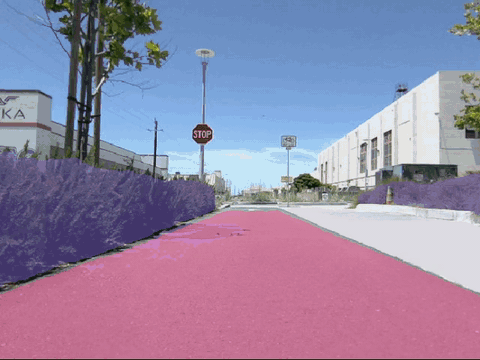
节点正常工作后,接下来关注代价地图集成,以实际利用这些信息。
7- 配置 Nav2 使用该层
Section titled “7- 配置 Nav2 使用该层”opennav_sam3_nav_demo 软件包附带了一个 Nav2 参数文件,已为演示目的预配置了 SAM3 推理节点。
关键部分是代价地图的 plugins 列表和 semantic_segmentation_layer 块。
local_costmap: local_costmap: ros__parameters: plugins: ["semantic_segmentation_layer", "inflation_layer"] semantic_segmentation_layer: plugin: "semantic_segmentation_layer::SemanticSegmentationLayer" enabled: True observation_sources: camera camera: segmentation_topic: "/sam3_inference/resized/label_mask" labels_topic: "/sam3_inference/label_info" pointcloud_topic: "/sensors/camera_0/points_registered" observation_persistence: 0.0 expected_update_rate: 0.0 visualize_tile_map: True use_cost_selection: True max_obstacle_distance: 3.5 min_obstacle_distance: 0.3 tile_map_decay_time: 1.5 class_types: ["traversable", "avoid"] traversable: classes: ["floor"] base_cost: 15 max_cost: 30 mark_confidence: 0 samples_to_max_cost: 20 dominant_priority: False avoid: classes: ["wall", "large static objects like furniture, columns, carts, boxes, or trash cans", "person, dog, or cat"] base_cost: 150 max_cost: 254 mark_confidence: 0 samples_to_max_cost: 20 dominant_priority: False全局代价地图使用相同的层,但 tile_map_decay_time 稍长(3.0 秒),以便地图在更大的 40×40 米窗口内持续存在。
演示还保持 visualize_tile_map: True,方便在 RViz 中查看底层的瓦片观测。
这里将地板设为某个非零的低代价,仅出于演示目的,方便确认其被正确检测并正常工作。 障碍物类别则被设为高代价,作为潜在碰撞风险,迫使规划器和控制器绕行。
该演示有意禁用了所有基于激光雷达或深度的代价地图层(如障碍物层或体素层),以展示纯视觉、纯语义的导航。 生产环境中这样做未必最优——实际应用中语义通常作为补充增强,同时仍需正确避开可检测的障碍物。
8- 启动 Nav2
Section titled “8- 启动 Nav2”保持第 6 步的 SAM3 推理节点在某个终端中运行,在另一个终端中启动 Nav2:
ros2 launch opennav_sam3_nav_demo nav2.launch.py打开 RViz,设置固定坐标系,并发送一个 Nav2Goal。使用默认提示集,应能看到:
- 机器人的地板瓦片被着色为低代价(可通行)。
- 墙壁被着色为高代价(避开),规划器会绕开墙壁规划路径。
真实世界演示
Section titled “真实世界演示”同一套设置,使用三种不同的提示配置,分别应用于三类环境。 每种环境使用的提示和配置详见 GitHub 仓库。 值得注意的是,这类技术还可以在建图过程中有效标注空间,从而获取全局语义数据。
以下演示展示了如何在室内环境中检测可导航表面,以确定安全行驶区域。
仅用 "floor" 就能在办公室环境中准确分割地面。
无需微调或复杂的提示工程,即可绘制出房间的自由空间。
室外场景同理,仅用 "sidewalk cement or pavement" 就能覆盖所有可步行表面,即使是不规则表面也没问题。
还可以使用两个以上类别来获取更丰富的环境语义信息。
例如,第二个演示分割了 ["floor", "wall", "desk", "chair", "shelf or cabinet"],为导航和行为决策提供了对环境更深入的理解。
以下演示展示了如何在室外环境中检测可行驶地面(水泥、铺装路面、人行道),同时避开街道、草地等不可导航表面。
使用 "sidewalk, cement, or pavement" 在公园和街边人行道环境中分割人造表面,并将 "grass or plants" 标记为高代价以避开。
该方案在人行道、沥青路面、混凝土路面甚至碎石路上均表现良好。
SAM3 在无需微调的情况下,即可在多种地形类型和环境中表现出色,这对非结构化环境的导航而言是一项突破。 掩码的准确性、锐利度和一致性相比传统语义分割模型有显著提升,而文本提示能力意味着从第一天起就可以分割出与应用相关的任何类别。
困难的小障碍物
Section titled “困难的小障碍物”前面的演示聚焦于地形。基础模型感知的另一面在于,你可以让 SAM3 检测具体的事物——如地板上的电缆、水坑、碎片、低矮的托盘——而无需为每种物体单独训练检测器。 希望这些示例能带来启发,展示 SAM3 如何在传统上对机器人而言困难的场景中检测和避开障碍物(或调整机器人行为)。
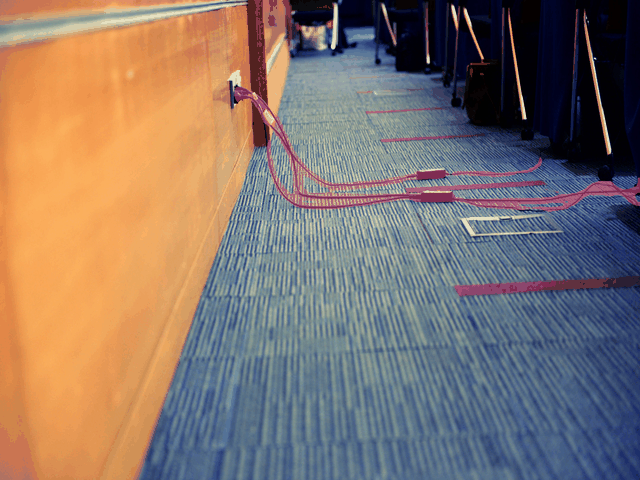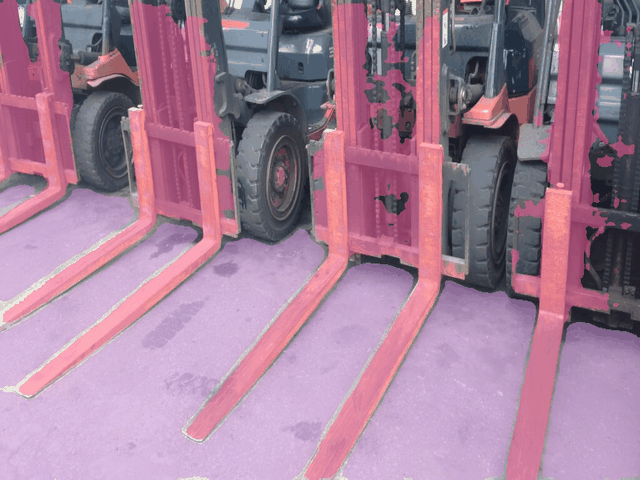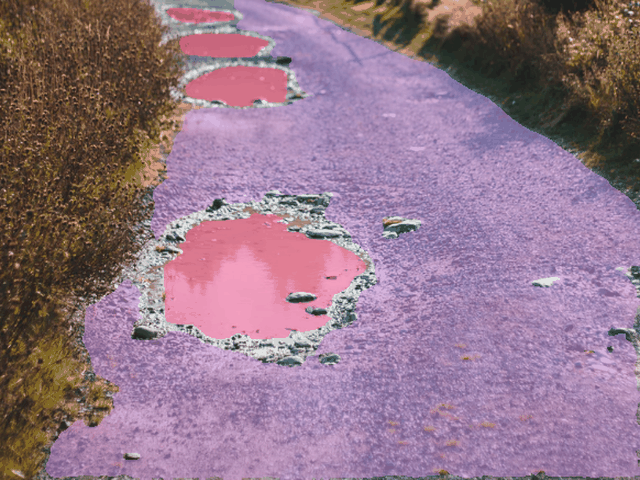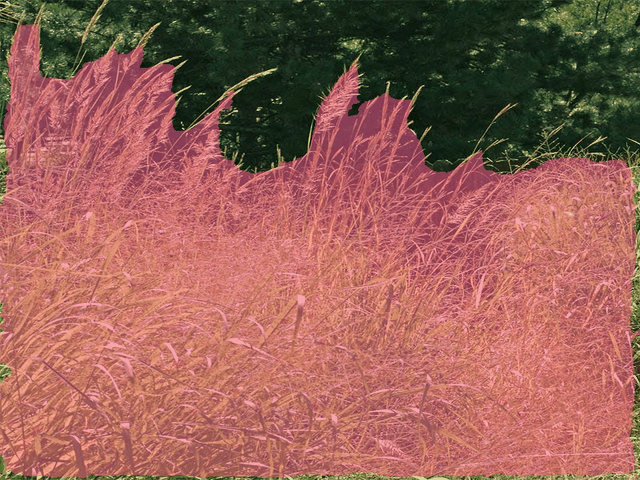
祝分割愉快!