
特征工程
特征工程(Feature Engineering)是把原始数据转化为模型能有效学习的特征的过程。业界有句名言:“数据决定了模型的上限,算法只是逼近这个上限。“特征工程就是那个提升上限的关键环节——垃圾进,垃圾出(Garbage In, Garbage Out,指低质量的数据输入必然导致低质量的模型输出)。本页梳理数值、类别、时间、文本等各类特征的工程化方法与数学原理。前置阅读:传统机器学习概览和监督学习。
一句话定位:如果说模型训练是”高考冲刺”,那么特征工程就是”从小学到高中的十几年知识积累”——它决定了你能冲刺的天花板。
特征工程 = 翻译官 + 厨师。
翻译官:把现实世界的信息翻译成模型能理解的数学语言。模型只懂数字,但现实世界有文字、日期、类别、图像——特征工程就是做这个翻译。
厨师:食材(原始数据)一样,但切法、调味、火候(特征变换)不同,做出来的菜(模型效果)天差地别。好的特征工程就像好厨师,能把普通食材做出米其林效果。
- 数值特征:直接是数字(房价、年龄、温度),但量纲和分布差异巨大——需要标准化(Standardization,将不同尺度的数值转换到统一尺度的过程)或变换,让不同特征在同一尺度上可比。
- 类别特征:“红色""北京""男”——不是数字,需要编码成数字。One-Hot 编码(One-Hot Encoding,将每个类别展开为一个互不重叠的二值列)是最基础的方法,Target Encoding 是竞赛高手的最爱。
- 时间特征:“2024-03-15 14:30:00”对模型来说只是一串字符,但提取出”星期五""下午""接近月末”后,预测价值大增。
- 文本特征:一段评论对模型是字符序列,但提取出 TF-IDF 向量或词嵌入后,就成了可计算的语义特征。
- 交叉特征:单独的”年龄”和”收入”信息有限,但”年龄 收入”的交叉可能揭示”年轻高收入群体”这个关键模式。
- 降维特征:当特征维度很高时(如基因表达谱有上万个维度),通过 PCA 等技术压缩到低维,既能降噪又能加速训练。
深度学习时代,神经网络能自动学习特征表示(如 CNN 自动提取图像特征),大幅减少了手动特征工程的工作量。但对于结构化表格数据(金融风控、推荐系统),手动特征工程仍然是核心竞争力。即便在 2025 年的 LLM 时代,结构化数据的特征工程依然无法被完全替代。
数值特征处理
Section titled “数值特征处理”| 方法 | 公式/说明 | 适用场景 |
|---|---|---|
| Z-Score 标准化 | ,标准化后均值 0、标准差 1 | 大多数 ML 模型的默认预处理,适合近似正态分布 |
| Min-Max 归一化 | ,缩放到 [0, 1] | 需要有界区间的场景(如图像像素) |
| Robust Scaling | ( 为四分位数) | 有离群值时比 Z-Score 更稳健 |
| 对数变换 | 或 | 右偏分布(如收入、点击量),拉平长尾 |
| 分箱(Binning) | 连续值切分成若干区间 | 非线性关系离散化(如年龄分箱后做 One-Hot) |
| 幂变换 | Box-Cox / Yeo-Johnson | 将非正态分布转为近似正态 |
| 多项式特征 | 让线性模型拟合非线性关系 |
为什么需要标准化——数学直觉
Section titled “为什么需要标准化——数学直觉”许多机器学习算法(SVM、KNN、逻辑回归、神经网络)基于距离或梯度来学习。如果不标准化:
- “收入”范围 [3000, 50000],“年龄”范围 [18, 80]。
- 欧氏距离 被”收入”完全主导——年龄维度几乎被忽略。
- 梯度下降中,大量纲特征的梯度也更大,导致优化路径沿该维度来回振荡,收敛缓慢。
从梯度下降的角度推导:线性回归的 MSE 损失为 ,梯度为 。若某个特征 的数值量级远大于其他特征(如收入 ~万级、年龄 ~十级),则对应权重 的梯度量级也远大于其他权重。在固定学习率 下, 更新步长过大、其他权重更新步长过小,优化轨迹呈现”锯齿形”(Zigzag)——靠近大量纲方向的步幅过大,需要极小的学习率才能收敛,而小量纲方向又因步幅太小而学不动。
标准化后各维度方差均为 1,损失函数的等高线从”细长椭圆”变成”接近圆形”,梯度方向直接指向最优解,收敛速度大幅提升。
对数变换的数学原理
Section titled “对数变换的数学原理”许多现实数据呈右偏分布(Right-skewed Distribution,长尾在右侧),如收入、点击量、房价。对数变换 能将右偏分布拉平为近似对称:
- 为什么有效:对数函数在 小时增长快、 大时增长慢——自然地”压缩”了右侧长尾,把极端值拉近。这在数学上等价于改变了数据的尺度:从”加法尺度”(收入差 1000 元对所有人群同等重要)变为”乘法尺度”(收入翻倍同等重要),更符合人类对财富/流量数据的感知规律。
- 为什么用 而非 :当 时 , 保证 时结果为 0,避免无定义。
- Box-Cox 变换:参数化的幂变换族 (), 时退化为对数变换 。通过最大似然估计(Maximum Likelihood Estimation,MLE)找到最优 使数据最接近正态分布——对变换后的数据做正态性检验,选择使似然函数最大的 。
- Yeo-Johnson 变换:Box-Cox 的推广,支持 的数据,更通用。
Box-Cox 的 如何选:scikit-learn 的
PowerTransformer会自动搜索最优 。 表示不变换, 表示取对数, 表示取平方根。 越接近 0,说明原分布右偏越严重。
多项式特征——让线性模型学非线性
Section titled “多项式特征——让线性模型学非线性”线性模型只能学 这样的直线关系,但现实中的关系往往是曲线。多项式特征(Polynomial Features)通过将原始特征做幂次和乘积扩展,让线性模型在扩展后的特征空间中学到非线性关系:
此时线性回归学到的 实际上是一个二次曲面——模型形式仍是”线性”的(对权重 线性),但能拟合非线性数据。这揭示了一个重要思想:特征工程本质上是在扩展假设空间(Hypothesis Space)。
风险提示:多项式特征数量随 degree 和特征数指数增长——degree=3、10 个原始特征会生成 个特征,极易过拟合。务必配合正则化(Ridge / Lasso)使用。
from sklearn.preprocessing import PolynomialFeaturesimport numpy as np
X = np.array([[2, 3], [4, 5], [6, 7]])poly = PolynomialFeatures(degree=2, include_bias=False)X_poly = poly.fit_transform(X)print("原始特征:\n", X)print("多项式特征 (degree=2):\n", X_poly)# 输出: [x1, x2, x1^2, x1*x2, x2^2]# [[ 2, 3, 4, 6, 9],# [ 4, 5, 16, 20, 25],# [ 6, 7, 36, 42, 49]]print("特征名:", poly.get_feature_names_out(["x1", "x2"]))# ['x1', 'x2', 'x1^2', 'x1 x2', 'x2^2']树模型(随机森林、XGBoost)对单调变换不敏感——不需要标准化。但线性模型、SVM、KNN、神经网络都受量纲影响,必须标准化。详见集成学习和SVM。
PCA 降维在特征工程中的角色
Section titled “PCA 降维在特征工程中的角色”当特征维度很高且存在多重共线性(Multicollinearity,多个特征之间高度相关)时,主成分分析(PCA,Principal Component Analysis)是特征工程的重要工具——它不是简单的”砍掉特征”,而是通过正交变换将高维特征投影到方差最大的低维子空间,既压缩了维度又保留了绝大部分信息。
给定中心化(均值归零)后的数据矩阵 ,PCA 的目标是找到一个投影矩阵 ,使得投影后数据的方差最大化:
其中 是协方差矩阵, 是矩阵的迹(Trace,对角元素之和)。用拉格朗日乘子法求解,该优化问题等价于特征值分解:
取协方差矩阵最大的 个特征值 对应的特征向量 作为投影方向(主成分),就得到了降维后的特征 。
方差解释比(Explained Variance Ratio)衡量每个主成分保留了多少信息:
实践中通常选取累计 EVR 达到 95%(或 99%)的最小 。
- 方差 = 信息:PCA 认为”方差越大的方向信息越多”。方差极小的方向往往是噪声,丢弃它们等于去噪。
- 正交去相关:主成分之间两两正交(不相关),消除了原始特征间的冗余——这对线性回归特别重要,因为多重共线性会导致权重估计不稳定。
- 几何图景:想象数据在高维空间中形成一个”椭球”,PCA 就是旋转坐标系让椭球的长轴对齐第一个坐标轴、次长轴对齐第二个坐标轴……这样前几个坐标就能”抓住”数据的主要形状,后面的坐标只是椭球的”薄边”,信息量少。
PCA vs 特征选择:特征选择(Filter/Wrapper/Embedded)是”挑选原始特征”,结果可解释性强;PCA 是”线性组合所有特征生成新特征”,结果是”黑箱”主成分,牺牲了可解释性换取了压缩率和去噪。详见降维技术。
from sklearn.decomposition import PCAfrom sklearn.preprocessing import StandardScalerimport numpy as np
# PCA 前必须标准化——PCA 对量纲敏感X = np.random.randn(1000, 50)  # 1000 样本 × 50 维X_scaled = StandardScaler().fit_transform(X)
pca = PCA(n_components=0.95)  # 保留 95% 方差X_pca = pca.fit_transform(X_scaled)print(f"原始维度: {X.shape[1]} → 降维后: {X_pca.shape[1]}")print(f"累计方差解释比: {pca.explained_variance_ratio_.sum():.2%}")
类别特征编码
Section titled “类别特征编码”| 方法 | 说明 | 优缺点 |
|---|---|---|
| One-Hot 编码 | 每个类别一个二值列 | 简单通用,但高基数特征(如用户 ID)会爆炸 |
| Label Encoding | 每个类别映射到一个整数 | 紧凑,但引入了虚假的大小关系 |
| Target Encoding | 用该类别对应的目标变量均值编码 | 竞赛利器,但需交叉验证防泄露 |
| Frequency Encoding | 用类别出现频率编码 | 简单有效,适合高基数特征 |
| Hash Encoding | 用哈希函数将类别映射到固定维度向量 | 适合超高基数且内存受限场景 |
| CatBoost Encoding | Ordered Target Encoding,有序累加均值 | 天然防泄露,无需交叉验证 |
| 嵌入编码(Entity Embedding) | 用神经网络学习类别的低维向量 | 高基数特征最佳方案,推荐系统常用 |
One-Hot 编码的数学原理
Section titled “One-Hot 编码的数学原理”对于一个有 个可能取值的类别特征,One-Hot 编码将其映射为一个 维的 one-hot 向量——只有对应位置为 1,其余为 0。数学上这是在构建一个正交基(Orthogonal Basis)表示,每个类别占据一个独立维度。
- 优点:不引入虚假的距离关系(“北京”和”上海”之间的距离 = “北京”和”广州”之间的距离 = ),即所有类别两两等距。
- 缺点:当 很大时(如用户 ID 有 100 万个取值),特征空间维度爆炸——导致维度灾难(Curse of Dimensionality,高维空间中数据变得稀疏,距离失去区分力),且多数列全为 0(稀疏矩阵)。
Target Encoding 的数学原理
Section titled “Target Encoding 的数学原理”Target Encoding(又称 Mean Encoding)将类别 编码为该类别在训练集中的目标变量条件期望:
其中 是类别 的样本数, 是全局均值, 是平滑系数。
贝叶斯平滑的推导
Section titled “贝叶斯平滑的推导”为什么公式里有 ? 这来自贝叶斯推断(Bayesian Inference)。
假设目标变量 服从伯努利分布(二分类),类别 的真实转化率为 。我们用 Beta 分布作为 的先验:,其中先验均值 (即先验认为”没有数据时,该类别转化率接近全局均值”)。
观察到 个样本中有 个正例后,后验分布仍为 Beta:。后验均值(即 Target Encoding 值)为:
令 (先验强度),(先验均值),则:
这正是上面给出的平滑公式。直觉:当 很大(该类别样本多)时,(信任数据本身);当 (该类别几乎没有样本)时,(回退到全局均值)。 控制”回退速度”—— 越大,越保守地倾向全局均值。
为什么 Target Encoding 比 One-Hot 更有效:
- One-Hot 将”北京”展开成 1 维向量,信息散布在一个稀疏维度上。
- Target Encoding 将”北京”编码为一个实数(如平均房价 50000),直接编码了类别与目标的关系——信息密度高得多。
数据泄露风险(Data Leakage,预处理时不当使用了测试集/验证集信息,导致评估虚高):如果直接用包含当前样本的全集均值,标签信息会泄露到特征中——模型可能”记住”而非”学习”。必须用 Out-of-Fold (OOF) 交叉验证编码:将训练集分成 K 折,用其他 K-1 折的均值编码当前折,确保编码值不含当前样本的标签信息。
时间特征提取
Section titled “时间特征提取”日期时间看似只有一个字段,但可以提取出大量有预测力的特征:
原始:2024-03-15 14:30:00(周五)提取: - 年/月/日/时/分/秒 → 2024, 3, 15, 14, 30, 0 - 星期几 → 5(周五) - 是否周末 → 0(否) - 是否节假日 → 0(否) - 一年中的第几天 → 75 - 一年中的第几周 → 11 - 一天中的时段 → "下午" - 距离最近节日的天数 → 17(距清明节) - 趋势特征(滞后值/滑动平均)→ 过去7天销量均值完整代码:时间特征提取
Section titled “完整代码:时间特征提取”import pandas as pdimport numpy as np
# 模拟一年的每日销售数据dates = pd.date_range("2024-01-01", "2024-12-31", freq="D")sales = np.random.poisson(lam=100, size=len(dates)) # 日均销量~100df = pd.DataFrame({"date": dates, "sales": sales})
# ① 基础日历特征df["year"] = df["date"].dt.yeardf["month"] = df["date"].dt.monthdf["day"] = df["date"].dt.daydf["dayofweek"] = df["date"].dt.dayofweek # 0=周一, 6=周日df["dayofyear"] = df["date"].dt.dayofyeardf["weekofyear"] = df["date"].dt.isocalendar().weekdf["is_weekend"] = (df["dayofweek"] >= 5).astype(int)
# ② 周期特征的三角编码(让模型理解"周期的连续性")df["month_sin"] = np.sin(2 * np.pi * df["month"] / 12)df["month_cos"] = np.cos(2 * np.pi * df["month"] / 12)df["dow_sin"] = np.sin(2 * np.pi * df["dayofweek"] / 7)df["dow_cos"] = np.cos(2 * np.pi * df["dayofweek"] / 7)
# ③ 趋势/滞后特征(时间序列核心)df["sales_lag_1"] = df["sales"].shift(1) # 昨天销量df["sales_lag_7"] = df["sales"].shift(7) # 上周同一天df["sales_rmean_7"] = df["sales"].rolling(7).mean() # 过去7天均值df["sales_rstd_7"] = df["sales"].rolling(7).std() # 过去7天波动
# ④ 距离特征:距离最近"大促日"的天数big_days = [pd.Timestamp("2024-06-18"), pd.Timestamp("2024-11-11")] # 618, 双11df["days_to_next_promo"] = df["date"].apply( lambda d: min(abs((d - bd).days) for bd in big_days))
print(df[["date", "sales", "dayofweek", "is_weekend", "dow_sin", "sales_lag_7", "sales_rmean_7", "days_to_next_promo"]].head(10))周期特征的三角编码
Section titled “周期特征的三角编码”时间序列的周期特征(日/周/月/年周期)用正弦余弦编码比直接用数字更好。原因:小时数 23 和 0 在数字上差 23,但在时间上是相邻的(只差 1 小时)。直接用数字会让模型误以为它们距离很远。
正弦-余弦编码(Sine-Cosine Encoding)将周期映射到单位圆上的角度:
这样 23 点和 0 点在单位圆上的角度相邻,距离自然就小——正确反映了周期的连续性。Transformer 中的位置编码(Positional Encoding)也用了同样的思路,将序列位置映射到连续的相位空间。
为什么需要两个维度(sin + cos)而非一个:只用 或 会造成信息损失——例如 ,不同时间映射到同一值。sin 和 cos 搭配就相当于 坐标,能唯一确定单位圆上的位置。
| 方法 | 说明 | 适用场景 |
|---|---|---|
| Bag of Words / Count Vectorizer | 统计每个词出现次数 | 基础文本表示 |
| TF-IDF | 词频 逆文档频率,降低常见词权重 | 文本分类/聚类的经典方法 |
| 词嵌入 | word2vec / GloVe 的词向量 | 语义级文本特征 |
| 句子嵌入 | Sentence-BERT / BGE 的句向量 | 现代 NLP 通用方案,详见嵌入模型 |
TF-IDF 的完整数学定义
Section titled “TF-IDF 的完整数学定义”TF-IDF(Term Frequency-Inverse Document Frequency)衡量一个词对文档集中某篇文档的重要程度:
词频 TF 有多种定义,sklearn 默认使用原始词频:
逆文档频率 IDF 的标准定义为:
其中 是文档总数, 是包含词 的文档数。分母 是拉普拉斯平滑(Laplace Smoothing),防止某词出现在所有文档中时出现除零。
sklearn 实际用的是平滑版 IDF(更稳定):
直觉:一个词在很多文档中都出现(如”的""是""在”),IDF 接近 0,权重被压低;一个词只在少数文档中出现(如”随机森林”),IDF 很大,权重高。TF-IDF 自动平衡了词频和区分度。
最终,TF-IDF 向量还会做 L2 归一化(sklearn 默认 norm='l2'),使每篇文档的 TF-IDF 向量长度为 1——这消除了文档长度差异的影响,让向量之间的余弦相似度等于内积。
from sklearn.feature_extraction.text import TfidfVectorizer
docs = [ "随机森林是一种强大的集成学习算法", "梯度提升树在表格数据上表现优异", "随机森林和梯度提升树都是集成学习方法",]vec = TfidfVectorizer()tfidf = vec.fit_transform(docs)print("词汇表:", vec.vocabulary_)print("TF-IDF 矩阵形状:", tfidf.shape) # (3 篇文档, N 个词)print("每篇文档 TF-IDF 向量的 L2 范数:", np.sqrt(tfidf.multiply(tfidf).sum(axis=1).A1)) # 均为 1.0特征并非越多越好——冗余和噪声特征会降低模型性能,还会增加训练时间和过拟合风险。三大方法:
| 类型 | 方法 | 说明 |
|---|---|---|
| Filter(过滤法) | 方差阈值/相关系数/卡方检验/互信息 | 预处理阶段独立于模型,快速筛除无关特征 |
| Wrapper(包裹法) | 前向选择/后向消除/递归特征消除 RFE | 用模型效果来评估特征子集,精度高但慢 |
| Embedded(嵌入法) | L1 正则(Lasso)/树模型 feature_importance | 训练过程中自动选择特征,最实用 |
互信息——比相关系数更通用的指标
Section titled “互信息——比相关系数更通用的指标”皮尔逊相关系数(Pearson Correlation)只能捕捉线性关系,而现实中很多特征与目标的关系是非线性的(如年龄与健康的关系呈 U 型)。互信息(Mutual Information, MI)基于信息论,能捕捉任意类型的关系:
直觉: 衡量”知道 后, 的不确定性减少了多少”。如果 和 独立,则 ,。MI 越大,说明 对预测 越有用。
L1 正则化特征选择的数学原理
Section titled “L1 正则化特征选择的数学原理”Lasso 回归的损失函数加入了 L1 正则化项:
L1 正则化使优化解中很多权重 恰好为零——对应特征被自动剔除。
为什么 L1 产生稀疏解——几何直觉
Section titled “为什么 L1 产生稀疏解——几何直觉”这是一个经典的优化几何问题。Lasso 的约束等价于:
其中 是 L1 范数, 是与 一一对应的预算。L1 约束区域是一个菱形(Diamond,在二维空间中是顶点在坐标轴上的旋转正方形),而 MSE 损失的等高线是同心椭圆。
- 椭圆中心是最小二乘解(无约束最优)。从中心向外扩展,等高线椭圆最先与菱形在顶点处相切——顶点恰好落在坐标轴上,意味着部分权重恰好为零。
- L2 约束区域是圆形,椭圆与圆相切通常在”弧上”而非顶点,所以所有权重都非零——只缩小不归零。
用KKT 条件严格推导:在 处,L1 范数的次梯度(Subgradient)为 中的任意值。只要损失函数在该维度的梯度落在 内, 就是最优解——这正是”不重要特征的权重被精确置零”的数学机制。
相比之下,L2 正则化(Ridge)的约束区域是圆形,最优解倾向于让所有权重都小但非零——不产生稀疏性。
特征重要性分析
Section titled “特征重要性分析”训练完成后,分析”哪些特征最重要”能指导进一步的特征工程和业务理解:
- 树模型 feature_importance(MDI):随机森林/XGBoost 自带,基于分裂带来的不纯度减少(Gini 下降或方差下降)。详见集成学习中的”随机森林特征重要性原理”。MDI 有偏倚问题:高基数特征(取值多)更容易被选为分裂特征,导致重要性虚高。
- Permutation Importance:打乱某个特征的值,看模型性能下降多少——下降越多说明该特征越重要。模型无关(Model-Agnostic),且无 MDI 的高基数偏倚问题。
- SHAP 值:基于博弈论的 Shapley 值(Shapley Value,合作博弈论中公平分配收益的方法),能精确分解每个特征对单个预测的贡献——当前最权威的可解释性方法。详见自动化与可解释性。
特征重要性排序可视化
Section titled “特征重要性排序可视化”以下是一个模拟随机森林 feature_importance_ 输出的特征重要性排序可视化,展示了如何通过设定阈值来筛选高价值特征:
import matplotlibmatplotlib.use("Agg")
import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)
features = [    "transaction_amount",    "login_frequency",    "account_age_days",    "device_count",    "geo_distance",    "txn_velocity_24h",    "merchant_risk_score",    "avg_balance",    "credit_utilization",    "failed_login_count",    "ip_reputation",    "phone_change_freq",]
importance = np.array([    0.18, 0.15, 0.13, 0.11, 0.095, 0.085,    0.07, 0.055, 0.045, 0.035, 0.028, 0.022,])
# Sort descending (most important at top of horizontal bar chart)order = np.argsort(importance)  # ascending → bottom-to-top in barhfeatures_sorted = [features[i] for i in order]importance_sorted = importance[order]
# Colour gradient: darker = more importantnorm = plt.Normalize(importance.min(), importance.max())cmap = plt.cm.viridiscolors = [cmap(norm(v)) for v in importance_sorted]
fig, ax = plt.subplots(figsize=(9, 5.5))
bars = ax.barh(features_sorted, importance_sorted, color=colors, edgecolor="white", linewidth=0.5)
# Value labels at end of each barfor bar, val in zip(bars, importance_sorted):    ax.text(        bar.get_width() + 0.003,        bar.get_y() + bar.get_height() / 2,        f"{val:.3f}",        va="center", fontsize=8, color="#333",    )
# Selection threshold linethreshold = 0.05ax.axvline(threshold, color="#e53935", linestyle="--", linewidth=1.5, zorder=5)ax.text(    threshold + 0.002, len(features) - 0.5,    "Selection Threshold (0.05)",    color="#e53935", fontsize=9, fontweight="bold", va="top",)
ax.set_xlabel("Feature Importance (MDI)", fontsize=10)ax.set_title("Feature Importance Ranking (Simulated Random Forest)", fontsize=12, fontweight="bold")ax.set_xlim(0, max(importance) * 1.25)ax.spines["top"].set_visible(False)ax.spines["right"].set_visible(False)
# Colourbarsm = plt.cm.ScalarMappable(cmap=cmap, norm=norm)sm.set_array([])cbar = fig.colorbar(sm, ax=ax, fraction=0.025, pad=0.12)cbar.set_label("Importance", fontsize=9)
plt.tight_layout()plt.savefig(    "static/img/generated/feature-engineering-importance.png",    dpi=180,    bbox_inches="tight",    facecolor="white",)plt.close()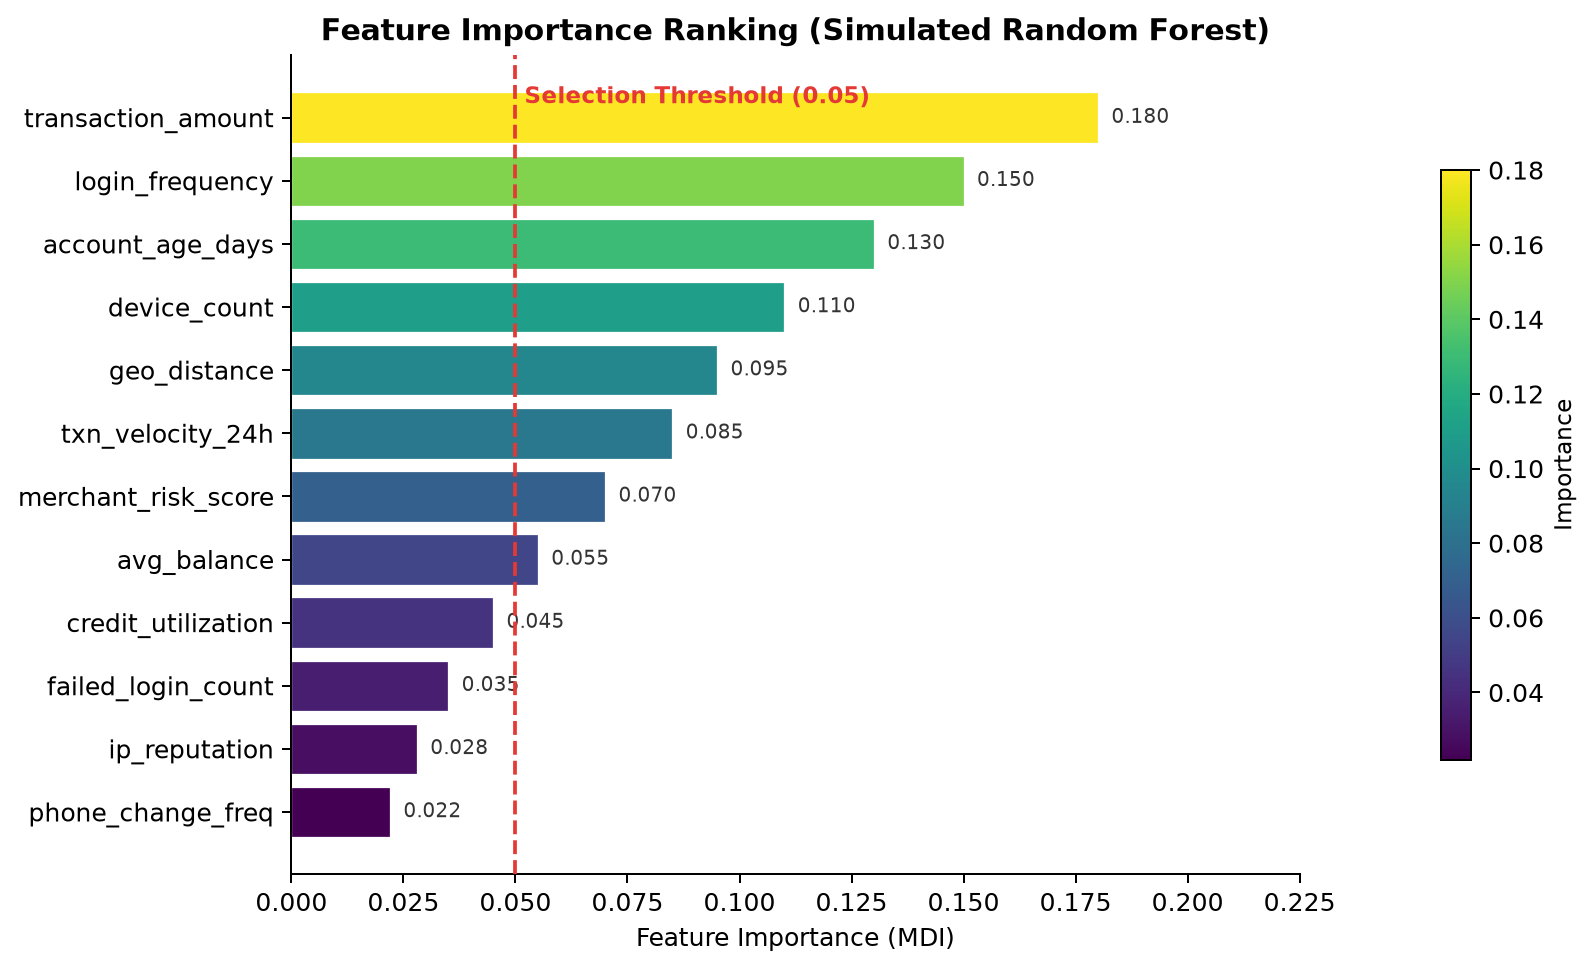
特征工程不是一次性的流水线,而是一个迭代闭环——模型训练后的特征重要性分析会告诉你”哪些特征没用""哪些方向值得深挖”,从而指导下一轮特征变换。
pandas + sklearn 特征工程 Pipeline
Section titled “pandas + sklearn 特征工程 Pipeline”import pandas as pdfrom sklearn.preprocessing import StandardScaler, OneHotEncoderfrom sklearn.impute import SimpleImputerfrom sklearn.compose import ColumnTransformerfrom sklearn.pipeline import Pipelinefrom sklearn.ensemble import RandomForestClassifier
# 模拟数据:数值特征 + 类别特征 + 时间特征df = pd.DataFrame({ "年龄": [25, 30, None, 45], "收入": [8000, 15000, 6000, 25000], "城市": ["北京", "上海", "广州", "北京"], "购买": [0, 1, 0, 1],})
# 数值特征:中位数填充 + 标准化;类别特征:众数填充 + One-Hotpreprocessor = ColumnTransformer([ ("num", Pipeline([("imp", SimpleImputer(strategy="median")), ("sc", StandardScaler())]), ["年龄", "收入"]), ("cat", Pipeline([("imp", SimpleImputer(strategy="most_frequent")), ("ohe", OneHotEncoder(handle_unknown="ignore"))]), ["城市"]),])# 完整 Pipeline:预处理 + 模型一步到位,防止数据泄露pipe = Pipeline([("pre", preprocessor), ("clf", RandomForestClassifier())])pipe.fit(df[["年龄", "收入", "城市"]], df["购买"])print("特征工程+建模 Pipeline 搭建完成")将预处理和模型放入同一个 Pipeline 是最佳实践——确保训练和预测使用相同的变换,避免数据泄露(如用全集均值标准化再交叉验证会泄露测试集信息)。Pipeline 是防泄露的”安全网”:scikit-ensure 会在
fit时只学训练集的统计量(均值、方差、类别集等),在transform/predict时复用——即使你手动传入了测试集,也不会污染统计量。
Target Encoding 防泄露实现
Section titled “Target Encoding 防泄露实现”import numpy as npimport pandas as pdfrom sklearn.model_selection import KFold
def target_encode_kfold(series, target, n_splits=5, smoothing=10): """Out-of-Fold Target Encoding——交叉验证防泄露""" global_mean = target.mean() encoded = np.full(len(series), global_mean, dtype=float) # 默认填全局均值 kf = KFold(n_splits=n_splits, shuffle=True, random_state=42)
for train_idx, val_idx in kf.split(series): # 用训练折计算各类别均值(加贝叶斯平滑) train_df = pd.DataFrame({"cat": series.iloc[train_idx], "y": target.iloc[train_idx]}) agg = train_df.groupby("cat")["y"].agg(["mean", "count"]) smooth = (agg["mean"] * agg["count"] + global_mean * smoothing) / (agg["count"] + smoothing) # 编码验证折——不包含验证折自身的标签信息 encoded[val_idx] = series.iloc[val_idx].map(smooth).fillna(global_mean).values
return encoded
# 示例用法df = pd.DataFrame({"城市": ["北京"]*100 + ["上海"]*100 + ["广州"]*100, "购买": np.concatenate([np.random.binomial(1, 0.7, 100), # 北京转化率 70% np.random.binomial(1, 0.3, 100), # 上海转化率 30% np.random.binomial(1, 0.5, 100)])})df["城市_TE"] = target_encode_kfold(df["城市"], df["购买"])print(df.groupby("城市")["城市_TE"].mean()) # 北京≈0.7, 上海≈0.3, 广州≈0.5为什么 OOF 如此关键:假设”北京”这个类别只有 5 个样本,其中 4 个标签为 1。如果直接用全集均值 编码,模型就能从特征值 0.8 “猜出”标签很可能是 1——这就是泄露。OOF 编码时,每个样本的编码值来自不包含它自身的其他 4 折,标签信息不会泄露。
PolynomialFeatures + 正则化:用线性模型拟合非线性
Section titled “PolynomialFeatures + 正则化:用线性模型拟合非线性”import numpy as npfrom sklearn.preprocessing import PolynomialFeatures, StandardScalerfrom sklearn.linear_model import Ridgefrom sklearn.pipeline import Pipelinefrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import r2_score
# 造一个非线性数据:y = 2*x^3 - 5*x^2 + x + noisenp.random.seed(42)X = np.sort(np.random.uniform(-3, 3, 200)).reshape(-1, 1)y = 2 * X.ravel()**3 - 5 * X.ravel()**2 + X.ravel() + np.random.normal(0, 3, 200)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
# 纯线性回归 → 多项式回归(degree=3)+ Ridge 正则化model = Pipeline([ ("poly", PolynomialFeatures(degree=3, include_bias=False)), ("scaler", StandardScaler()), ("ridge", Ridge(alpha=1.0)),])model.fit(X_train, y_train)print(f"多项式回归 R²: {r2_score(y_test, model.predict(X_test)):.3f}")
# 对比:纯线性回归from sklearn.linear_model import LinearRegressionlinear = LinearRegression().fit(X_train, y_train)print(f"纯线性回归 R²: {r2_score(y_test, linear.predict(X_test)):.3f}")完整流程版:划分 → Pipeline 训练 → 评估 → 预测新样本
Section titled “完整流程版:划分 → Pipeline 训练 → 评估 → 预测新样本”上面的骨架只演示了结构。真实任务要跑完整链路——用 sklearn 自带数据模拟”数值 + 类别”混合特征,一次跑通:
import pandas as pdfrom sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScaler, OneHotEncoderfrom sklearn.compose import ColumnTransformerfrom sklearn.pipeline import Pipelinefrom sklearn.ensemble import RandomForestClassifierfrom sklearn.metrics import accuracy_score
# 第 1 步:加载数据,并"造"出一个类别特征(现实数据常是数值 + 类别混合)iris = load_iris()df = pd.DataFrame(iris.data, columns=iris.feature_names)df["大小"] = pd.cut(df["sepal width (cm)"], bins=3, labels=["小", "中", "大"])
X = df[["sepal length (cm)", "sepal width (cm)", "petal length (cm)", "petal width (cm)", "大小"]]y = iris.target
# 第 2 步:划分训练集 / 测试集X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
# 第 3 步:预处理规则——数值列标准化,类别列 One-Hotpreprocessor = ColumnTransformer([    ("num", StandardScaler(),     ["sepal length (cm)", "sepal width (cm)", "petal length (cm)", "petal width (cm)"]),    ("cat", OneHotEncoder(handle_unknown="ignore"), ["大小"]),])
# 第 4 步:预处理 + 模型放进同一个 Pipeline(训练时只学训练集的统计量)pipe = Pipeline([("pre", preprocessor), ("clf", RandomForestClassifier(random_state=42))])pipe.fit(X_train, y_train)
# 第 5 步:评估pred = pipe.predict(X_test)print(f"测试集准确率: {accuracy_score(y_test, pred):.2%}")
# 第 6 步:预测新样本——Pipeline 自动完成标准化和 One-Hot,无需手工处理new = pd.DataFrame({    "sepal length (cm)": [5.1], "sepal width (cm)": [3.5],    "petal length (cm)": [1.4], "petal width (cm)": [0.2], "大小": ["小"],})print(f"新样本预测类别: {iris.target_names[pipe.predict(new)[0]]}")
对比两个 demo:前者重在看清
ColumnTransformer的结构,后者是可直接运行的完整流程。日常开发直接以第二个为模板,把数据集和列名换成你的即可。
自动化特征工程
Section titled “自动化特征工程”Deep Feature Synthesis(DFS)
Section titled “Deep Feature Synthesis(DFS)”featuretools 库的核心算法是 Deep Feature Synthesis(DFS),它能自动从多张关联表中生成大量交叉特征:
- 原理:给定表之间的外键关系(如”用户表 → 订单表 → 商品表”),DFS 递归地沿关系路径做聚合操作(mean/sum/count/max/min/std),自动生成如”用户过去 30 天平均消费金额""用户购买商品种类数”等深度特征。
- 特征基元(Primitives):预定义的变换函数(如
add、multiply、diff)和聚合函数(如sum、mean),用户可自定义。 - 深度控制:
max_depth参数控制特征递归深度——深度越大生成的特征越复杂,但也越多噪声。
# featuretools 自动化特征工程示例import featuretools as ftimport pandas as pd
# 模拟数据:用户表和订单表users = pd.DataFrame({"user_id": [1, 2, 3], "age": [25, 30, 45]})orders = pd.DataFrame({    "order_id": [101, 102, 103, 104, 105],    "user_id": [1, 1, 2, 2, 3],    "amount": [100, 200, 50, 300, 150],})
es = ft.EntitySet(id="ecommerce")es = es.add_dataframe(dataframe=users, dataframe_name="users", index="user_id")es = es.add_dataframe(dataframe=orders, dataframe_name="orders", index="order_id")es = es.add_relationship("users.user_id", "orders.user_id")  # 一对多关系
# 自动生成特征:每个用户的订单数、总消费、平均消费等feature_matrix, feature_defs = ft.dfs(    entityset=es, target_dataframe_name="users", max_depth=2,)print(feature_matrix)# 输出包含: age, orders.COUNT(orders), orders.SUM(amount), orders.MEAN(amount) 等
自动化特征工程的陷阱:生成的特征数量爆炸(可能数百上千个),其中大量是噪声——必须配合特征选择(如 L1 正则、树模型 importance)筛除无效特征。
LLM 辅助的自动特征工程(2024-2026 新范式)
Section titled “LLM 辅助的自动特征工程(2024-2026 新范式)”传统自动化特征工程(featuretools DFS)本质是”暴力组合”——在所有特征上穷举加减乘除和聚合,生成的特征数量爆炸且多数无业务含义。2024-2026 年,LLM 辅助特征工程开辟了新路径:
- 语义理解:LLM 能理解列名的语义,生成符合业务逻辑的衍生特征。例如看到
birth_date和apply_date,LLM 能自动推导出age = (apply_date - birth_date).days / 365;看到height和weight,能推导出 ;看到monthly_salary,能推导出annual_salary = monthly_salary * 12。 - 数据探索辅助:LLM 可以自动分析数据分布、检测异常、建议有用的特征变换——相当于一个 7×24 小时待命的数据科学助手。
- 代表项目:开源项目如 OpenFE(用 boosting tree 引导 LLM 生成特征)、SafeAutoFE(强调防泄露的自动特征工程)、以及 AutoGluon 的多模态自动特征生成。
# 概念示例:用 LLM 辅助生成特征(伪代码,需配合 LangChain 或类似框架)import pandas as pd
df = pd.DataFrame({    "birth_date": ["1990-05-15", "1985-11-20", "2000-03-01"],    "apply_date": ["2024-08-01", "2024-08-01", "2024-08-01"],    "height_cm": [175, 160, 180],    "weight_kg": [70, 55, 85],})
prompt = f"""你是特征工程专家。以下是数据列:{list(df.columns)}请生成 5 个有业务意义的衍生特征,输出可直接执行的 pandas 代码。"""
# LLM 会输出类似:df["age"] = (pd.to_datetime(df["apply_date"]) - pd.to_datetime(df["birth_date"])).dt.days / 365df["bmi"] = df["weight_kg"] / (df["height_cm"] / 100) ** 2# ... LLM 能根据列名语义自动推导出这些"人类才会想到"的特征
LLM vs 传统自动化:DFS 是”排列组合所有可能”,LLM 是”像人类专家一样思考”。DFS 生成 1000 个候选特征里可能有 5 个有用;LLM 生成 10 个候选特征里可能有 8 个有用。但 LLM 生成的特征仍需经过模型验证——“语义合理”不等于”统计有效”。
- 防止数据泄露:所有特征变换(标准化、Target Encoding)必须用训练集的统计量,不能碰测试集。用 sklearn Pipeline 能自动保证。
- Target Encoding 必须交叉验证:用 out-of-fold 均值编码,否则标签信息泄露导致过拟合——这是 Kaggle 竞赛最常见的陷阱。
- 高基数类别用嵌入:用户 ID、商品 ID 这类上万值的类别,One-Hot 不可行,用 Entity Embedding 或频率编码。
- 先建基线再迭代:先用最简单的特征(原始数值 + One-Hot)建基线模型,再逐步加特征工程,每次评估增量收益——不要一开始就过度工程。
- 树模型免标准化:随机森林/XGBoost 基于分裂阈值,不受量纲影响,数值特征可以直接喂——但类别特征仍需编码。
- 自动化特征工程需配合特征选择:featuretools 能自动生成大量交叉特征,但会产生大量噪声特征,需配合特征选择使用。
- 类别特征编码要考虑模型类型:树模型(XGBoost/LightGBM)可以接受 Label Encoding 或内置类别处理;线性模型和神经网络需要 One-Hot 或 Target Encoding。
- PCA 不是万能降维:PCA 是线性方法,对非线性结构(如流形)效果差——此时考虑 UMAP/t-SNE(仅可视化)或自编码器。
- 时序特征注意因果关系:滞后/滑动窗口特征必须只用”过去”的数据,不能用”未来”——否则又是数据泄露。
- Kaggle 竞赛核心技能:结构化数据竞赛中,特征工程往往比模型选择更决定排名——冠军方案的特征工程通常极其精细。例如 Home Credit Default Risk 竞赛中,冠军方案的数百个衍生特征(信用比率、逾期天数、近期申请数)是制胜关键。
- 金融风控:信用评分模型中,用户行为特征(还款频率、消费模式、社交网络)的工程化是核心竞争力。一个经典衍生特征是”最近 6 个月逾期次数 / 最近 6 个月还款次数”——这个比率比原始的逾期次数更有预测力。详见异常检测。
- 推荐系统:用户特征(年龄/兴趣/历史行为)和商品特征(类别/价格/热度)的交叉工程是推荐效果的关键。例如”用户最近 7 天点击该类目次数 该类目热度”就是重要的交叉特征。详见推荐系统。
- 销售预测:提取节假日、促销周期、天气等时间特征,大幅提升销量预测精度。一家便利店连锁在加入”距离最近节假日天数""是否发薪日”特征后,日销量预测误差降低了 15%。详见时间序列。
- NLP 文本分类:将评论/新闻提取 TF-IDF 或嵌入特征后送入分类器——特征质量决定分类效果。2025 年的通用做法是直接用 Sentence-BERT/BGE 的句向量替代 TF-IDF,效果显著提升。详见嵌入模型。
- 医疗诊断:从电子病历中提取”最近 3 次血压变化趋势""用药种类数""距上次住院天数”等特征,用于再入院风险预测。这类特征需要领域知识(Domain Knowledge)才能设计——LLM 辅助特征工程在这里大有可为。
- 电商搜索排序:将商品标题用 BERT 编码为语义向量,与价格、销量、点击率等表格特征拼接,送入 GBDT 或深度排序模型——多模态特征工程是 2025 年电商搜索的主流方案。
2025-2026 前沿趋势
Section titled “2025-2026 前沿趋势”LLM 驱动的自动特征工程
Section titled “LLM 驱动的自动特征工程”2024-2025 年的研究热点——用大语言模型(如 GPT-4、Claude、DeepSeek)自动理解表格列的语义,自动生成有意义的交叉特征和聚合特征。相比传统 featuretools 的暴力组合,LLM 能生成语义合理的特征,大幅减少噪声。代表论文和开源项目包括:
- OpenFE(2024):用 boosting tree 的特征重要性反馈引导 LLM 迭代生成特征,在 Kaggle 数据集上超越了人类特征工程师。
- SafeAutoFE(2024):强调”安全”——内置防泄露机制,保证 LLM 生成的特征不会意外引入数据泄露。
- Agent 范式:2025 年的趋势是把 LLM 封装为”特征工程 Agent”——给它数据 schema 和业务描述,它自主完成探索数据 → 提出假设 → 生成特征 → 训练模型评估 → 迭代优化的完整闭环。
特征存储(Feature Store)的成熟与演化
Section titled “特征存储(Feature Store)的成熟与演化”Feature Store(特征存储)是 MLOps 基础设施的关键组件——它统一管理离线训练特征和在线推理特征,解决训练-服务一致性(Training-Serving Skew,训练和推理时特征计算方式不一致导致的性能下降)问题。
2025 年的格局已从”概念验证”进入”生产标配”阶段:
- 云厂商方案:AWS SageMaker Feature Store、GCP Vertex AI Feature Store、Azure ML——与各自云生态深度集成,适合已锁定云平台的企业。
- 独立供应商:Tecton(Feast 商业版作者创建)、Hopsworks(首个开源 Feature Store,支持流批一体写入)、Chalk(2024 年崛起的实时特征平台,用 Rust 构建,主打低延迟)、Fennel(由前 Facebook 团队创建,强调 Pythonic API 和数据质量监控)。
- 开源方案:Feast(Linux 基金会托管,最轻量)、Feathr(微软/LinkedIn 开源,内置 point-in-time 正确性保证防泄露)、OpenMLDB(第四范式开源,统一 SQL 接口)。
- 实时化趋势:2025 年的核心趋势是实时特征工程——用 Flink/Kafka 做流式特征计算,毫秒级延迟写入在线存储,支持实时推荐和风控场景。
核心价值:Feature Store 不只是”存储”,更重要的是”复用”——不同团队训练的不同模型可以共享同一套特征定义,避免重复造轮子;且保证了线上推理时特征的计算逻辑与训练时完全一致。
表格基础模型(Tabular Foundation Models)
Section titled “表格基础模型(Tabular Foundation Models)”2024-2025 年 TabPFN、Tabular PTM 等预训练表格模型出现,在小样本场景下免去大部分特征工程——预训练时已学到了丰富的特征变换能力。但在大数据集和强领域知识场景下,人工特征工程仍不可替代。详见自动化与可解释性。
类别编码新方法——LLM Embedding
Section titled “类别编码新方法——LLM Embedding”用预训练语言模型将类别名编码为稠密向量(如用 BERT/BGE 编码商品标题),在高基数类别特征上效果超过传统 Target Encoding。优势是能捕捉类别间的语义相似度(如”iPhone 15 Pro”和”iPhone 14 Pro”在嵌入空间中很近,而 Target Encoding 视它们为完全无关的两个类别)。
因果特征选择
Section titled “因果特征选择”2024-2025 年兴起的方向——用因果推断(Causal Inference)方法筛选”因果相关”而非仅”统计相关”的特征,提高模型的泛化性和可解释性。经典案例:冰淇淋销量和溺水人数正相关(都随气温上升),但”冰淇淋销量”不是溺水的因——如果模型把”冰淇淋销量”当作预测溺水的特征,在分布外(Out-of-Distribution)场景会失效。因果特征选择能识别并排除这类伪相关(Spurious Correlation),在医疗和金融领域尤其受关注。
多模态特征工程
Section titled “多模态特征工程”结合表格特征 + 文本特征 + 图像特征的混合方案在推荐系统和电商搜索中成为主流。表格特征用 GBDT,文本/图像用 Transformer 编码,最后做 Stacking 或 late fusion。详见多模态。
特征工程的可观测性
Section titled “特征工程的可观测性”2025 年兴起的 Feature Observability——监控生产环境中特征的数据漂移(Data Drift,特征分布在时间上发生变化)、概念漂移(Concept Drift,特征与目标的关系发生变化)和特征质量(缺失率、异常率)。当特征分布偏离训练分布时自动告警,触发模型再训练。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| scikit-learn preprocessing | Python | StandardScaler、OneHotEncoder、PolynomialFeatures 等标准预处理 |
| pandas | Python | 数据清洗、分组聚合、时间特征提取的核心工具 |
| featuretools | Python | 自动化特征工程,自动生成深度交叉特征(Deep Feature Synthesis) |
| category_encoders | Python | 丰富的类别编码库(Target/Frequency/CatBoost/Hash Encoding 等) |
| tsfresh | Python | 自动化时间序列特征提取,几百种时序特征 |
| SHAP | Python | 基于 Shapley 值的特征重要性和模型可解释性分析 |
| Feast | Python | 开源 Feature Store,管理离线/在线特征一致性 |
| Hopsworks | Python | 首个支持流批一体写入的开源 Feature Store |
| autogluon.features | Python | AutoGluon 的自动特征生成模块,含自动类别编码和特征选择 |
| OpenFE | Python | LLM 辅助的特征工程开源项目,结合 boosting tree 反馈迭代生成特征 |
| Chalk | Python | Rust 内核的实时特征平台,主打低延迟在线特征服务 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 特征工程 | Feature Engineering | 把原始数据转化为模型能有效学习的特征的整个过程 |
| 标准化 | Standardization | 将数值特征转换为均值 0、标准差 1 的分布,消除量纲差异 |
| 归一化 | Normalization | 将数值特征缩放到固定区间(通常 [0,1]),与标准化侧重点不同 |
| 独热编码 | One-Hot Encoding | 每个类别用一个二值列表示,是类别特征编码的基础方法 |
| 目标编码 | Target Encoding | 用类别对应的目标变量均值来编码,信息密度高但需防泄露 |
| 贝叶斯平滑 | Bayesian Smoothing | Target Encoding 中向全局均值收缩以减小小样本方差的方法,源自 Beta 先验 |
| 特征选择 | Feature Selection | 从大量特征中筛选最有用的子集,去除冗余和噪声 |
| 特征交叉 | Feature Crossing | 将两个或多个特征组合生成新特征,捕捉交互效应 |
| 多项式特征 | Polynomial Features | 对原始特征做幂次和乘积扩展,让线性模型能拟合非线性关系 |
| 降维 | Dimensionality Reduction | 将高维特征压缩到低维,详见降维技术 |
| 主成分分析 | PCA | 通过正交变换找到方差最大的低维投影,是最经典的线性降维方法 |
| 互信息 | Mutual Information | 信息论指标,衡量两个变量间任意类型(含非线性)的依赖关系 |
| 数据泄露 | Data Leakage | 预处理时不当使用了测试集信息,导致评估虚高 |
| Pipeline | Pipeline | 将预处理和模型串联成流水线,确保一致性和防泄露 |
| SHAP 值 | SHAP Value | 基于博弈论分解每个特征对预测贡献的可解释性方法 |
| 稀疏解 | Sparse Solution | L1 正则化使大部分参数为零的特性,用于自动特征选择 |
| 维度灾难 | Curse of Dimensionality | 特征维度过高时数据变得稀疏、距离失去区分力的现象 |
| 训练-服务偏差 | Training-Serving Skew | 训练和推理时特征计算方式不一致导致的性能下降 |
| 特征存储 | Feature Store | 统一管理离线训练特征和在线推理特征的基础设施 |
| Out-of-Fold 编码 | Out-of-Fold Encoding | 用其他折的标签编码当前折的类别值,防止 Target Encoding 泄露 |
| 数据漂移 | Data Drift | 生产环境中特征分布在时间上发生变化,导致模型性能退化 |
| 伪相关 | Spurious Correlation | 两个变量统计相关但无因果关系,用作特征会导致泛化失败 |
- 特征工程实战:Zheng & Casari, “Feature Engineering for Machine Learning” (O’Reilly 2018),系统讲解数值/类别/文本/图像等各类特征的工程方法。
- 自动化特征工程:Kanter & Veeramachaneni, “Deep Feature Synthesis: Towards Automating Data Science Endeavors” (2015),featuretools 的理论基础。
- Target Encoding:Micci-Barreca, “A preprocessing scheme for high-cardinality categorical attributes in classification and prediction problems” (2001),Target Encoding 的经典论文。
- L1 正则化与稀疏性:Tibshirani, “Regression Shrinkage and Selection via the Lasso” (1996),Lasso 回归与 L1 正则化的奠基论文。
- SHAP:Lundberg & Lee, “A Unified Approach to Interpreting Model Predictions” (NeurIPS 2017),Shapley 值的可解释性方法。详见自动化与可解释性。
- OpenFE:Li et al., “OpenFE: Automated Feature Engineering with Large Language Models” (2024),LLM 辅助特征工程的前沿工作。
- Feature Store:He et al., “A Feature Store for ML at Scale” (2024),工业级特征存储系统的设计经验。在线目录见 featurestore.org。
- TabPFN:Hollmann et al., “TabPFN: A Transformer That Solves Small Tabular Classification Problems in a Second” (ICLR 2023),表格基础模型的代表作。
- Kaggle 经验:Kaggle 竞赛方案是学习特征工程的最佳实战资料,冠军分享的特征工程思路极其丰富。