
降维技术
降维(Dimensionality Reduction)把高维数据压缩到低维空间,同时尽量保留原始信息。它是无监督学习的核心任务之一,广泛应用于数据可视化、特征压缩、降噪和加速训练。本页从 PCA 的线性投影到 t-SNE/UMAP 的非线性流形学习,再到 KPCA 与自编码器的神经网络降维,完整梳理各方法的原理、数学推导与适用场景,并覆盖 2025-2026 年的前沿进展。
为什么需要降维
Section titled “为什么需要降维”在进入具体算法之前,先理解降维到底解决了什么问题。现实世界的数据往往是高维的——一张 的彩色图像有 维;一个基因表达谱可以有 20,000 多维。高维数据带来三个核心困难:
- 维度灾难(Curse of Dimensionality):随着维度增加,数据点之间的距离趋于相同(所有点都变得”等距”),距离度量的分辨力急剧下降,分类和聚类效果恶化。更具体地说,在 维空间中,要让数据密度保持不变,所需样本量随 指数增长。
- 计算和存储开销:维度越高,训练越慢、内存占用越大,许多算法(如 KNN、SVM)的复杂度直接依赖维度数。
- 可视化困难:人眼只能理解 2-3 维,超过 3 维的数据无法直接画图。
降维的核心假设是流形假设(Manifold Hypothesis):高维数据实际上近似分布在某个低维流形(manifold,即高维空间中的低维曲面)上。比如一张 的人脸图像虽然生活在 150,528 维空间中,但真正决定这张脸的”自由度”(表情、角度、光照、身份)可能只有几十到几百个——这些就是流形上的内在坐标。降维算法的任务就是把这个内在坐标找出来。
降维 = 给高维数据”拍扁照片”——找个最佳角度,让影子(低维投影)保留最多的信息。
想象一个 3D 立体物体,你要拍一张 2D 照片。从正上方拍和从侧面拍,看到的信息量完全不同。降维算法就是帮你找”最佳拍摄角度”的:
- PCA(主成分分析)= 找最佳拍照角度:找一个方向,让数据投影到这个方向的影子”散得最开”(方差最大)。第一个主成分是信息量最大的方向,第二个次之,依此类推。就像拍一个不规则物体——总有一个角度能看到最多的细节。
- t-SNE = 弹性地图:把高维点之间用弹簧连着,拉到 2D 平面上让”邻居还是邻居”。它不关心全局结构,只保证局部相似性——专用于可视化。
- UMAP = 更快的弹性地图:和 t-SNE 类似但更快,而且能更好地保留全局结构——既看到局部簇,也看到簇与簇的关系。
- KPCA = 弯曲空间里的 PCA:先用核函数(kernel)把数据隐式映射到高维特征空间,再在那个空间做 PCA——能处理线性不可分的弯曲数据流形。
- 自编码器 = 神经网络压缩器:像一个瓶颈网络——先用编码器把高维数据压到低维”瓶颈”,再用解码器还原。训练好后,瓶颈层的低维表示就是降维结果。
- PaCMAP = 全局+局部兼顾:2021 年提出的新一代方法,同时使用”近邻对”(拉近距离)、“中间对”(推开中等距离的点)和”远距对”(保持全局分离),兼顾局部簇结构和全局拓扑。
PCA 是线性方法(只能做旋转投影),t-SNE/UMAP/KPCA/PaCMAP 是非线性方法(能展开弯曲的数据流形)。就像拍照片只能拍到一面,而 3D 建模能展开整个物体。
方法全景对比
Section titled “方法全景对比”在深入每种方法之前,先用一张表建立全局印象:
| 方法 | 类型 | 能否 transform 新数据 | 保留全局结构 | 速度 | 典型用途 |
|---|---|---|---|---|---|
| PCA | 线性 | ✅ | ✅ | ⚡⚡⚡ | 特征压缩、降噪、加速训练 |
| SVD / Truncated SVD | 线性 | ✅ | ✅ | ⚡⚡⚡ | 稀疏矩阵降维、推荐系统、LSA |
| LDA | 线性(有监督) | ✅ | ✅ | ⚡⚡⚡ | 分类前特征压缩 |
| KPCA | 非线性 | ✅(近似) | 部分 | ⚡ | 弯曲流形降维 |
| MDS | 非线性 | ❌ | ✅ | ⚡ | 保持距离结构 |
| t-SNE | 非线性 | ❌ | ❌(仅局部) | ⚡ | 可视化 |
| UMAP | 非线性 | ✅ | ✅ | ⚡⚡ | 可视化、特征工程 |
| PaCMAP | 非线性 | ❌ | ✅ | ⚡⚡ | 鲁棒可视化 |
| 自编码器 | 非线性 | ✅ | 可学习 | ⚡ | 图像/音频等复杂数据 |
PCA:主成分分析
Section titled “PCA:主成分分析”PCA(Principal Component Analysis,主成分分析——由 Pearson 1901 年提出、Hotelling 1933 年推广的经典统计方法)是最经典的线性降维方法。核心思想:找到数据方差最大的方向(主成分),将数据投影到这些方向构成的低维空间。
协方差矩阵——先理解它是什么
Section titled “协方差矩阵——先理解它是什么”PCA 的全部计算都围绕**协方差矩阵(Covariance Matrix)**展开。在进入推导之前,先彻底理解它。
设数据矩阵 ( 个样本, 个特征),已中心化(每个特征列减去该列均值,使得 )。协方差矩阵 的第 个元素定义为:
- 对角线元素 = 第 个特征的方差(自己和自己共变的程度——衡量这个特征的”波动幅度”)。
- 非对角线元素 = 特征 和特征 的协方差(它们同时变化的趋势——正值表示正相关,负值表示负相关,零表示线性无关)。
用矩阵形式可以简洁地写成:
直觉:协方差矩阵是数据的”相关性档案”——它记录了每个特征自己有多大的波动,以及每对特征之间是否同步变化。PCA 的任务就是从这份档案中找出”波动最大且互不相关”的方向组合(主成分)。
数学推导:从最大化方差到特征值分解
Section titled “数学推导:从最大化方差到特征值分解”第 1 步:定义目标——最大化投影方差。
我们要找一个单位向量 (即 ),使数据投影到 方向后方差最大:
为什么用方差作为”信息量”的度量?因为方差大意味着数据在这个方向上”散得开”、变化丰富;方差为零意味着所有数据在这个方向上取值相同——没有信息。信息论中,方差(或等价地,熵)是信号”携带信息量”的自然度量。
第 2 步:带约束优化——拉格朗日乘子法。
最大化 ,约束 。构造拉格朗日函数(Lagrangian——将等式约束融入目标函数的标准优化技巧):
对 求导并令其为零(矩阵求导的链式法则:,当 对称时):
这正是特征值方程(Eigenvalue Equation——线性代数中最核心的方程 ,含义是”矩阵作用于特征向量 只做缩放、不改变方向”)! 是协方差矩阵 的特征值(eigenvalue,缩放倍数), 是对应的特征向量(eigenvector,方向)。
第 3 步:结论。
- 最大方差方向就是最大特征值对应的特征向量(第一主成分)。
- 第二大特征值对应第二主成分,依此类推。
- 投影方差就等于特征值 。
第 4 步:主成分的正交性。
协方差矩阵 是实对称矩阵(),由谱定理(Spectral Theorem——实对称矩阵必可对角化且特征向量互相正交),不同特征值对应的特征向量互相正交。这意味着各主成分之间不相关——第一个主成分提取的信息不会和第二个重复,这正是 PCA 高效的原因。
第 5 步:取前 个主成分做降维。
将前 个特征向量按列排列成投影矩阵 ,降维结果:
降维后的每个样本从 维变成了 维(),而且 个维度互不相关。
第 6 步:重建与信息损失。
PCA 是可逆的——用前 个主成分可以近似重建原始数据:
重建误差(被丢弃的信息量)恰好等于被舍弃的特征值之和:
这说明特征值不只是抽象的数字——它们精确地量化了每个主成分携带的信息量。
解释方差比(Explained Variance Ratio):第 个主成分保留的方差占总方差的比例为 。取前 个主成分的累积解释方差比——如”前 10 个主成分保留了 95% 的方差”,说明降维几乎没有信息损失。
直觉总结:PCA 的数学本质是一个带约束的最大化问题——在所有单位方向中找方差最大的方向,而拉格朗日乘子法把它转化成了特征值分解问题。协方差矩阵的特征值就是各方向的方差,特征向量就是方向。整个推导只用了三步:定义目标(方差最大化)→ 拉格朗日乘子法 → 特征值方程。
PCA 与最小二乘的等价性
Section titled “PCA 与最小二乘的等价性”PCA 还有一个等价的几何解释:它在寻找一个 维子空间,使得所有数据点到这个子空间的垂直距离之和最小(最小化重建误差)。这两件事——“最大化投影方差”和”最小化重建误差”——在数学上完全等价。这个等价性非常有用:它说明 PCA 同时是”信息保留最多”和”信息损失最少”的线性降维,从两个角度看都是最优的。
PCA 与 SVD 的等价关系
Section titled “PCA 与 SVD 的等价关系”SVD(Singular Value Decomposition,奇异值分解) 是比 PCA 更通用的矩阵分解方法。任何矩阵 都可以分解为:
其中 是 正交矩阵(左奇异向量), 是 对角矩阵(奇异值 ), 是 正交矩阵(右奇异向量)。
可以证明, 的协方差矩阵为:
所以 的列向量恰好就是协方差矩阵的特征向量(主成分方向),而 就是特征值 。
为什么实际实现中用 SVD 而不是特征值分解:SVD 在数值上更稳定(不需要显式计算 ,避免精度损失),且一次分解同时得到左、右奇异向量和奇异值。scikit-learn 的 PCA 内部就是调 SVD。
- 应用:推荐系统中的协同过滤(用户-物品矩阵分解)、图像压缩、潜在语义分析(LSA,Latent Semantic Analysis——对文档-词项矩阵做 SVD 发现潜在语义主题)。
PCA 的变体
Section titled “PCA 的变体”| 变体 | 原理 | 适用场景 |
|---|---|---|
| Incremental PCA | 分批(mini-batch)计算主成分,不要求全部数据载入内存 | 超大数据集、流式数据 |
| Randomized PCA | 用随机投影近似 SVD,大幅加速 | 很大时(如文本、图像) |
| Sparse PCA | 主成分是稀疏的(大部分系数为零),提高可解释性 | 需要理解每个主成分含义的场景 |
| Robust PCA | 把数据分解为”低秩 + 稀疏”两部分,对异常值鲁棒 | 视频前景/背景分离、异常检测 |
t-SNE:t-分布随机邻域嵌入
Section titled “t-SNE:t-分布随机邻域嵌入”t-SNE(t-Distributed Stochastic Neighbor Embedding, van der Maaten & Hinton 2008) 是最流行的非线性可视化降维方法。核心思想:高维空间中相似的点在低维中也应该靠近。
工作原理与数学推导
Section titled “工作原理与数学推导”第 1 步:高维空间——用高斯分布度量相似度。
对于点 和 ,定义 是 邻居的条件概率:
这里的核心思想是:把距离转化为概率。两点越近,它们互为邻居的概率越高。高斯核 的效果是”近处概率高、远处概率低”,呈指数衰减。
- 是以点 为中心的高斯核带宽(bandwidth,控制”多远算邻居”的尺度参数),由 perplexity 参数自适应确定(perplexity ,其中 是分布 的香农熵)。
- 对称化:,确保 。
Perplexity 的直觉:perplexity 可以理解为”有效邻居数量”。perplexity = 30 意味着每个点大约”关注” 30 个邻居。值小则只看最近邻(局部细节),值大则看更远的点(全局结构)。
第 2 步:低维空间——用 t 分布(自由度=1,即柯西分布)度量相似度。
注意这里用的是 重尾的 t 分布而非高斯分布。
第 3 步:优化目标——最小化 KL 散度。
KL 散度(Kullback-Leibler Divergence——衡量两个概率分布差异的非对称指标,,当且仅当 时为 0)越小,低维分布越接近高维分布。用梯度下降迭代调整低维坐标 。
第 4 步:KL 散度的梯度推导。
对 求导(这是 t-SNE 实际优化时每步使用的梯度):
这个梯度有一个非常优美的物理直觉:它像一根弹簧—— 是弹簧的”拉伸力”。如果高维中 和 很近( 大)但低维中它们远了( 小),那么 ,弹簧把它们拉近;反之推开。而 是 t 分布带来的”重尾因子”——远处的点也有非零的力,不会被指数衰减抹掉。
为什么用 t 分布而不是高斯分布——“拥挤问题”(Crowding Problem):
高维空间到低维空间的体积急剧缩小。假设高维中有大量”中等距离”的点,它们在 2D 中没有足够的空间放置,如果用高斯分布就会被挤在一起。t 分布的尾部更重(重尾,Heavy Tail),意味着低维中中等距离的点之间的相似度 被压得更低——优化时梯度会把它们推得更远,从而更好地展现簇结构。
数学直觉:在高维中,中等距离的点之间的相似度 较小但不为零;而在低维用高斯分布时, 会指数衰减到极小值,导致 ,梯度试图拉近它们——这违反了”中等距离应该保持中等距离”的目标。换成 t 分布后, 衰减得慢得多(多项式衰减 vs 指数衰减),中等距离的 更接近 ,梯度更合理。
- Early Exaggeration(早期放大):在优化初期把所有 乘以一个放大因子(如 4),人为增强高维相似度信号,迫使低维空间更快形成簇结构。大约迭代 250 步后恢复正常。
- Barnes-Hut 近似:计算梯度时用四叉树/八叉树近似远距离点的贡献,把复杂度从 降到 ——这是 t-SNE 能处理数万样本的关键。scikit-learn 的
TSNE默认使用此方法(method='barnes_hut')。 - 初始化:现代实现用 PCA 降维结果作为 t-SNE 的初始坐标(而非随机初始化),能显著加快收敛并提高稳定性。scikit-learn 的
init='pca'(默认)。
关键超参数:
- perplexity(困惑度):控制”有效邻居数量”,通常 5-50。值大关注全局结构,值小关注局部细节。
- 学习率:通常 200-1000,太大会导致所有点聚成一团,太小则收敛慢。
- 迭代次数:通常至少 1000 步,太少则簇未完全形成。
t-SNE 仅用于可视化:它没有
transform接口——无法对新数据降维。每次重新运行结果不同(随机初始化)。不适合作为建模前的降维手段。
UMAP:统一流形逼近与投影
Section titled “UMAP:统一流形逼近与投影”UMAP(Uniform Manifold Approximation and Projection, McInnes 2018) 是比 t-SNE 更快、更好的非线性降维方法,基于黎曼几何(Riemannian Geometry——研究弯曲空间中度量、角度等几何性质的数学分支)和代数拓扑(Algebraic Topology——用代数工具研究空间拓扑性质的数学分支)理论。
理论基础:为什么拓扑和几何
Section titled “理论基础:为什么拓扑和几何”UMAP 假设数据均匀分布在某个黎曼流形上(这是一个比 t-SNE 更强的数学假设),然后基于两个关键定理:
- Nerve Theorem(神经定理):如果一个空间被一组”充分重叠”的开集覆盖,那么这个空间的拓扑结构(连通性、空洞等)可以用这些开集的交叠关系来恢复——具体形式是一个称为 Čech 复形(Čech Complex)的拓扑对象。
- UMAP 的做法是:用每个数据点的 -近邻邻域作为”开集”,构建一个模糊单纯复形(Fuzzy Simplicial Complex——一种加权拓扑结构,可以通俗理解为”带权重的图”),它近似地恢复了数据的拓扑结构。
直觉翻译:UMAP 假设数据分布在一个弯曲的曲面上,但曲面上的距离是”均匀的”(局部各向同性)。它用每个点的近邻关系构建一张”拓扑图”来近似这个曲面,然后在低维空间重建这张图。
第 1 步:构建高维空间的模糊拓扑表示。
对每个点 ,找其 个最近邻,用指数衰减定义”连接强度”:
其中 是 到最近邻的距离(确保局部连通性——最近邻的连接强度为 1), 由 n_neighbors 参数确定(使得 个邻居的连接强度之和接近 )。
对称化使用模糊并集(fuzzy union):,得到一个模糊单纯复形——可以理解为高维空间的一张加权图。
第 2 步:构建低维空间的模糊拓扑表示。
在低维中用不同的距离函数(类似于 t-SNE 的重尾思想,但函数形式不同):
其中 是可调参数(默认通过最小化拟合确定,使得曲线在 附近接近 1、在 时快速衰减到 0——这个形状匹配”近处连接强、远处连接弱”的期望分布)。
第 3 步:最小化两个拓扑结构之间的交叉熵。
这是一个二项交叉熵(Cross-Entropy)。第一项类似 KL 散度(保持高维邻居在低维也是邻居),第二项保证非邻居在低维也分开——这就是 UMAP 比 t-SNE 更好保留全局结构的原因。t-SNE 的 KL 散度只有第一项(拉近邻居),缺乏”推开非邻居”的力,因此全局结构容易坍缩。
UMAP vs t-SNE 的深层差异
Section titled “UMAP vs t-SNE 的深层差异”| 特性 | t-SNE | UMAP |
|---|---|---|
| 理论基础 | 概率论(KL 散度) | 拓扑学 + 黎曼几何 |
| 高维相似度 | 对称高斯 | 模糊拓扑图 |
| 低维相似度 | t 分布 | 可调曲线 |
| 优化目标 | 单向 KL(只拉近) | 双向交叉熵(拉近 + 推开) |
| 全局结构 | 弱 | 强 |
| transform 新数据 | ❌ | ✅ |
| 速度 | (Barnes-Hut) | (近邻图) |
优势:
- 速度快:在大型数据集上比 t-SNE 快数倍到数十倍(基于近似最近邻搜索和力的计算优化)。
- 保留全局结构:t-SNE 只保证局部相似,UMAP 同时保留全局拓扑——簇与簇的相对位置有意义。
- 可 transform:UMAP 可以用训练数据拟合后对新数据降维(有
transform接口),可用于特征工程。 - 支持监督降维:UMAP 可以利用标签信息做监督降维(
fit(X, y)),提升分类任务的特征质量。 - 支持多种距离:可以指定自定义距离度量(如余弦距离、Jaccard 距离等),适用于文本、集合等非欧几里得数据。
关键超参数:
- n_neighbors:类似 t-SNE 的 perplexity,控制局部 vs 全局的平衡(通常 5-50)。值小关注局部细节,值大关注全局结构。
- min_dist:低维嵌入中点的最小间距,值小则簇更紧密。如果目标是可视化,推荐 0.1-0.5;如果目标是特征工程,推荐 0 或接近 0。
PaCMAP:成对控制流形逼近投影
Section titled “PaCMAP:成对控制流形逼近投影”PaCMAP(Pairwise Controlled Manifold Approximation and Projection, Wang et al. 2021) 是 Google PAIR 团队在系统对比 t-SNE、UMAP、TriMAP 等方法后设计的新一代流形学习算法。它通过引入三种不同类型的点对来解决局部-全局结构权衡问题。
PaCMAP 显式地构建三类点对,每类有不同的力:
- 近邻对(Near pairs / “Hi-NN”):每个点最近邻的若干个点——产生吸引力(拉近),保持局部簇结构。
- 中间对(Mid-near pairs):从第 6 近邻到第 PN 近邻中随机采样若干个点——也产生弱吸引力,保持中尺度结构(这是 t-SNE 和 UMAP 容易丢失的层次)。
- 远距对(Far pairs / “FP”):随机采样的非邻居点——产生排斥力(推开),保持全局分离。
优化目标是最小化这三类点对的总损失。中间对的引入是 PaCMAP 的核心创新——它填补了”近邻对”(太近)和”远距对”(太远)之间的空隙,能更好地保留数据的层次结构。
优势:
- 参数鲁棒性强:对超参数变化不敏感,不需要大量调参(默认参数在大多数数据集上都能给出好结果)。
- 全局结构好:在系统对比实验中,PaCMAP 保留全局结构的能力优于 t-SNE,与 UMAP 相当或更优。
- 处理异常值:对离群点的处理比 t-SNE 更稳健——异常值不会破坏整体结构。
核 PCA(KPCA)
Section titled “核 PCA(KPCA)”核主成分分析(Kernel PCA, Schölkopf et al. 1998) 是 PCA 的非线性推广。核心思想:用核技巧(Kernel Trick——不显式计算高维映射,只通过核函数计算内积)将数据隐式映射到高维特征空间,再在那个空间做线性 PCA。
定义一个非线性映射 ,将数据映射到高维特征空间 ( 可能是无限维的,比如 RBF 核对应的特征空间)。在特征空间中,协方差矩阵为:
直接计算 代价太高甚至无限维。这里用到一个关键的数学技巧:特征空间中的特征向量可以表示为训练样本的线性组合 。将此代入特征值方程 ,经过推导可以转化为对 核矩阵(Kernel Matrix,所有样本对的核函数值构成的矩阵)做特征值分解:
其中 是核函数值。核技巧的关键:特征空间中的内积可以用核函数 直接计算,无需显式计算 。常用核函数:
| 核函数 | 公式 | 适用场景 |
|---|---|---|
| 线性核 | 等价于普通 PCA | |
| RBF(高斯)核 | 通用,最常用 | |
| 多项式核 | 特征间多项式交互 | |
| Sigmoid 核 | 类似浅层神经网络 |
降维结果:
其中 是核矩阵的第 大特征值对应的特征向量(需归一化 )。
PCA vs KPCA:
- PCA 只能做线性投影,像一面镜子——旋转找最佳角度。
- KPCA 在高维特征空间做线性投影,但从原空间看是非线性的——像一面哈哈镜,能弯曲空间来捕捉弯曲的数据流形。
代价:KPCA 需要存储和分解 核矩阵,时间和空间复杂度都是 /——大数据集上比 PCA 慢得多。降维后的结果没有逆变换(无法重建原始数据),因为映射 不可逆。对新数据降维时也需要计算它和所有训练样本的核函数值,推理开销也较高。
MDS 与 Isomap:保持距离的降维
Section titled “MDS 与 Isomap:保持距离的降维”MDS(Multidimensional Scaling,多维缩放) 是比 PCA 更早的降维方法,它的目标不是保持方差,而是保持距离:让低维空间中点之间的距离尽可能接近高维空间中的距离。
经典 MDS(Classical MDS) 的数学推导:给定一个距离矩阵 (),先转换为内积矩阵(Gram matrix)(其中 是中心化矩阵),然后对 做特征值分解——经典 MDS 在数学上与 PCA 等价。
Isomap(Isometric Mapping, Tenenbaum et al. 2000) 是 MDS 的非线性推广:它用测地距离(geodesic distance——沿数据流形表面的距离,而非直线欧氏距离)替代欧氏距离。具体做法是先构建 -近邻图,用最短路径算法(如 Dijkstra)估计测地距离,再喂给 MDS。Isomap 特别适合”卷曲”的数据流形(如经典的 Swiss Roll 数据集)。
自编码器降维
Section titled “自编码器降维”自编码器(Autoencoder) 用神经网络做非线性降维:
输入层(高维)→ 编码器(逐层缩小)→ 瓶颈层(低维)→ 解码器(逐层放大)→ 输出层(重建)训练目标:让输出尽可能还原输入(最小化重建误差)。训练好后,瓶颈层的低维表示就是降维结果。
编码器 和解码器 都是神经网络:
损失函数(重建误差):
瓶颈层维度 ,迫使网络学习数据的压缩表示——这种表示就是降维结果。
自编码器的变体
Section titled “自编码器的变体”| 变体 | 核心思想 | 优势 |
|---|---|---|
| 降噪自编码器(DAE) | 给输入加噪声,要求重建干净原始数据 | 学习更鲁棒的特征,有正则化效果 |
| 稀疏自编码器(Sparse AE) | 瓶颈层加 L1 正则或 KL 散度惩罚,强制稀疏 | 每个隐含维度学到有意义的”特征探测器” |
| 卷积自编码器(CAE) | 编码器/解码器用卷积层而非全连接层 | 适合图像数据,保持空间结构 |
| 变分自编码器(VAE) | 瓶颈层不是确定值而是概率分布(均值+方差) | 可生成新样本,是生成模型 |
- 优势:能学习高度非线性的降维映射,适用于图像、音频等复杂数据。
- 变分自编码器(VAE):瓶颈层不是确定值而是概率分布,可生成新样本。详见 VAE。
自编码器与 PCA 的关系
Section titled “自编码器与 PCA 的关系”当自编码器只有一层线性隐含层(无激活函数)且使用 MSE 损失时,它学到的表示等价于 PCA。多层非线性自编码器可以看作 PCA 的非线性推广——瓶颈层的每个维度可以类比为”非线性主成分”。
LDA:线性判别分析(有监督降维)
Section titled “LDA:线性判别分析(有监督降维)”LDA(Linear Discriminant Analysis,线性判别分析——Fisher 1936 年提出的经典方法,注意要与 NLP 领域的”Latent Dirichlet Allocation 主题模型”区分) 与 PCA 不同——它是有监督的降维方法,利用类别标签信息。
- PCA:最大化方差(无监督)——找信息量最大的方向。
- LDA:最大化类间方差 / 类内方差(有监督)——找类别区分度最大的方向。
定义两个散布矩阵:
- 类内散布矩阵 (各类内部样本到类均值的散布之和——衡量各类内部的”紧密度”)
- 类间散布矩阵 (各类均值到全局均值的散布——衡量各类之间的”分离度”)
LDA 的优化目标是最大化 Fisher 准则:
这个准则的含义非常直观:我们想找一个投影方向 ,使得投影后各类均值分得尽可能开(分子大),同时各类内部尽可能紧凑(分母小)。解为广义特征值问题 ——投影方向 使类间方差最大、类内方差最小。
对于一个 分类问题,LDA 最多降到 维(类间散布矩阵 的秩至多为 )。LDA 常用于分类前的特征压缩,特别适合类别可分性受冗余特征干扰的场景。
PCA 投影方向 vs t-SNE 局部保持
Section titled “PCA 投影方向 vs t-SNE 局部保持”降维方法选型决策
Section titled “降维方法选型决策”sklearn PCA + t-SNE + UMAP 对比
Section titled “sklearn PCA + t-SNE + UMAP 对比”from sklearn.decomposition import PCA # PCA 降维from sklearn.manifold import TSNE # t-SNE 降维from sklearn.datasets import load_digits # 手写数字数据集# from umap import UMAP # 需 pip install umap-learn
X, y = load_digits(return_X_y=True) # 64 维(8x8 像素),1797 个样本print(f"原始维度: {X.shape}") # (1797, 64)
pca = PCA(n_components=2).fit_transform(X) # PCA:线性降维,秒级tsne = TSNE(n_components=2, perplexity=30, # t-SNE:非线性降维 random_state=42, init='pca').fit_transform(X) # 用 PCA 初始化,更稳定# umap = UMAP(n_components=2, n_neighbors=15).fit_transform(X) # UMAP:更快更好
# 可视化对比(需 matplotlib):三个方法降到 2 维后画散点图,颜色按数字标签# 三种方法都能看到 0-9 形成不同的簇,t-SNE/UMAP 的簇更清晰分离可视化时用
plt.scatter(降维结果[:,0], 降维结果[:,1], c=y, cmap='tab10')即可看到各数字自动聚成簇。t-SNE 和 UMAP 的分离效果通常优于 PCA。
三种方法对比可视化(完整版)
Section titled “三种方法对比可视化(完整版)”import matplotlib.pyplot as pltfrom sklearn.decomposition import PCAfrom sklearn.manifold import TSNEfrom sklearn.datasets import load_digits# from umap import UMAP
X, y = load_digits(return_X_y=True)
# 三种方法分别降到 2 维X_pca = PCA(n_components=2, random_state=42).fit_transform(X)X_tsne = TSNE(n_components=2, perplexity=30, random_state=42, init='pca', learning_rate='auto').fit_transform(X)# X_umap = UMAP(n_components=2, n_neighbors=15, min_dist=0.1,# random_state=42).fit_transform(X)
fig, axes = plt.subplots(1, 3, figsize=(18, 5))for ax, data, title in zip(axes, [X_pca, X_tsne], # 加入 X_umap 如已安装 ['PCA', 't-SNE']): # 加入 'UMAP' scatter = ax.scatter(data[:, 0], data[:, 1], c=y, cmap='tab10', s=5, alpha=0.7) ax.set_title(title, fontsize=14) ax.set_xlabel('第 1 维') ax.set_ylabel('第 2 维')
plt.colorbar(scatter, ax=axes, label='数字标签')plt.suptitle('手写数字数据集三种降维方法对比(64 维 → 2 维)', fontsize=16)plt.tight_layout()plt.savefig('dim_reduction_comparison.png', dpi=150, bbox_inches='tight')plt.show()
# 典型结果:# - PCA:各数字大致分开,但有较多重叠(线性方法的天花板)# - t-SNE:各数字形成清晰的簇,簇间有明显间隔(局部结构优秀)# - UMAP:簇同样清晰,且簇间距离更有意义(全局结构更好)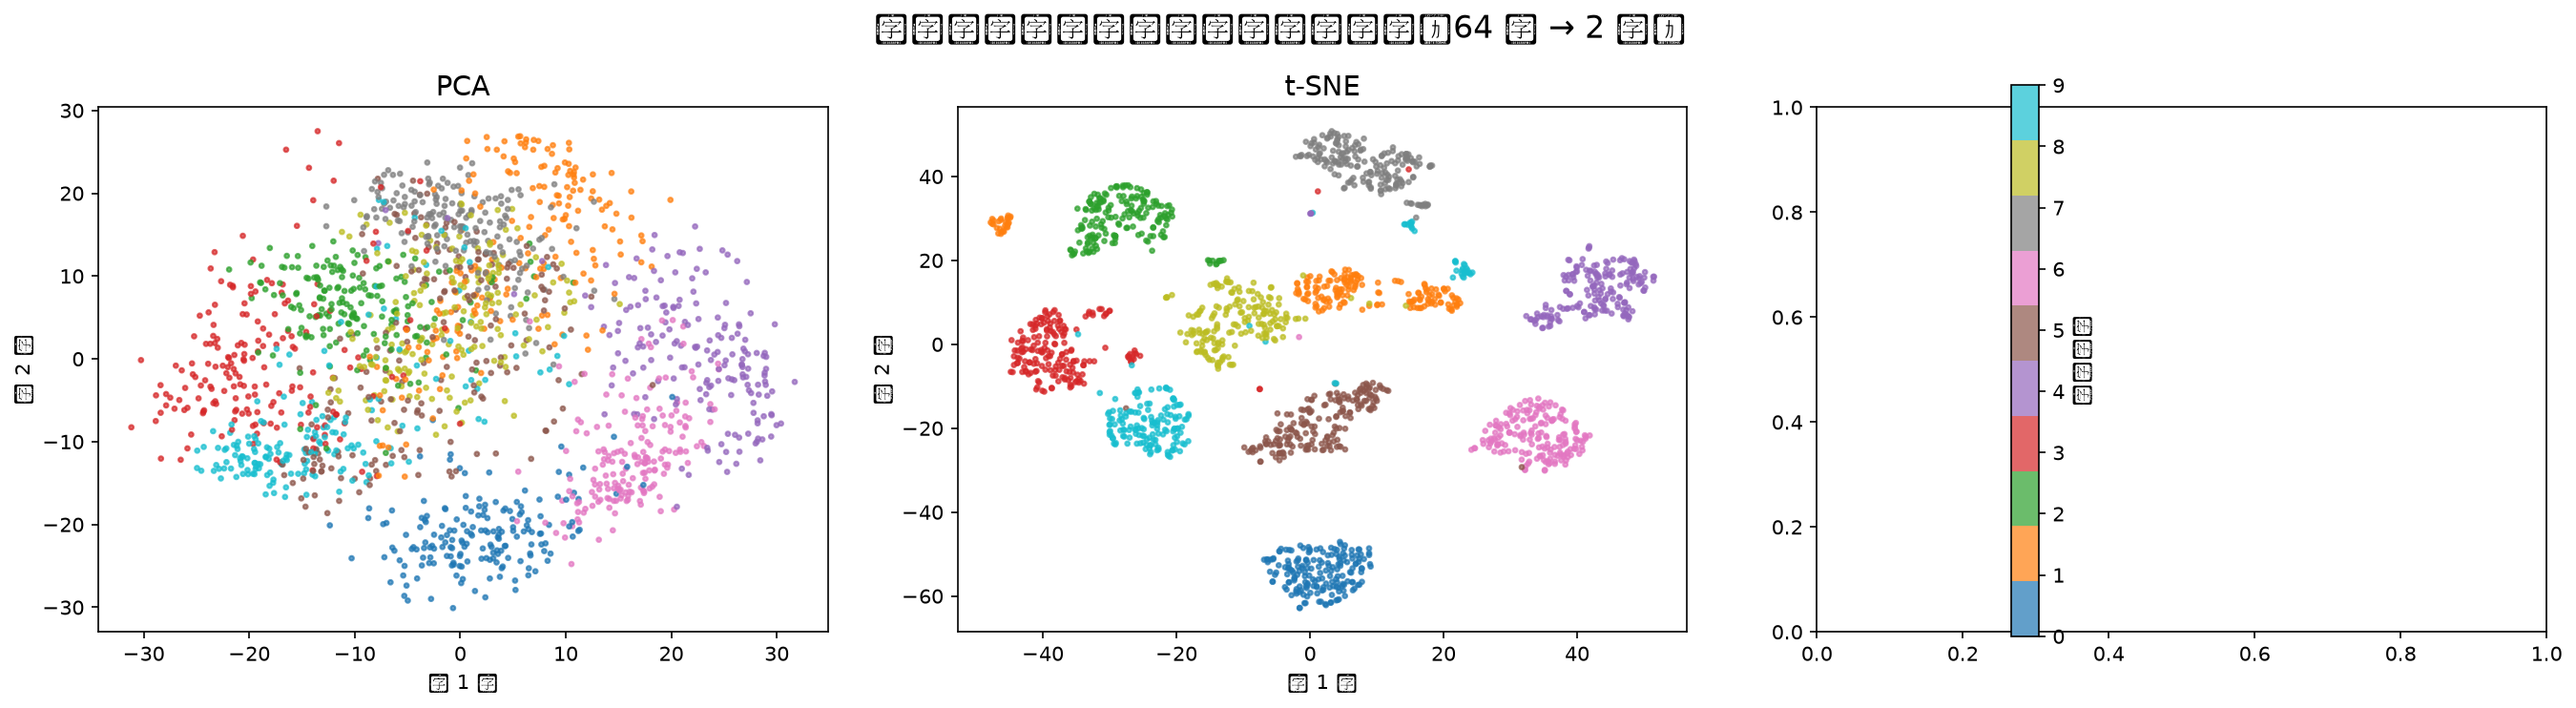
PCA 数学验证:解释方差比
Section titled “PCA 数学验证:解释方差比”from sklearn.decomposition import PCAfrom sklearn.datasets import load_digitsimport numpy as npimport matplotlib.pyplot as plt
X, y = load_digits(return_X_y=True) # 64 维手写数字
# 保留所有主成分,看每个方向的方差贡献pca_full = PCA().fit(X)evr = pca_full.explained_variance_ratio_ # 每个主成分的方差占比
# 累积解释方差:前 K 个主成分总共保留了多少信息cumvar = np.cumsum(evr)for k in [5, 10, 20, 30, 40]: print(f"前 {k:2d} 个主成分保留 {cumvar[k-1]:.1%} 方差")# 输出示例:# 前 5 个主成分保留 43.2% 方差# 前 10 个主成分保留 65.8% 方差# 前 20 个主成分保留 85.4% 方差 ← 64 维压到 20 维,丢 15% 信息# 前 30 个主成分保留 94.3% 方差# 前 40 个主成分保留 98.3% 方差
# 实际工程中常用 95% 方差作为自动选维标准pca_95 = PCA(n_components=0.95).fit(X) # 自动选保留 95% 方差的最少维度print(f"保留 95% 方差需要 {pca_95.n_components_} 个主成分") # 示例: 29
# === 可视化:解释方差比曲线 ===fig, ax = plt.subplots(figsize=(10, 5))ax.bar(range(1, len(evr) + 1), evr, alpha=0.5, label='单个主成分')ax.plot(range(1, len(cumvar) + 1), cumvar, 'r-', linewidth=2, label='累积解释方差')ax.axhline(y=0.95, color='g', linestyle='--', label='95% 阈值')ax.set_xlabel('主成分序号')ax.set_ylabel('解释方差比')ax.set_title('PCA 解释方差比分析(手写数字数据集)')ax.legend()plt.tight_layout()plt.savefig('pca_explained_variance.png', dpi=150)plt.show()# 从图中可以直观看到:前几个主成分方差贡献急剧下降("拐点"),# 之后趋于平缓——拐点处的维度数通常是降维的好选择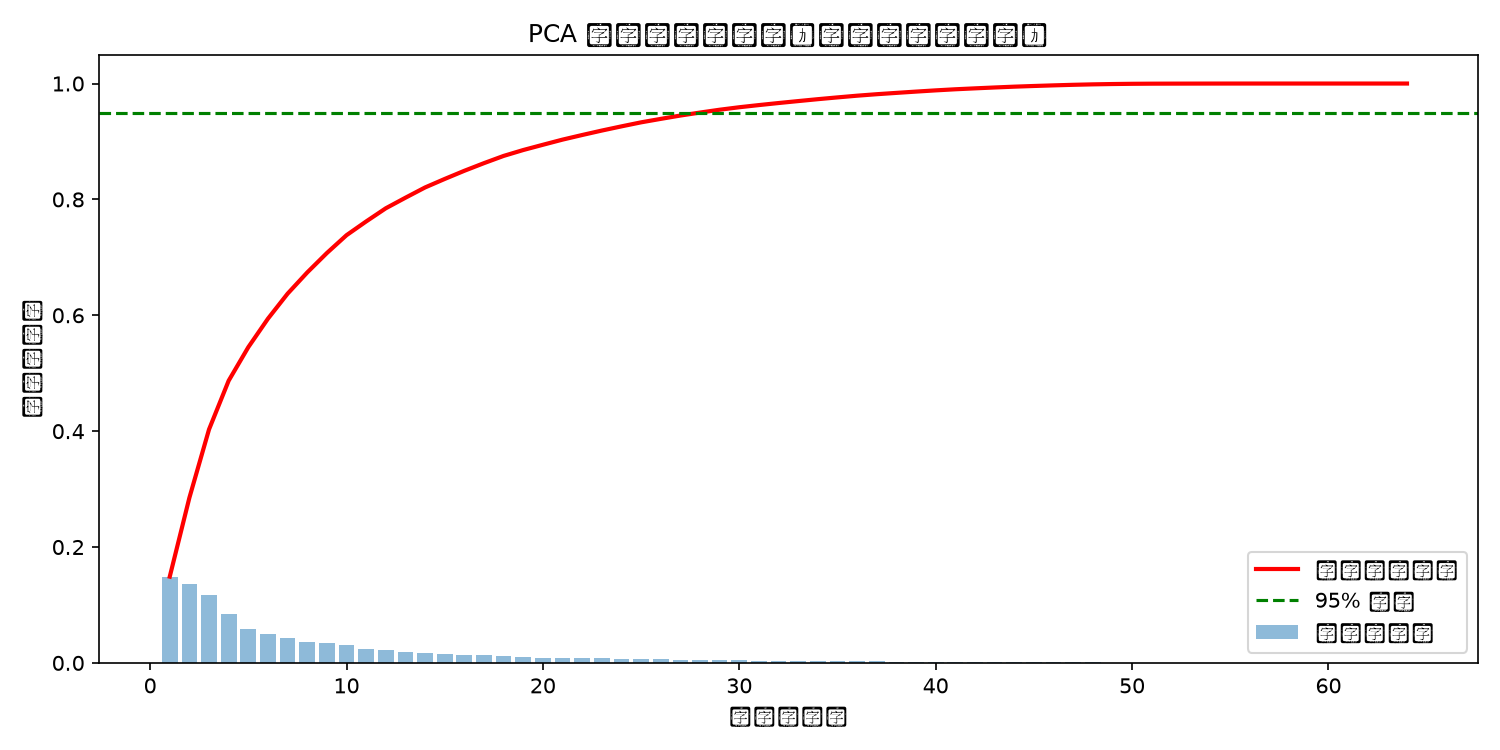
KPCA 实战:非线性降维
Section titled “KPCA 实战:非线性降维”from sklearn.decomposition import KernelPCAfrom sklearn.datasets import make_circles
# 生成同心圆数据——线性 PCA 完全无能为力,需要核技巧X, y = make_circles(n_samples=400, factor=0.3, noise=0.05, random_state=42)
# 普通 PCA:线性降维,同心圆投影后仍然重叠# KPCA + RBF 核:把数据映射到高维空间后做 PCA,能"拉直"同心圆kpca = KernelPCA(n_components=2, kernel="rbf", gamma=10, random_state=42)X_kpca = kpca.fit_transform(X)
# 可视化: plt.scatter(X_kpca[:, 0], X_kpca[:, 1], c=y)# 效果:内外两圈被映射到不同区域,线性可分——这就是核技巧的威力PyTorch 自编码器降维(含训练可视化)
Section titled “PyTorch 自编码器降维(含训练可视化)”import torchimport torch.nn as nnfrom sklearn.datasets import load_digitsimport matplotlib.pyplot as plt
X, y = load_digits(return_X_y=True)X_tensor = torch.FloatTensor(X) / 16.0 # 归一化像素到 [0, 1]
# 自编码器:64 → 32 → 3(瓶颈) → 32 → 64class Autoencoder(nn.Module): def __init__(self, input_dim=64, latent_dim=3): super().__init__() self.encoder = nn.Sequential( nn.Linear(input_dim, 32), nn.ReLU(), nn.Linear(32, latent_dim), # 瓶颈层(降维结果) ) self.decoder = nn.Sequential( nn.Linear(latent_dim, 32), nn.ReLU(), nn.Linear(32, input_dim), nn.Sigmoid(), # 输出重建,Sigmoid 压到 [0,1] )
def forward(self, x): z = self.encoder(x) # 编码:高维 → 低维 x_recon = self.decoder(z) # 解码:低维 → 重建 return x_recon, z
model = Autoencoder(latent_dim=3)optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)criterion = nn.MSELoss() # 重建误差 = MSE
# 记录训练损失losses = []
# 训练 200 轮for epoch in range(200): recon, z = model(X_tensor) loss = criterion(recon, X_tensor) # 目标:重建 ≈ 输入 optimizer.zero_grad() loss.backward() optimizer.step() losses.append(loss.item()) if (epoch + 1) % 50 == 0: print(f"Epoch {epoch+1}, 重建误差: {loss.item():.4f}")
# 训练完成后,z 就是 3 维降维结果(64 维 → 3 维)recon, z = model(X_tensor)print(f"降维结果形状: {z.shape}") # torch.Size([1797, 3])
# === 可视化 ===fig, axes = plt.subplots(1, 2, figsize=(14, 5))
# 左图:训练损失曲线axes[0].plot(losses)axes[0].set_xlabel('Epoch')axes[0].set_ylabel('重建误差 (MSE)')axes[0].set_title('自编码器训练损失')
# 右图:3 维降维结果(取前 2 维展示)z_np = z.detach().numpy()axes[1].scatter(z_np[:, 0], z_np[:, 1], c=y, cmap='tab10', s=5, alpha=0.7)axes[1].set_xlabel('瓶颈维度 1')axes[1].set_ylabel('瓶颈维度 2')axes[1].set_title('自编码器降维结果(3D 瓶颈,展示前 2 维)')
plt.tight_layout()plt.savefig('autoencoder_result.png', dpi=150)plt.show()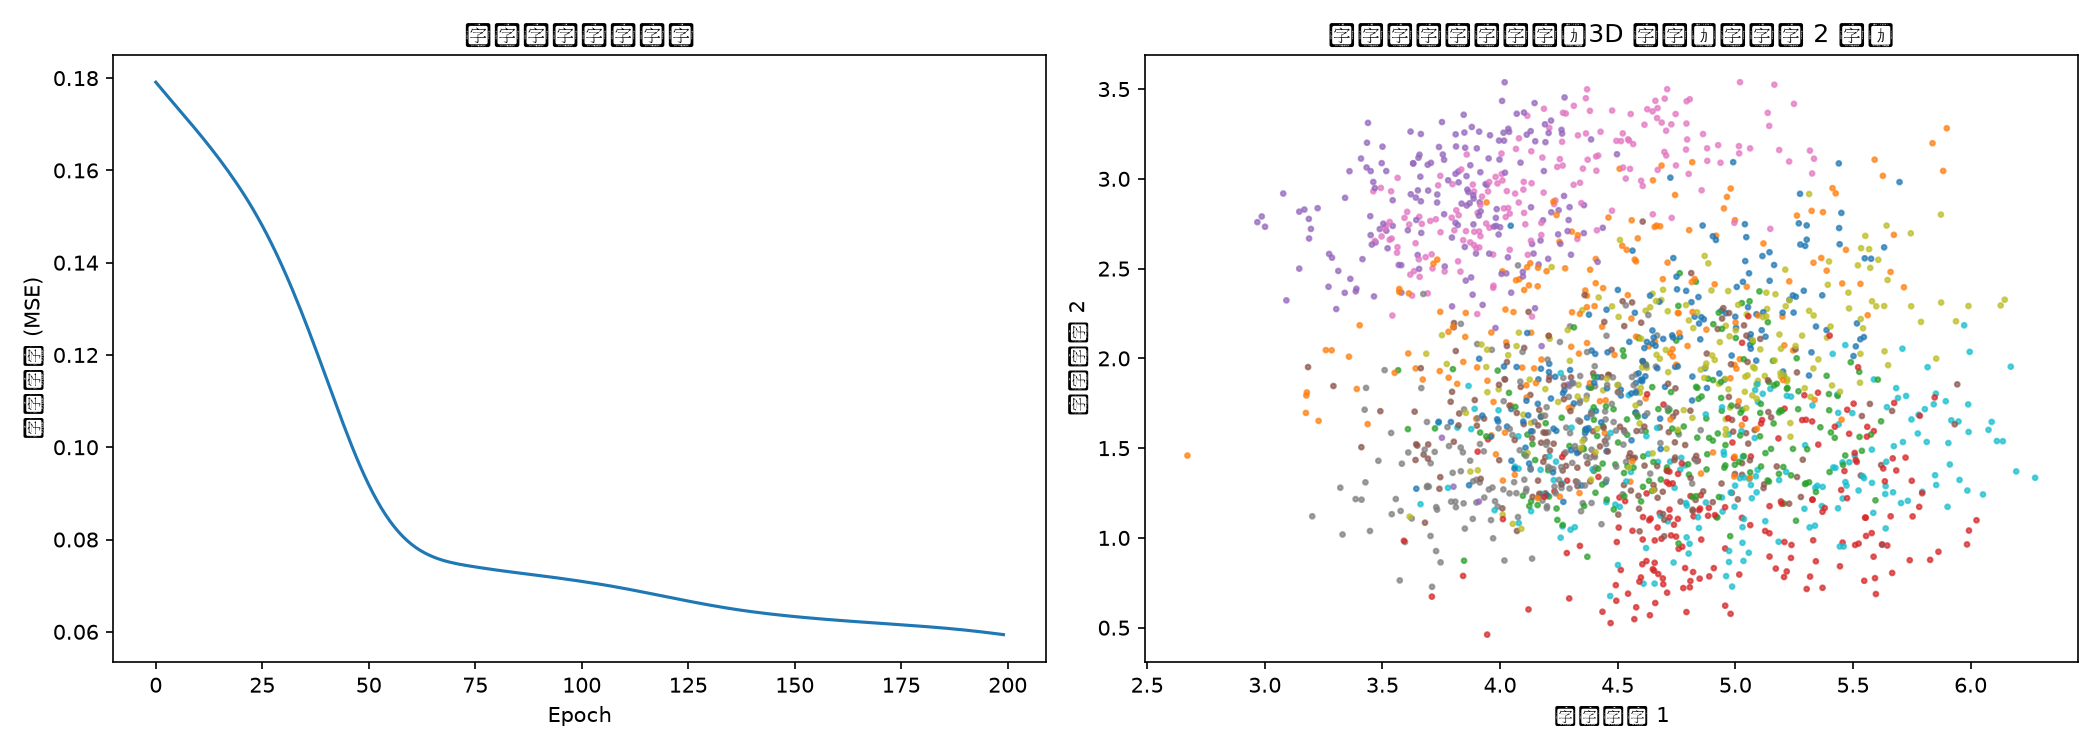
降噪自编码器示例
Section titled “降噪自编码器示例”import torchimport torch.nn as nnfrom sklearn.datasets import load_digits
X, y = load_digits(return_X_y=True)X_tensor = torch.FloatTensor(X) / 16.0
# 给输入加噪声(模拟真实场景中的噪声数据)noise = torch.randn_like(X_tensor) * 0.3X_noisy = (X_tensor + noise).clamp(0, 1) # 加噪后裁剪到 [0,1]
class DenoisingAutoencoder(nn.Module): """降噪自编码器:输入是噪声数据,目标是重建干净数据""" def __init__(self, input_dim=64, latent_dim=10): super().__init__() self.encoder = nn.Sequential( nn.Linear(input_dim, 32), nn.ReLU(), nn.Linear(32, latent_dim), nn.ReLU(), ) self.decoder = nn.Sequential( nn.Linear(latent_dim, 32), nn.ReLU(), nn.Linear(32, input_dim), nn.Sigmoid(), )
def forward(self, x): return self.decoder(self.encoder(x)), self.encoder(x)
model = DenoisingAutoencoder(latent_dim=10)optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)criterion = nn.MSELoss()
for epoch in range(300): recon, z = model(X_noisy) # 输入:噪声数据 loss = criterion(recon, X_tensor) # 目标:干净数据(不是 X_noisy!) optimizer.zero_grad() loss.backward() optimizer.step() if (epoch + 1) % 100 == 0: print(f"Epoch {epoch+1}, 重建误差: {loss.item():.4f}")
# 降噪自编码器学到的特征比普通自编码器更鲁棒# 因为它被迫从噪声中恢复信号,而不是简单记忆输入UMAP 用于 LLM Embedding 可视化
Section titled “UMAP 用于 LLM Embedding 可视化”"""将 BERT/Sentence-Transformer 生成的 768 维 embedding用 UMAP 降到 2 维可视化——这是 2025 年最常见的 embedding 分析工作流"""import numpy as np# from sentence_transformers import SentenceTransformer# from umap import UMAPimport matplotlib.pyplot as plt
# 示例文本(实际使用时替换为你的语料库)texts = [ "机器学习是人工智能的分支", "深度学习使用神经网络", "今天天气真好", "我想吃火锅", "CNN 用于图像识别", "Transformer 是大模型的基础", "明天下雨吗", "推荐一家好吃的餐厅",]categories = ['AI', 'AI', '日常', '日常', 'AI', 'AI', '日常', '日常']
# 第一步:用预训练模型生成 embedding(768 维)# model = SentenceTransformer('all-MiniLM-L6-v2')# embeddings = model.encode(texts) # shape: (8, 384) 或 (n, 768)
# 第二步:UMAP 降维到 2 维# reducer = UMAP(n_components=2, n_neighbors=5, min_dist=0.3,# metric='cosine', random_state=42) # 文本用余弦距离更合理# coords = reducer.fit_transform(embeddings)
# 第三步:可视化# plt.figure(figsize=(8, 6))# for cat in set(categories):# mask = [c == cat for c in categories]# plt.scatter(coords[mask, 0], coords[mask, 1], label=cat, s=100)# for i, txt in enumerate(texts):# plt.annotate(txt[:10] + '...', (coords[i, 0], coords[i, 1]), fontsize=8)# plt.legend()# plt.title('UMAP: LLM Embedding 语义聚类可视化')# plt.tight_layout()# plt.savefig('umap_embeddings.png', dpi=150)# plt.show()
# 预期结果:AI 相关文本聚在一起,日常对话聚在另一处# 说明 embedding 捕获了语义相似性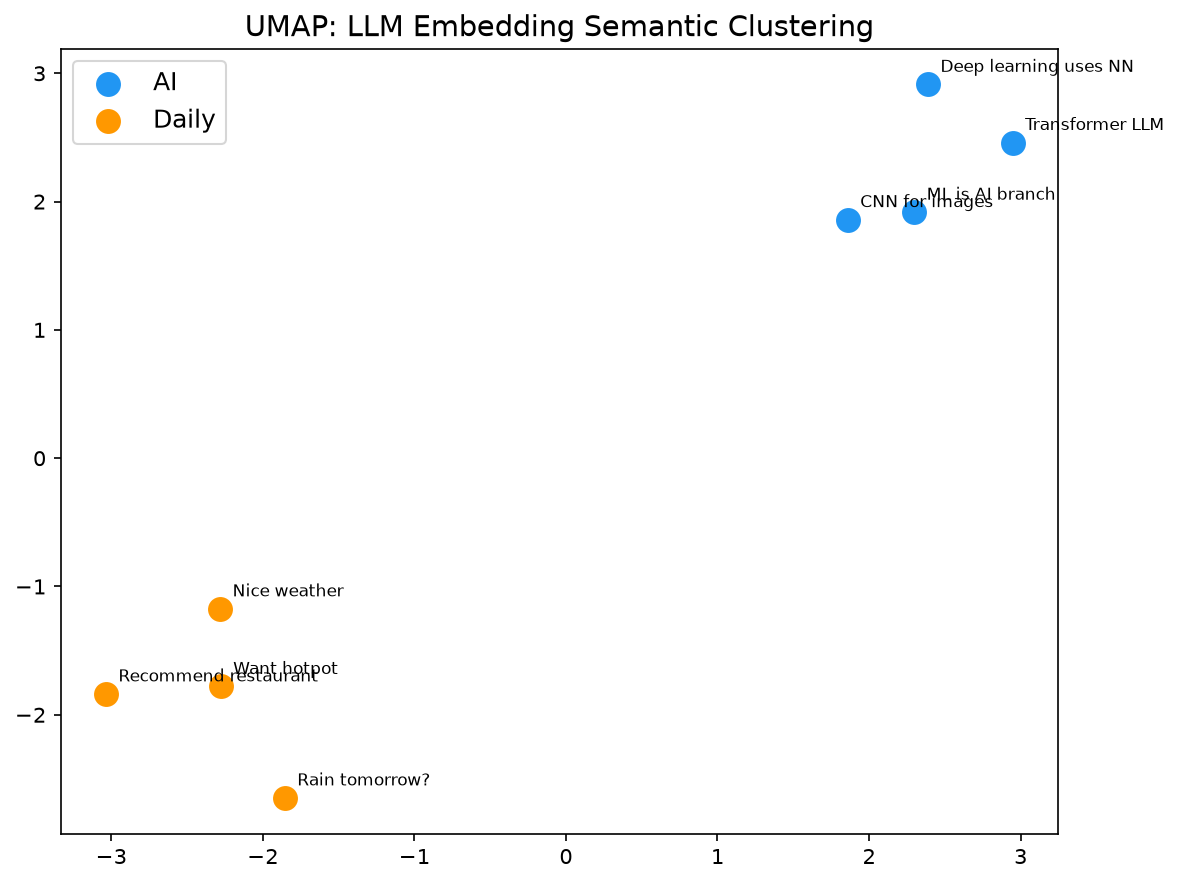
- PCA 降维前必须标准化:PCA 基于方差,大量纲特征会主导主成分方向。先
StandardScaler再 PCA。 - t-SNE 不能用于新数据:没有 transform 接口,每次全量重算。要对新数据降维请用 UMAP 或 PCA。
- t-SNE 的结果没有绝对意义:点之间的距离和簇的大小不可定量解读,只能看相对结构(哪些点聚在一起)。特别地,t-SNE 图中簇与簇之间的距离和相对大小不代表真实关系。
- perplexity 需调试:t-SNE 的 perplexity 值显著影响结果,建议尝试 5/15/30/50 多个值对比。
- PCA 解释方差比指导降维维度:画累积解释方差比曲线,通常选保留 90-95% 方差的维度数。
- UMAP 是 t-SNE 的现代替代:在大多数可视化场景,UMAP 比 t-SNE 更快且效果不差,建议优先尝试。
- PaCMAP 是最省心的可视化方法:如果不想调参,PaCMAP 的默认参数在大多数数据集上都能给出好结果。
- KPCA 的 gamma 参数很关键:RBF 核的 gamma 过大会过拟合(每个点自成一类),过小则退化为线性 PCA,需要交叉验证。
- 自编码器要防过拟合:瓶颈层维度太大→重建容易但降维效果差;太小→信息损失过多。可用 dropout 和正则化。
- 降维后再训练分类器要做交叉验证:把降维和分类器放入同一 Pipeline,在交叉验证的每折中分别拟合,避免信息泄露。
- 选择距离度量很重要:对文本/embedding 数据,UMAP 搭配余弦距离(
metric='cosine')通常比欧氏距离效果好——因为语义相似性体现在方向而非幅度上。 - 大规模数据先采样再可视化:t-SNE/UMAP 在几十万样本上仍然较慢。常见做法是随机采样 1-5 万个样本做可视化,用 PCA 预降维到 50 维后再喂给 t-SNE/UMAP 也能大幅加速。
- 数据可视化:将深度学习模型提取的高维 embedding(768 维)降到 2 维,直观查看样本是否按语义聚类——TensorBoard Embedding Projector、Hugging Face Spaces 的核心功能。详见嵌入模型和句向量。
- 特征压缩:将几十上百维特征压缩到 10-20 维加速训练,同时去除噪声——人脸识别的 Eigenface(特征脸,PCA 应用于人脸图像的经典方法)就是 PCA 的经典应用。
- 降噪:PCA 取前几个主成分相当于低通滤波——保留信号(大方差方向)、滤除噪声(小方差方向)。在信号处理中,这被称为 Karhunen-Loève 变换。
- 加速训练:降维后特征更少,训练更快、内存更省——在超大规模数据上 PCA + 下游模型是常见流水线。
- 推荐系统协同过滤:SVD 分解用户-物品评分矩阵,发现潜在因子——Netflix 大赛的获奖方案核心。详见推荐系统。
- 基因表达数据分析:生物信息学中,对数千个基因的表达矩阵做 PCA,前几个主成分往往能揭示细胞类型或疾病亚型——单细胞 RNA 测序(scRNA-seq)分析的标准流程。
- 工业传感器降噪:制造业中数百个传感器的信号高度相关,PCA 提取主成分去除冗余和噪声,用于故障检测和质量预测。
- 自然语言处理:对文档-词项矩阵做 SVD(即 LSA),发现文档和词项的潜在语义主题;word2vec/GloVe 的 embedding 向量也常通过 PCA 降维可视化。
- 金融数据分析:对多只股票的收益率做 PCA,前几个主成分代表”市场因子""行业因子”——这是统计学因子模型的基础。
- LLM embedding 质量评估:用 UMAP/t-SNE 将大模型输出的 embedding 降维,检查语义相近的文本是否在低维空间中聚集——这是评估 embedding 模型质量的直观方法。
- 异常检测:PCA 重建误差可以用于异常检测——正常数据重建误差低,异常数据(偏离主成分方向)重建误差高。Robust PCA(把数据分解为低秩 + 稀疏)在视频监控中用于前景/背景分离。
2025-2026 前沿进展
Section titled “2025-2026 前沿进展”UMAP 生态与 Parametric UMAP
Section titled “UMAP 生态与 Parametric UMAP”UMAP 已成为 embedding 可视化的标准工具,广泛集成到 Hugging Face、Weights & Biases、TensorBoard 等平台。Parametric UMAP(Sainburg et al., Neural Computation 2021)用神经网络学习从原始数据到低维嵌入的映射函数(而非直接优化嵌入坐标),使得以下能力成为可能:
- 增量/流式降维:训练好网络后,可以对源源不断的新数据实时降维,无需重新拟合——这在实时数据监控(如在线推荐系统的 embedding 质量监控)中非常有用。
- 自定义网络架构:可以用 CNN 作为编码器直接对图像降维,用 Transformer 编码器对文本降维——降维不再是独立的预处理步骤,而是可以端到端训练的组件。
- 逆向重建:Parametric UMAP 支持训练解码器网络,实现低维→高维的近似重建(
parametric_reconstruction=True),可用于生成任务。
# Parametric UMAP 示例# from umap.parametric_umap import ParametricUMAP# embedder = ParametricUMAP(n_components=2, n_neighbors=15)# embedding = embedder.fit_transform(my_data)# # 之后可以对新数据直接 transform# new_embedding = embedder.transform(new_data)PaCMAP 的持续改进与工业采纳
Section titled “PaCMAP 的持续改进与工业采纳”PaCMAP 自 2021 年提出以来,在 2024-2025 年持续改进,已成为 Google 内部和学术界广泛使用的可视化工具。其核心优势在于参数鲁棒性——不需要像 t-SNE 那样反复调 perplexity,默认参数在大多数数据集上都能给出可靠的结果。PaCMAP 特别适合以下场景:
- 需要快速得到可视化结果而不想调参的场合。
- 数据中存在异常值/离群点,其他方法(如 t-SNE)容易将其放大成虚假簇。
- 需要保留数据的多尺度层次结构(不只是局部簇,还有中间尺度的结构)。
PyMDE / MDE(Minimum Distortion Embedding)
Section titled “PyMDE / MDE(Minimum Distortion Embedding)”斯坦福团队(Agarwal et al., 2021)提出、2024-2025 年持续发展的 MDE 框架,将降维统一为最小化”失真”(distortion)的优化问题。它的核心思想是:用户定义哪些数据关系需要保持(称为”保真约束”,如”点 A 和点 B 的距离应该接近某个值”),MDE 找到低维嵌入使得总失真最小。
MDE 框架的优势:
- 统一性:t-SNE、UMAP、MDS、力导向图布局都可以看作 MDE 的特例——通过选择不同的失真函数和保真约束。
- 可解释性:每个保真约束都有明确的含义(“保持这两点接近""保持这两组点分开”),用户可以加入领域知识。
- 灵活性:支持自定义约束,如”保持特定锚点位置不变”——这在交互式可视化中很有用。
降维与 LLM Embedding 的深度结合
Section titled “降维与 LLM Embedding 的深度结合”2024-2025 年,随着大语言模型的普及,降维技术在 embedding 分析中找到了新的核心应用场景:
- Embedding 质量评估:对 LLM 生成的 embedding 做 UMAP 可视化,检查语义相近的文本是否聚集——这已成为评估 embedding 模型(如 Sentence-BERT、E5、BGE)的标准流程。
- RAG 系统调试:在检索增强生成(RAG)系统中,用 UMAP 可视化文档库和查询的 embedding 分布,能直观发现检索失败的原因(如查询向量偏离了相关文档簇)。
- Prompt 工程辅助:可视化不同 prompt 的 embedding 位置,帮助理解哪些 prompt 更接近目标内容。
- 多模态对齐可视化:用降维方法检查图像和文本 embedding 是否在共享空间中对齐(如 CLIP 模型的 embedding 空间)。
单细胞多模态降维
Section titled “单细胞多模态降维”生物信息学领域催生了 scVI(single-cell Variational Inference)等深度学习降维模型,基于变分自编码器处理单细胞测序数据的批次效应、dropout 和多模态整合。2025 年的相关进展包括:
- scVI 的多模态扩展:totalVI、multiVI 等模型整合蛋白质和 RNA 测序数据,统一降维到共享潜在空间。
- scArches:基于 scVI 的迁移学习框架,能在不同实验室、不同批次的数据之间做对齐降维。
- 单细胞分析已成为 UMAP 最大的非 NLP 应用场景之一——几乎每篇单细胞论文都会用 UMAP 可视化细胞类型。
PCA/SVD 加速
Section titled “PCA/SVD 加速”针对超大规模数据(百万级样本),多种加速方案日趋成熟:
- 随机化 SVD(Randomized SVD):利用随机投影大幅加速矩阵分解,scikit-learn 的
PCA已内置svd_solver='randomized'选项。 - GPU 加速:RAPIDS cuML 库提供 GPU 版本的 PCA、t-SNE、UMAP,在百万级数据上比 CPU 快 10-100 倍。
- 分布式 PCA:Spark MLlib 的
PCA和 Facebook 的 PCA 框架支持在集群上分布式计算。 - 2024-2025 年的研究进一步将 GPU 加速和分布式计算引入,使百万级样本的 PCA 在分钟级完成。
其他前沿方向
Section titled “其他前沿方向”- 扩散模型用于降维:研究者开始探索用扩散模型(Diffusion Model)的逆向过程做非线性降维——利用模型学到的数据流形做投影,在极复杂流形上优于传统方法。目前仍在研究阶段。
- Topology-Aware 降维:结合持久同调(Persistent Homology)等拓扑数据分析工具,设计能更好保持数据拓扑特征的降维方法。
- 对比学习与降维:用对比学习目标(如 SimCLR)训练编码器,学到的表示天然具有降维效果,且在下游任务上表现优于传统降维。
- 自监督降维:结合自监督预训练(如 MAE),在大规模无标签数据上学到高质量的降维表示。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| scikit-learn | Python | PCA、KernelPCA、t-SNE、TruncatedSVD、NMF、MDS 等主流降维算法 |
| umap-learn | Python | UMAP 降维库,含 Parametric UMAP,比 t-SNE 更快更好 |
| scipy.linalg | Python | 提供 SVD、特征值分解等底层线性代数运算 |
| PyTorch / TensorFlow | Python | 搭建自编码器、变分自编码器、Parametric UMAP 做非线性降维 |
| openTSNE | Python | t-SNE 的优化实现,支持近似 transform(用回归模型学习映射) |
| pymde | Python | MDE(最小失真嵌入)降维框架,支持自定义保真约束 |
| pacmap | Python | PaCMAP 流形学习算法,参数鲁棒性强 |
| scanpy / scvi-tools | Python | 单细胞数据分析工具链,内置 PCA、UMAP、scVI 等降维方法 |
| RAPIDS cuML | Python/CUDA | GPU 加速版 PCA、t-SNE、UMAP,百万级数据秒级完成 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 主成分 | Principal Component | PCA 中方差最大的投影方向,按特征值大小排序 |
| 解释方差比 | Explained Variance Ratio | 各主成分保留的原始数据方差比例 |
| 流形 | Manifold | 高维数据实际所在的低维曲面/结构 |
| 流形假设 | Manifold Hypothesis | 高维数据近似分布在低维流形上的假设,是降维的理论基础 |
| KL 散度 | KL Divergence | 衡量两个概率分布差异的指标,t-SNE 的优化目标 |
| 交叉熵 | Cross-Entropy | UMAP 中衡量高维与低维拓扑结构差异的目标函数 |
| 困惑度 | Perplexity | t-SNE 的关键超参数,控制有效邻居数量(通常 5-50) |
| 奇异值分解 | SVD | 通用矩阵分解方法 |
| 协方差矩阵 | Covariance Matrix | 描述特征间线性相关性的方阵,PCA 的计算基础 |
| 特征值/特征向量 | Eigenvalue / Eigenvector | 矩阵作用后只缩放不改变方向的方向(特征向量)和缩放倍数(特征值) |
| 核技巧 | Kernel Trick | 不显式计算高维映射,只通过核函数计算内积的方法 |
| 核矩阵 | Kernel Matrix / Gram Matrix | 所有样本对的核函数值构成的矩阵,KPCA 的计算基础 |
| 拥挤问题 | Crowding Problem | 高维到低维体积缩小导致中等距离点被挤在一起的现象 |
| 测地距离 | Geodesic Distance | 沿数据流形表面的距离(而非直线欧氏距离),Isomap 的核心概念 |
| 模糊单纯复形 | Fuzzy Simplicial Complex | UMAP 中用于表示数据拓扑结构的加权图结构 |
| 降维 | Dimensionality Reduction | 将高维数据映射到低维空间同时保留关键信息 |
| 维度灾难 | Curse of Dimensionality | 高维空间中数据稀疏、距离失效、所需样本指数增长的现象 |
| 黎曼几何 | Riemannian Geometry | 研究弯曲空间几何性质的数学分支,UMAP 的理论基础 |
| Nerve 定理 | Nerve Theorem | 拓扑学定理:开集覆盖的交叠结构可恢复原空间的拓扑 |
- PCA:Pearson (1901) / Hotelling (1933),经典统计分析方法,本质是矩阵分解。
- t-SNE:van der Maaten & Hinton, “Visualizing Data using t-SNE” (JMLR 2008),最流行的非线性可视化降维方法。
- UMAP:McInnes et al., “UMAP: Uniform Manifold Approximation and Projection” (2018),比 t-SNE 更快更好。
- Parametric UMAP:Sainburg, McInnes & Gentner, “Parametric UMAP Embeddings for Representation and Semisupervised Learning” (Neural Computation 2021),用神经网络学习 UMAP 映射。
- PaCMAP:Wang et al., “Understanding How Dimensionality Reduction Tools Process Outlying and Clustered Data” (JMLR 2021),PaCMAP 算法及对 t-SNE/UMAP 的系统对比。
- KPCA:Schölkopf et al., “Nonlinear Component Analysis as a Kernel Eigenvalue Problem” (Neural Computation 1998),核 PCA 的开创论文。
- Isomap:Tenenbaum et al., “A Global Geometric Framework for Nonlinear Dimensionality Reduction” (Science 2000),测地距离降维的开创之作。
- 自编码器:Hinton & Salakhutdinov, “Reducing the Dimensionality of Data with Neural Networks” (Science 2006),用神经网络做降维的开创之作。
- LDA:Fisher (1936),线性判别分析,经典的有监督降维方法。
- 降维综述:Cunningham & Ghahramani, “Linear Dimensionality Reduction: Survey, Insights, and Generalizations” (JMLR 2015),系统梳理线性降维方法。
- MDE:Agarwal et al., “Minimum-Distortion Embedding” (Foundations and Trends in Machine Learning, 2021),统一降维框架。
- scVI:Lopez et al., “Deep generative modeling for single-cell transcriptomics” (Nature Methods 2018),单细胞降维的深度学习方法。