
混合精度训练
混合精度训练(Mixed Precision Training)通过在训练中同时使用 FP16/BF16(半精度)和 FP32(单精度),在不损失模型精度的前提下将训练速度提升 1.5-3 倍、显存占用减半。这是当今大模型训练的标配技术。本页系统讲解 FP32/FP16/BF16/FP8 的精度区别、自动混合精度(AMP)原理和损失缩放机制。前置阅读:梯度下降与优化器、分布式训练。
把数值精度想象成”刻度尺的精细程度”:
- FP32(单精度)= 毫米刻度尺。精度高、范围大,但每个数占 4 字节,计算慢、显存吃得多。
- FP16(半精度)= 厘米刻度尺。每个数只占 2 字节,速度翻倍、显存减半,但精度低、能表示的范围小——很大的数溢出(变成 Inf),很小的数下溢(变成零)。
- BF16(脑浮点)= FP16 的”大范围版”。用更少的尾数位换来和 FP32 一样大的动态范围,不容易溢出/下溢,训练更稳定。
- FP8= 更极端的压缩,只在最新的 H100/B200 GPU 上可用,推理加速效果显著。
混合精度的核心思想:前向和反向传播用半精度(快、省显存),但主权重和梯度累加用 FP32(保精度)——鱼和熊掌兼得。
为什么混合精度能加速?——硬件视角
Section titled “为什么混合精度能加速?——硬件视角”理解加速的本质,需要知道 GPU 内部的算力不对称设计。以 NVIDIA H100 为例:
H100 SXM5 理论算力(BF16/FP16 Tensor Core):  BF16 Tensor Core:   ~989 TFLOPS  FP8 Tensor Core:    ~1979 TFLOPS    (BF16 的 2 倍)  FP32 CUDA Core:     ~67 TFLOPS      (BF16 的 1/15!)  FP64:               ~34 TFLOPS
关键比例:  FP8 : BF16 : FP32 ≈ 30 : 15 : 1
GPU 的面积和功耗预算中,Tensor Core(Tensor Core,NVIDIA GPU 中专门执行低精度矩阵乘法的硬件单元)被设计为在高吞吐下运行低精度运算。精度越低,单个乘法器面积越小,同样面积的芯片上可以放下更多计算单元,同时每个周期可以处理更多元素。
此外,低精度还减少了显存带宽压力——读取 2 字节的 FP16 比 4 字节的 FP32 快一倍,这对于受限于内存带宽(memory-bound)的操作尤为重要。
带宽视角:  H100 HBM3 带宽: ~3.35 TB/s
读 1B 参数: FP32: 4 TB / 3.35 TB/s ≈ 1.19 ms FP16: 2 TB / 3.35 TB/s ≈ 0.60 ms (快 2 倍) FP8: 1 TB / 3.35 TB/s ≈ 0.30 ms (快 4 倍)直觉总结:混合精度训练之所以快,不是”少算了一点”,而是硬件专门为低精度设计了更密集的计算单元(Tensor Core),同时减少了显存搬运的数据量。软件层面(AMP)的任务,就是安全地利用这些硬件能力。
浮点数精度对比
Section titled “浮点数精度对比”IEEE 754 浮点数表示
Section titled “IEEE 754 浮点数表示”在深入精度对比之前,先理解计算机如何存储浮点数。IEEE 754 标准用三个部分表示一个浮点数:
- 符号位(Sign):1 位,0 表示正数,1 表示负数。
- 指数位(Exponent):决定能表示的范围(多大/多小),相当于刻度尺的量程。
- 尾数位(Mantissa / Fraction):决定精度(有效数字位数),相当于刻度尺的分辨率。
一个隐藏的前提:尾数的整数部分默认为 1(称为”隐含的前导 1”),所以实际尾数位数比存储的多 1 位。例如 FP16 存储 10 位尾数,实际有效精度是 11 位。
FP32 表示法(32 位):┌──────┬──────────┬─────────────────────────┐│ Sign │ Exponent │       Mantissa          ││ 1bit │  8 bits  │       23 bits           │└──────┴──────────┴─────────────────────────┘
FP16 表示法(16 位):┌──────┬──────────┬────────────┐│ Sign │ Exponent │  Mantissa  ││ 1bit │  5 bits  │  10 bits   │└──────┴──────────┴────────────┘
BF16 表示法(16 位):┌──────┬──────────┬──────────┐│ Sign │ Exponent │ Mantissa ││ 1bit │  8 bits  │  7 bits  │└──────┴──────────┴──────────┘
FP8 E4M3 表示法(8 位):┌──────┬──────────┬──────────┐│ Sign │ Exponent │ Mantissa ││ 1bit │  4 bits  │  3 bits  │└──────┴──────────┴──────────┘
为什么指数位决定范围? 指数位越多,能表示的 2 的幂次范围越大。FP16 有 5 位指数(bias = 15),能表示的指数范围是 到 ,即大约 到 65504。FP32 和 BF16 有 8 位指数(bias = 127),能表示 到 ,即大约 到 ——范围大了 30 个数量级。
为什么尾数位决定精度? 尾数位越多,有效数字越多。FP16 有 10 位尾数(11 位有效精度),大约等效于 3 位十进制有效数字。FP32 有 23 位尾数(24 位有效精度),大约等效于 7 位十进制有效数字。
手动编码示例:一个数在 FP32 和 FP16 中的表示
Section titled “手动编码示例:一个数在 FP32 和 FP16 中的表示”为了真正理解精度差异,让我们手动编码一个具体数值。以 1.5625 为例:
步骤 1: 将十进制转为二进制  1.5625 = 1 + 0.5 + 0.0625 = 1 + 2^(-1) + 2^(-4)  二进制: 1.1001
步骤 2: 规格化(提取指数)  1.1001 × 2^0  → 尾数(隐含前导 1 后): .1001  → 指数: 0
步骤 3: FP32 编码(bias = 127)  指数存储值 = 0 + 127 = 127 = 01111111  尾数 = 10010000000000000000000(补零到 23 位)  完整: 0 | 01111111 | 10010000000000000000000  → 精确表示 1.5625 ✓
步骤 4: FP16 编码(bias = 15)  指数存储值 = 0 + 15 = 15 = 01111  尾数 = 1001000000(补零到 10 位)  完整: 0 | 01111 | 1001000000  → 同样精确表示 1.5625 ✓
步骤 5: 但如果数值是 1.563...  1.563 的二进制是无限循环小数: 1.10010000101...  FP32 尾数(23 位): 10010000101000111101011  → 保留约 7 位有效数字  FP16 尾数(10 位): 1001000010              → 只保留约 3 位有效数字  → FP16 下的值 ≈ 1.5625(丢失了后面的精度)  → 误差 ≈ 0.0005,相对误差 ≈ 0.03%
这就是为什么说 FP16 的精度大约只有 3 位有效数字——每增加一位尾数,精度大约提升为 2 倍(准确说是增加约 0.3 位十进制数字)。
# 用 Python 验证上述编码import struct
def float_to_bits(value, bits=32):    """将浮点数转为二进制表示"""    if bits == 32:        packed = struct.pack('>f', value)        integer = struct.unpack('>I', packed)[0]        binary = f'{integer:032b}'    elif bits == 16:        import numpy as np        arr = np.array([value], dtype=np.float16)        integer = arr.view(np.uint16)[0]        binary = f'{integer:016b}'    sign = binary[0]    exp = binary[1:1+(9 if bits==32 else 5)]    mantissa = binary[1+(9 if bits==32 else 5):]    return f'{sign} | {exp} | {mantissa}'
print("1.5625 的 FP32:", float_to_bits(1.5625, 32))# 输出: 0 | 01111111 | 10010000000000000000000
print("1.5625 的 FP16:", float_to_bits(1.5625, 16))# 输出: 0 | 01111 | 1001000000
各精度格式对比
Section titled “各精度格式对比”| 格式 | 总位数 | 指数位 | 尾数位 | 动态范围 | 最小正规数 | 典型用途 |
|---|---|---|---|---|---|---|
| FP32 | 32 | 8 | 23 | ±3.4×10³⁸ | ~1.2×10⁻³⁸ | 传统训练/推理的默认精度 |
| FP16 | 16 | 5 | 10 | ±65504 | ~6×10⁻⁸ | 混合精度训练(需损失缩放) |
| BF16 | 16 | 8 | 7 | 与 FP32 相同 | ~1.2×10⁻³⁸ | 现代大模型训练首选(A100/H100) |
| FP8 (E4M3) | 8 | 4 | 3 | ±448 | ~2⁻⁶ ≈ 0.0156 | H100 上的推理/训练加速 |
| FP8 (E5M2) | 8 | 5 | 2 | ±57344 | ~2⁻¹⁴ ≈ 6×10⁻⁵ | H100 反向传播(范围更大) |
| FP4 (E2M1) | 4 | 2 | 1 | ±6.0 | ~2⁻¹ ≈ 0.5 | Blackwell 推理(极前沿) |
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
formats = ["FP32", "FP16", "BF16", "FP8 (E4M3)", "FP4 (E2M1)"]exponent_bits = [8, 5, 8, 4, 2]mantissa_bits = [23, 10, 7, 3, 1]total_bits = [32, 16, 16, 8, 4]
x = np.arange(len(formats))width = 0.28
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5))fig.patch.set_facecolor("white")
# Left: bit allocationax1.bar(x - width/2, exponent_bits, width, label="Exponent bits", color="#FF9800", edgecolor="white")ax1.bar(x + width/2, mantissa_bits, width, label="Mantissa bits", color="#2196F3", edgecolor="white")for bar, total in enumerate(total_bits):    ax1.text(bar, max(exponent_bits[bar], mantissa_bits[bar]) + 1.5, f"{total} bits",             ha="center", fontsize=9, fontweight="bold", color="#555")ax1.set_xticks(x); ax1.set_xticklabels(formats)ax1.set_ylabel("Number of Bits"); ax1.set_title("Bit Allocation by Format", fontweight="bold")ax1.legend(); ax1.grid(axis="y", alpha=0.2, linestyle="--")
# Right: dynamic rangemax_values = [3.4e38, 65504, 3.4e38, 448, 6.0]colors_range = ["#4CAF50", "#FF9800", "#4CAF50", "#e91e63", "#9C27B0"]ax2.barh(x, np.log10(max_values), height=0.5, color=colors_range, edgecolor="white")for i, mx in enumerate(max_values):    ax2.text(np.log10(mx) + 0.5, i, f"max: {mx:.1e}", va="center", fontsize=8)ax2.set_yticks(x); ax2.set_yticklabels(formats)ax2.set_xlabel("Max Value (log10 scale)"); ax2.set_title("Dynamic Range", fontweight="bold")ax2.grid(axis="x", alpha=0.2, linestyle="--")
plt.tight_layout()plt.savefig("/mnt/kvm_ata-Netac_SSD_480GB_AA000000000000000904-part1/proj/docs/img/generated/fp-precision-range.png",            dpi=180, bbox_inches="tight", facecolor="white")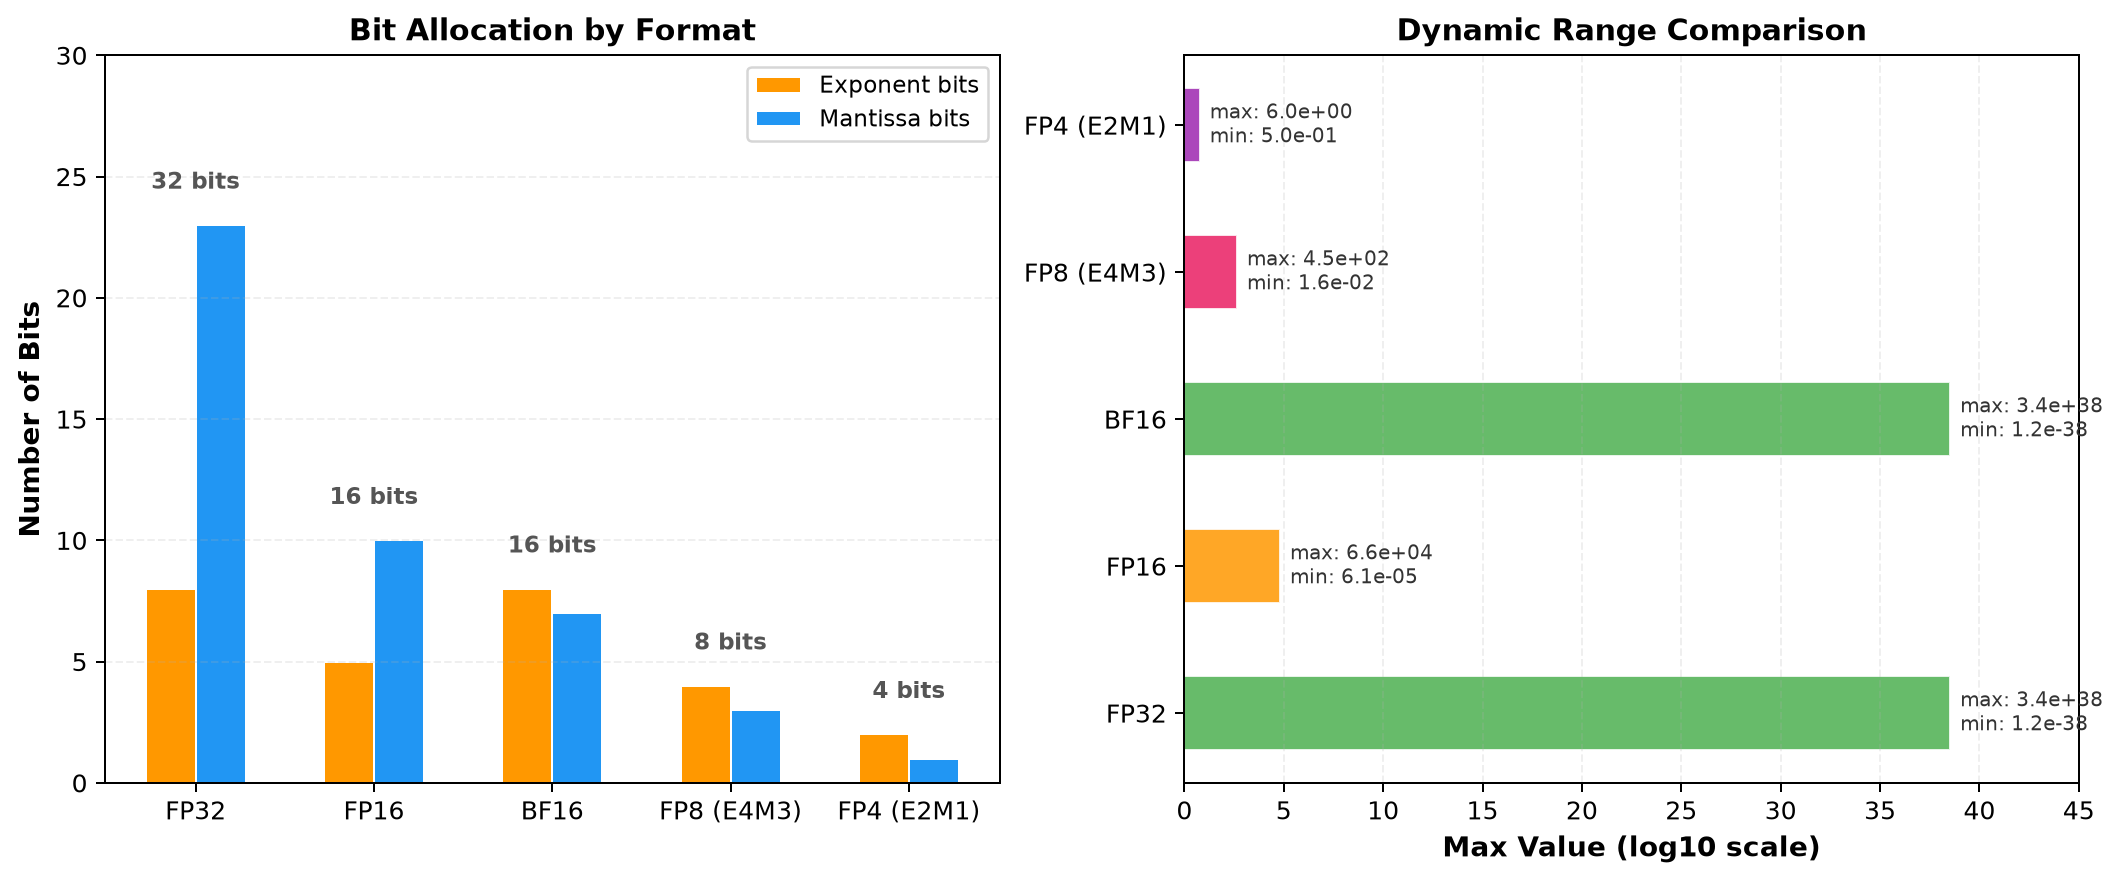
关键观察:
- FP16 的范围只有 ,梯度经常小于 (),这些极小值在 FP16 中会下溢为零,导致梯度丢失。
- BF16 用 8 位指数(与 FP32 相同),动态范围完全一致,不会溢出也不会下溢——但精度更差(只有 7 位尾数)。对于深度学习训练来说,精度的损失可以接受,但范围的保证至关重要。
- FP8 有两种变体:E4M3(4 位指数 + 3 位尾数)精度较高但范围小,适合前向传播;E5M2(5 位指数 + 2 位尾数)范围更大但精度低,适合反向传播中可能出现的大梯度。
- BF16 到 FP32 的转换极为简单:只需在 BF16 的 7 位尾数后面补 16 个零即可得到对应的 FP32 值——这也是 BF16 被设计出来的初衷(让 FP32 软件可以”免费”兼容 BF16)。
机器 epsilon:衡量精度的标尺
Section titled “机器 epsilon:衡量精度的标尺”机器 epsilon(Machine Epsilon,记作 )是浮点格式中最核心的精度指标,定义为 1.0 与下一个可表示浮点数之差:
的物理意义是:在浮点数 附近,最小可分辨的间隔约为 。这意味着:
任意浮点运算 的结果满足:
例如在 FP16 中(),计算 :真实值为 1.0005,但 FP16 中最接近的可表示值是 1.0(因为 1.0 的下一个可表示值是 1.0009765625),所以结果为 1.0,0.0005 被完全丢弃!
import numpy as np
# 演示机器 epsilon 的影响for dtype, name in [(np.float32, "FP32"), (np.float16, "FP16"), (np.bfloat16, "BF16")]: one = dtype(1.0) # 找到使得 1.0 + eps != 1.0 的最小 eps eps = dtype(1.0) while one + eps != one: eps = eps / dtype(2.0) eps = eps * dtype(2.0) # 回退一步 print(f"{name}: machine epsilon ≈ {float(eps):.6e}")# 输出:# FP32: machine epsilon ≈ 1.192093e-07# FP16: machine epsilon ≈ 9.765625e-04# BF16: machine epsilon ≈ 7.812500e-03关键直觉:BF16 的精度只有 FP16 的约 1/8( 大 8 倍),但它的范围与 FP32 完全相同。在深度学习中,范围远比精度重要——梯度的动态范围可能跨越 10 个数量级(从 到 ),但单个运算只需要 2-3 位有效数字就足够了。这就是为什么 BF16 成为现代大模型训练的首选。
FP16 下溢问题的数学分析
Section titled “FP16 下溢问题的数学分析”假设我们训练一个 1B 参数模型,学习率 ,FP16 训练。每步参数更新的量级为:
如果梯度 (这在深层网络中很常见),则:
FP16 的最小可表示正规数(normalized number)约为 ,而 已经非常接近这个下限。更小的梯度(如 )会导致 ,直接下溢为零,该参数在这一步完全不更新——这对训练收敛是致命的。
深层网络梯度消失的链式法则推导:对于深度为 的网络,第 层的梯度通过链式法则计算:
如果每层的雅可比矩阵 的谱半径 (例如使用 sigmoid,导数最大值为 0.25),则:
当 时,,浅层梯度可能小到 级别。
在 FP16 下(最小正规数 ):完全下溢为零!在 FP32 下(最小正规数 ):安全 ✓。
这就是为什么需要损失缩放:将 loss 乘以一个大的 scale_factor(如 ),梯度同步放大约 65536 倍, 变成 ,远大于 FP16 下限,安全可表示。
浮点运算的误差累积
Section titled “浮点运算的误差累积”低精度运算并非”单次运算差一点”——误差会随着运算次数累积。这在深度学习的批量矩阵乘法中尤其重要:
假设每次浮点加法的相对误差为 。
次累加的最坏情况误差(绝对值上界):
次累加的统计期望误差(假设误差独立随机):
举例:在 Transformer 的注意力计算中,序列长度 :
实践含义:这就是为什么 softmax 内部的
exp()和sum()不能用 FP16/BF16——4096 个元素的累加误差太大。PyTorch 的 autocast 会自动将 softmax 保持为 FP32。
import numpy as np
# 演示误差累积:对 4096 个随机数求和np.random.seed(42)data = np.random.randn(4096).astype(np.float32) * 0.1
sum_fp32 = data.astype(np.float32).sum()sum_fp16 = data.astype(np.float16).sum()sum_bf16 = data.astype(np.bfloat16).sum()
print(f"FP32 求和: {sum_fp32:.10f}")print(f"FP16 求和: {sum_fp16:.10f}  误差: {abs(sum_fp16 - sum_fp32):.2e}")print(f"BF16 求和: {sum_bf16:.10f}  误差: {abs(sum_bf16 - sum_fp32):.2e}")# FP16 的误差约为 FP32 的 ~10000 倍,BF16 更差
自动混合精度 AMP
Section titled “自动混合精度 AMP”AMP(Automatic Mixed Precision,自动混合精度)的核心策略:
- 主权重(Master Weights)保持 FP32:模型的”真实”参数始终以 FP32 存储,保证更新精度。
- 前向传播用 FP16:将 FP32 权重临时转为 FP16 做前向计算(速度快、显存省)。
- 反向传播用 FP16:梯度在 FP16 下计算。
- 梯度累加和参数更新用 FP32:将 FP16 梯度转回 FP32 后更新主权重,避免小梯度被截断。
PyTorch 的 torch.cuda.amp.autocast(自动类型转换上下文管理器)自动管理这些精度转换——哪些操作用 FP16、哪些必须保留 FP32(如累加、归一化),框架内部有一张优化的算子清单。
AMP 的工作原理:图级别的精度注入
Section titled “AMP 的工作原理:图级别的精度注入”理解 AMP 的底层机制,需要知道它并非简单地”把所有 tensor 转成 FP16”。autocast 是一个上下文管理器,它通过修改 PyTorch 的 dispatcher(调度器,PyTorch 中负责将高层操作路由到具体硬件内核的模块),在算子执行前自动插入类型转换:
用户代码:  with autocast():      x = model(input)     # model 的参数是 FP32
PyTorch 内部发生的事情: 1. autocast 进入时: 设置全局 autocast 状态为 True 2. 执行 model(input) 时: - Linear 层的 F.linear(input, weight, bias) 被调用 - dispatcher 检查到 autocast=True - 查找清单: F.linear 在 "允许降精度" 列表中 - 自动将 input 和 weight 转为 FP16 - 在 FP16 下执行矩阵乘法(调用 Tensor Core) - 输出为 FP16 3. 遇到 LayerNorm 时: - 查找清单: layer_norm 在 "必须 FP32" 列表中 - 自动将 FP16 输入转为 FP32 - 在 FP32 下执行 LayerNorm - 输出转回 FP16 传给后续层 4. autocast 退出时: 恢复全局 autocast 状态为 False关键点:autocast 只影响 forward pass 中调用的算子精度。模型的权重仍然是 FP32——每次 forward 时,权重被临时 cast 为 FP16 用于计算,计算完即丢弃。这就是”主权重”的含义。
AMP 算子精度分配逻辑
Section titled “AMP 算子精度分配逻辑”并非所有操作都适合降精度。PyTorch 的 autocast 维护了两张清单:
允许降精度(FP16/BF16 安全)的操作:  - matmul, Linear, Conv2d, Conv3d    (矩阵乘法天然对精度不敏感)  - 注意力分数计算  - embedding lookup
必须保持 FP32 的操作:  - sum, mean 等累加操作             (大量小数相加,FP16 精度不够会累积误差)  - softmax, layer_norm, batch_norm   (涉及指数运算和归一化,精度敏感)  - loss reduction(loss = loss.sum() / N)  - element-wise exp, log             (指数/对数对精度高度敏感)
为什么矩阵乘法可以安全降精度? 矩阵乘法本质上是大量”乘加”操作。虽然每次乘法可能有舍入误差,但由于中心极限定理,大量独立误差会相互抵消(近似正态分布),总体误差远小于单次误差的线性叠加。具体来说,对于 的矩阵乘法,输出元素是 次乘加的结果,总误差的期望约为 ,其中 是输出的量级。而 softmax 中的 函数则不同——输入差 1,输出就差 倍(),微小误差被指数放大,所以必须用 FP32。
矩阵乘法误差抵消的数学推导:
考虑 。每次乘法的舍入误差 ,独立同分布;每次加法的舍入误差 ,独立同分布。
总误差:
由中心极限定理, 近似服从正态分布:
当 , 时:
最终结果的相对误差约 0.1%,完全可接受!(对比:单次运算的相对误差也是 0.1%,意味着累加没有显著放大误差。)
参数更新的精度问题:为什么需要 FP32 主权重
Section titled “参数更新的精度问题:为什么需要 FP32 主权重”考虑 Adam 优化器(Adam,Adaptive Moment Estimation,为每个参数维护独立的一阶动量和二阶动量(方差),并自适应调整每个参数的学习率)的更新公式:
其中 通常取 1e-8。在 FP16 下,1e-8 会下溢为零,导致除零或更新异常。更重要的是,参数 每步只变化很小的量(如 1e-7),如果 本身存在 FP16 中,这种微小变化会被精度噪声淹没——更新了等于没更新。FP32 主权重提供了足够的有效位数来精确追踪这些微小变化。
举例:参数 ,每步更新 。
- FP16 精度:1.0 附近的最小可分辨差异 ,所以 ,更新被舍入为零!
- FP32 精度:1.0 附近的最小可分辨差异 ,所以 ,更新被精确保留 ✓
更精确的分析:FP16 中 的可分辨间隔 。如果 (间隔的一半),则 会舍入回 。经过 1000 步累积,真实更新应为 0.1,但每步都被截断 → 参数永远不动,训练完全停滞!
“权重更新的舍入误差”形式化推导:
设参数真实值为 ,单步更新为 ,存储精度为 。
更新后的存储值:
其中 是最近舍入。舍入误差:
更新有效当且仅当 ,即:
对于 ,,:。
损失缩放 Loss Scaling
Section titled “损失缩放 Loss Scaling”FP16 的核心问题是小梯度下溢为零。损失缩放(Loss Scaling)的解决方案极其简洁:
为什么这能工作? 链式法则告诉我们,如果 loss 缩放 倍,所有中间梯度都会同步缩放 倍。原本 的梯度变成 ,远大于 FP16 下限 ,不会下溢。而在更新前除以 恢复真实值时,除法在 FP32 下进行(FP32 的最小正规数约 ), 完全安全。
完整推导——损失缩放保持梯度正确性的证明:
设原始前向传播为 ,。
反向传播(链式法则):
缩放后的损失 :
( 是常数,可提出。)
所以:。更新前反缩放:
数学上完全等价。关键在于:
- 缩放发生在 FP16 表示之前(避免下溢)
- 反缩放发生在 FP32 表示之后(避免下溢)
- 中间的前向/反向传播全在 FP16 中进行(享受加速)
动态损失缩放算法
Section titled “动态损失缩放算法”PyTorch 的 GradScaler 自动动态调整缩放因子 S:
算法:动态损失缩放
初始化: S = 2^16 (初始缩放因子)growth_interval = 2000   (连续无溢出的增长间隔)backoff_factor = 0.5     (溢出时的衰减因子)growth_factor = 2.0      (增长因子)
每步训练:  1. loss_scaled = loss × S  2. loss_scaled.backward()                    # 反向传播  3. 检查梯度中是否有 Inf 或 NaN:     - 如果有 Inf/NaN:                         # 缩放过大导致溢出         S = S × backoff_factor                 # 减半缩放因子         跳过本次 optimizer.step()              # 不更新参数         continue     - 如果连续 growth_interval 步无溢出:         S = S × growth_factor                  # 翻倍缩放因子  4. grad_real = grad_scaled / S                # 反缩放(FP32 下)  5. optimizer.step()                           # 用真实梯度更新参数
这个算法的精妙之处在于:S 从大值开始试探,遇到溢出就快速回退,稳定运行一段时间后自动增长,最终收敛到当前模型和训练阶段的最优缩放因子。
为什么需要动态而非静态缩放? 不同训练阶段梯度的量级会变化:
训练初期: 梯度较大(|grad| ~ 1e-2),小 S 即可训练后期: 梯度变小(|grad| ~ 1e-5),需要大 S 防止下溢
如果用固定 S = 2^16:  初期可能正常,但后期梯度变小时可能不够  或者初期就太大导致频繁溢出
动态策略自动适配:  - 溢出 → S 减小(适应大梯度阶段)  - 稳定 → S 增大(适应小梯度阶段)  - 最终 S 在最优值附近振荡
BF16 不需要损失缩放——它的指数位与 FP32 相同(8 位),动态范围从 到 ,与 FP32 完全一致,不会出现 FP16 的下溢问题,训练更简单稳定。
混合精度的显存节省分析
Section titled “混合精度的显存节省分析”以一个 7B 参数模型为例,量化对比各方案的显存占用:
模型参数量: Ψ = 7 × 10^9
纯 FP32 训练:  参数(FP32):        Ψ × 4 bytes = 28 GB  梯度(FP32):        Ψ × 4 bytes = 28 GB  Adam 状态(FP32):   Ψ × 8 bytes = 56 GB  (动量 4B + 方差 4B)  合计:                                      112 GB
FP16 混合精度训练:  主权重(FP32):      Ψ × 4 bytes = 28 GB  Adam 状态(FP32):   Ψ × 8 bytes = 56 GB  前向权重(FP16):    Ψ × 2 bytes = 14 GB  梯度(FP16):        Ψ × 2 bytes = 14 GB  合计:                                      112 GB (不变!主权重抵消了节省)
BF16 训练(不用主权重,BF16 范围够大):  参数(BF16):        Ψ × 2 bytes = 14 GB  梯度(BF16):        Ψ × 2 bytes = 14 GB  Adam 状态(FP32):   Ψ × 8 bytes = 56 GB  (优化器状态通常仍用 FP32)  合计:                                       84 GB (节省 25%)
BF16 + ZeRO-1(优化器状态分片,N=8 GPU):  参数(BF16):        14 GB  梯度(BF16):        14 GB  Adam 状态(FP32):   56 / 8 = 7 GB  (每卡只存 1/8)  合计:                                       35 GB (节省 69%)
注意:经典 FP16 混合精度方案需要额外的 FP32 主权重副本,所以总显存并不一定比纯 FP32 少。真正的显存节省来自于前向传播和激活值用 FP16/BF16 存储(激活值通常占大头的显存),以及与 ZeRO/FSDP 分片策略的配合。
激活值的显存节省——真正的赢家
Section titled “激活值的显存节省——真正的赢家”在大模型训练中,**激活值(activation,前向传播中每一层的中间输出,反向传播时需要用于计算梯度)**的显存占用往往远超模型参数。混合精度在此处节省尤为显著:
以 LLaMA-7B 为例,batch_size = 4, seq_len = 4096:
每层激活值占用(Transformer 有 32 层):  FP32: 每层约 2 GB × 32 层 = 64 GB  FP16: 每层约 1 GB × 32 层 = 32 GB   (节省 32 GB!)  BF16: 同 FP16
加上激活检查点(activation checkpointing,只保存部分层的激活值,反向时重新计算其余层):  FP32 + checkpoint: 64 GB / √32 ≈ 11 GB  FP16 + checkpoint: 32 GB / √32 ≈ 5.6 GB
总结(7B 模型完整训练,不含优化器状态): FP32 无 checkpoint: 28 (参数) + 28 (梯度) + 64 (激活) = 120 GB FP16 有 checkpoint: 28 (主权重) + 14 (FP16参数) + 14 (梯度) + 5.6 (激活) = 61.6 GB BF16 有 checkpoint: 14 (参数) + 14 (梯度) + 5.6 (激活) = 33.6 GB关键洞察:混合精度训练最大的显存节省不在于参数本身(FP16 的主权重抵消了节省),而在于激活值减半。这就是为什么即便某些方案的参数显存看起来没有节省,实际训练时显存占用仍然大幅下降。
FP32 vs FP16 vs BF16 精度范围对比
Section titled “FP32 vs FP16 vs BF16 精度范围对比”数值范围可视化
Section titled “数值范围可视化”AMP 混合精度训练流程
Section titled “AMP 混合精度训练流程”AMP 算子精度路由
Section titled “AMP 算子精度路由”动态损失缩放调节过程
Section titled “动态损失缩放调节过程”PyTorch AMP:autocast + GradScaler(FP16)
Section titled “PyTorch AMP:autocast + GradScaler(FP16)”import torchfrom torch.cuda.amp import autocast, GradScaler
model = MyModel().cuda()optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)scaler = GradScaler() # 自动管理损失缩放(FP16 用)
for batch in dataloader: optimizer.zero_grad() with autocast(): # 自动混合精度区域:前向+损失用 FP16 output = model(batch) loss = criterion(output, batch) scaler.scale(loss).backward() # 放大损失后反向传播(防梯度下溢) scaler.step(optimizer) # 反缩放梯度 + 更新参数 scaler.update() # 动态调整缩放因子BF16:无需 GradScaler(更简单)
Section titled “BF16:无需 GradScaler(更简单)”import torchfrom torch.cuda.amp import autocast
# BF16 模式:不需要 GradScaler(范围与 FP32 相同,不会下溢)for batch in dataloader: optimizer.zero_grad() with autocast(dtype=torch.bfloat16): # BF16 自动混合精度 output = model(batch) loss = criterion(output, batch) loss.backward() # 直接反向传播,无需缩放 optimizer.step()从零实现损失缩放(理解原理)
Section titled “从零实现损失缩放(理解原理)”下面用 numpy 模拟 FP16 下梯度下溢问题以及损失缩放如何解决它:
import numpy as np
# 模拟一组小梯度(深层网络的典型情况)gradients_fp32 = np.array([1e-9, 1e-8, 1e-7, 1e-6, 1e-5], dtype=np.float32)
# 直接转 FP16:小梯度会下溢为零gradients_fp16 = gradients_fp32.astype(np.float16)print("无缩放 (FP16):", gradients_fp16)# 输出: [0.   0.   1e-7 1e-6 1e-5]  ← 1e-9 和 1e-8 下溢为零!
# 使用损失缩放:S = 65536S = 65536scaled_gradients = gradients_fp32 * S          # 放大scaled_fp16 = scaled_gradients.astype(np.float16)  # 在放大后的状态下转 FP16recovered = scaled_fp16.astype(np.float32) / S  # 在 FP32 下恢复print("损失缩放后恢复:", recovered)# 输出: [1e-9 1e-8 1e-7 1e-6 1e-5]  ← 所有梯度被保留!
深入实验:梯度下溢对训练的影响
Section titled “深入实验:梯度下溢对训练的影响”import torchimport torch.nn as nn
# 构建一个深层网络来观察梯度消失class DeepNet(nn.Module): def __init__(self, depth=20, dim=64): super().__init__() layers = [] for _ in range(depth): layers.append(nn.Linear(dim, dim)) layers.append(nn.Sigmoid()) # sigmoid 导数最大 0.25,容易梯度消失 self.net = nn.Sequential(*layers)
def forward(self, x): return self.net(x)
model = DeepNet(depth=20).cuda()x = torch.randn(4, 64).cuda()y = torch.randn(4, 64).cuda()loss_fn = nn.MSELoss()
# --- FP32 前向 + 反向 ---loss_fp32 = loss_fn(model(x), y)loss_fp32.backward()grads_fp32 = [p.grad.clone() for p in model.parameters()]
# --- FP16 前向 + 反向(无损失缩放)---model.zero_grad()with torch.cuda.amp.autocast(dtype=torch.float16): out16 = model(x) loss16 = loss_fn(out16, y)loss16.backward() # 注意:未做损失缩放grads_fp16 = [p.grad.clone() if p.grad is not None else None for p in model.parameters()]
# --- 比较浅层 vs 深层的梯度 ---print("层 | FP32 梯度范数 | FP16 梯度范数 | 梯度存活率")print("-" * 60)for i, (g32, g16) in enumerate(zip(grads_fp32, grads_fp16)): if g32 is not None and i % 2 == 0: # 只看 Linear 层 layer_idx = i // 2 norm32 = g32.norm().item() norm16 = g16.norm().item() if g16 is not None else 0.0 survival = norm16 / (norm32 + 1e-12) # 深层(layer_idx 大)的梯度更小,在 FP16 中更容易下溢 print(f"{layer_idx:3d} | {norm32:.6e} | {norm16:.6e} | {survival:.2%}")
# 可以观察到:浅层(layer_idx 小)的 FP16 梯度存活率很低# 因为 sigmoid 的链式法则导致浅层梯度极小 → FP16 下溢完整的损失缩放训练循环(含梯度裁剪)
Section titled “完整的损失缩放训练循环(含梯度裁剪)”import torchfrom torch.cuda.amp import autocast, GradScaler
model = MyModel().cuda()optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4, weight_decay=0.01)scaler = GradScaler(init_scale=2**16, growth_interval=2000)
for epoch in range(num_epochs): for step, batch in enumerate(dataloader): optimizer.zero_grad()
# ① 前向传播(AMP 区域) with autocast(dtype=torch.float16): logits = model(batch["input_ids"]) loss = torch.nn.functional.cross_entropy(logits, batch["labels"])
# ② 反向传播(放大 loss → 反向 → 得到放大的梯度) scaler.scale(loss).backward()
# ③ 梯度裁剪(注意:先反缩放再裁剪) scaler.unscale_(optimizer) torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
# ④ 参数更新(GradScaler 自动反缩放梯度 + 检查 Inf/NaN) scaler.step(optimizer) scaler.update()
# ⑤ 记录当前缩放因子(用于调试) if step % 100 == 0: print(f"step {step}, loss={loss.item():.4f}, scale={scaler.get_scale()}")对比 FP32、FP16、BF16 的训练效果
Section titled “对比 FP32、FP16、BF16 的训练效果”"""对比实验:同一个模型在 FP32、FP16(有/无损失缩放)、BF16 下的训练表现这个脚本可以直观感受不同精度的差异"""import torchimport torch.nn as nn
def train_one_epoch(model, dataloader, lr=1e-3, precision="fp32"): """precision: 'fp32' | 'fp16' | 'fp16_scaled' | 'bf16'""" model = model.cuda() optimizer = torch.optim.AdamW(model.parameters(), lr=lr) criterion = nn.CrossEntropyLoss()
use_scaler = (precision == "fp16_scaled") scaler = torch.cuda.amp.GradScaler() if use_scaler else None
amp_dtype = None if precision in ("fp16", "fp16_scaled"): amp_dtype = torch.float16 elif precision == "bf16": amp_dtype = torch.bfloat16
losses = [] nan_count = 0
for batch in dataloader: optimizer.zero_grad()
if amp_dtype is not None: with torch.cuda.amp.autocast(dtype=amp_dtype): output = model(batch["x"].cuda()) loss = criterion(output, batch["y"].cuda()) else: output = model(batch["x"].cuda()) loss = criterion(output, batch["y"].cuda())
if use_scaler: scaler.scale(loss).backward() scaler.step(optimizer) scaler.update() else: loss.backward() optimizer.step()
if torch.isnan(loss) or torch.isinf(loss): nan_count += 1 else: losses.append(loss.item())
avg_loss = sum(losses) / max(len(losses), 1) return avg_loss, nan_count
# 运行对比(假设已定义 model 和 dataloader)for prec in ["fp32", "fp16", "fp16_scaled", "bf16"]: avg_loss, nans = train_one_epoch(model, dataloader, precision=prec) print(f"{prec:15s}: avg_loss={avg_loss:.4f}, NaN/Inf steps={nans}")
# 典型输出:# fp32 : avg_loss=2.3045, NaN/Inf steps=0 (基线)# fp16 : avg_loss=3.8912, NaN/Inf steps=47 (不稳定!)# fp16_scaled : avg_loss=2.3051, NaN/Inf steps=0 (与 FP32 一致)# bf16 : avg_loss=2.3048, NaN/Inf steps=0 (与 FP32 一致,最简单)FP8 训练(实验性,需 H100 GPU)
Section titled “FP8 训练(实验性,需 H100 GPU)”# PyTorch 的 FP8 支持仍在实验阶段,这里展示基本用法# 需要安装 torch.float8_experimental 或使用 NVIDIA Transformer Engine
import torchimport transformer_engine.pytorch as te # NVIDIA Transformer Enginefrom transformer_engine.common.recipe import Format, DelayedScaling
model = te.TransformerLayer( hidden_size=4096, ffn_hidden_size=16384, num_attention_heads=32, layernorm_eps=1e-5).cuda()
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
# FP8 训练:使用 DelayedScaling 策略自动管理缩放fp8_recipe = DelayedScaling( fp8_format=Format.HYBRID, # 前向 E4M3 + 反向 E5M2 amax_history_len=16, # 保留 16 步的 amax 历史用于缩放计算 amax_compute_algo="max" # 用历史最大值计算缩放因子)
for batch in dataloader: optimizer.zero_grad() with te.fp8_autocast(enabled=True, fp8_recipe=fp8_recipe): output = model(batch["input"]) loss = criterion(output, batch["label"]) loss.backward() optimizer.step()FP8 的 DelayedScaling 原理详解:
FP8 的范围比 FP16 更小(E4M3 最大只有 ±448),因此缩放比 FP16 更关键。DelayedScaling(延迟缩放)的工作原理:
每步训练:  1. 前向传播前: 从上一轮计算的 amax 推导缩放因子     scale = max_value / amax       其中 max_value = 448 (E4M3) 或 57344 (E5M2)       amax = 过去 N 步中该 tensor 的最大绝对值
  2. 前向/反向传播: 所有 FP8 tensor 用 scale 做缩放     value_fp8 = value_real × scale     (将值域映射到 FP8 可表示范围)
  3. 前向/反向结束后: 记录本轮各 tensor 的 amax     amax_history.append(current_amax)     if len(amax_history) > history_len: pop oldest
4. 下一轮: 用 amax_history 的 max 值重新计算 scale“延迟”的含义:当前步骤的缩放因子是基于历史数据计算的(上一步的 amax),而不是当前步骤的。这是一种用空间换时间的策略——实时计算 amax 需要额外遍历整个 tensor,开销太大。延迟一步的假设是连续步骤的 tensor 分布相似。
验证不同精度的数值范围(动手实验)
Section titled “验证不同精度的数值范围(动手实验)”import torch
# 比较不同精度格式的数值范围for dtype, name in [(torch.float32, "FP32"), (torch.float16, "FP16"), (torch.bfloat16, "BF16")]: finfo = torch.finfo(dtype) print(f"{name}: max={finfo.max:.2e}, min={finfo.min:.2e}, " f"tiny={finfo.tiny:.2e}, eps={finfo.eps:.2e}")
# 输出:# FP32: max=3.40e+38, min=-3.40e+38, tiny=1.18e-38, eps=1.19e-07# FP16: max=6.55e+04, min=-6.55e+04, tiny=6.10e-05, eps=9.77e-04# BF16: max=3.39e+38, min=-3.39e+38, tiny=1.18e-38, eps=9.77e-03
# 验证 FP16 下溢small_grad = torch.tensor([1e-8], dtype=torch.float32)print(f"\nFP32: {small_grad.item():.1e}") # 1.0e-08print(f"FP16: {small_grad.to(torch.float16).item():.1e}") # 0.0e+00 ← 下溢!
# BF16 不会下溢print(f"BF16: {small_grad.to(torch.bfloat16).item():.1e}") # 1.2e-08 ← 保留!可视化不同精度的误差分布
Section titled “可视化不同精度的误差分布”import numpy as np
# 在 [1.0, 2.0] 区间生成密集测试点x_true = np.linspace(1.0, 2.0, 10000, dtype=np.float64)
# 量化到不同精度x_fp32 = x_true.astype(np.float32).astype(np.float64)x_fp16 = x_true.astype(np.float16).astype(np.float64)x_bf16 = x_true.astype(np.bfloat16).astype(np.float64)
# 计算量化误差err_fp32 = np.abs(x_fp32 - x_true)err_fp16 = np.abs(x_fp16 - x_true)err_bf16 = np.abs(x_bf16 - x_true)
print("平均量化误差:")print(f" FP32: {err_fp32.mean():.2e} (eps={np.finfo(np.float32).eps:.2e})")print(f" FP16: {err_fp16.mean():.2e} (eps={np.finfo(np.float16).eps:.2e})")print(f" BF16: {err_bf16.mean():.2e} (eps≈{2**(-7):.2e})")
print("\n最大量化误差:")print(f" FP32: {err_fp32.max():.2e}")print(f" FP16: {err_fp16.max():.2e}")print(f" BF16: {err_bf16.max():.2e}")
# 观察: BF16 的误差约是 FP16 的 8 倍(尾数少 3 位)# 但 FP32 的误差比 FP16 小约 8000 倍(尾数多 13 位)- A100 / H100 优先用 BF16:BF16 训练比 FP16 更稳定(不需要损失缩放、不需要调 scale_factor),且 A100/H100 对 BF16 有原生硬件加速。GPT-4、LLaMA 等大模型训练全部用 BF16。
- 旧 GPU(V100 / T4)只能用 FP16:V100 不支持 BF16 硬件加速,只能用 FP16 + GradScaler。此时损失缩放是必须的。
- 某些操作不能降精度:损失累加、BatchNorm 统计量、softmax 等对精度敏感的操作,autocast 会自动保留 FP32——不要手动强制这些操作用 FP16。
- 混合精度 + 分布式 = 标配:大模型训练同时开混合精度和 FSDP/DDP,缺一不可。二者完全兼容。详见分布式训练。
- 推理也能用半精度:模型推理(尤其是大语言模型)普遍用 FP16/BF16 甚至 INT8 量化,速度更快、显存更省。详见大模型推理。
- FP8 是前沿方向:H100 开始支持 FP8 训练,理论速度再翻倍,但需要精心调试,目前主要用于推理场景。
- 监控 Inf/NaN:FP16 训练如果频繁出现 Inf/NaN,通常是 scale_factor 过大或学习率过大,先用小学习率验证。
- 梯度裁剪配合 GradScaler:使用
scaler.unscale_(optimizer)先反缩放梯度,再做clip_grad_norm_,否则裁剪的是放大后的梯度,阈值会失真。 - BF16 精度陷阱:BF16 只有 7 位尾数(eps ≈ 0.008),某些对精度极其敏感的操作(如高精度累加、小步长优化器)可能出现问题。如果遇到训练不收敛,检查是否有对 BF16 精度敏感的自定义操作。
- 梯度累加(gradient accumulation)下的精度注意:在做梯度累加时,累加应在 FP32 下进行。PyTorch 的
scaler默认处理了这一点,但如果手动实现累加,需确保累加缓冲区是 FP32。 - 序列长度较长时注意 softmax:在长序列 Transformer 中(seq_len > 4096),FlashAttention 的内部累加默认在 FP32 下完成,这是必要的——如果自定义注意力实现,务必确保 softmax 的分子和分母累加在 FP32 下。
- 所有大语言模型训练:GPT-4、Claude、LLaMA 等全部使用 BF16 混合精度 + 分布式训练。详见语言模型演进。
- CNN 图像分类:ResNet 等用 FP16 AMP 加速训练,速度提升约 2 倍。详见CNN 卷积神经网络。
- 扩散模型训练:Stable Diffusion 等高分辨率生成模型用混合精度节省显存。详见扩散模型。
- 大模型推理:LLaMA、ChatGLM 等推理时普遍用 FP16/BF16,部分场景进一步量化为 INT8/INT4。详见大模型推理。
- 模型压缩与量化:INT8/INT4 量化是混合精度在推理端的延伸。详见模型压缩与加速。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| torch.cuda.amp | Python | PyTorch 原生 AMP 模块:autocast(自动精度转换)+ GradScaler(损失缩放) |
| torch.bfloat16 | Python | PyTorch BF16 数据类型,A100/H100 原生支持 |
| apex.amp | Python | NVIDIA 早期 AMP 库(已被 PyTorch 原生 AMP 取代) |
| deepspeed | Python | 内置混合精度支持,与 ZeRO 优化无缝配合 |
| accelerate | Python | HuggingFace 训练库,自动选择最优精度策略 |
| NVIDIA Transformer Engine | Python/C++ | NVIDIA 官方 FP8 训练库,支持 H100 的 FP8 硬件加速 |
| torch.float8_experimental | Python | PyTorch 社区 FP8 实验性支持模块 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 混合精度训练 | Mixed Precision Training | 训练中同时使用半精度(FP16/BF16)和单精度(FP32),兼顾速度和精度 |
| FP32 | Single Precision | 32 位浮点数,传统训练的默认精度,精度高但显存占用大 |
| FP16 | Half Precision | 16 位浮点数,速度快显存省,但范围小、小梯度易下溢 |
| BF16 | Brain Float 16 | 16 位浮点,指数位与 FP32 相同,范围大、训练更稳定 |
| FP8 | FP8 | 8 位浮点,H100/B200 GPU 支持,极致压缩用于推理加速 |
| 自动混合精度 | AMP (Automatic Mixed Precision) | 框架自动管理精度转换,前向用半精度、主权重保持 FP32 |
| 损失缩放 | Loss Scaling | 放大损失使小梯度在 FP16 中不致下溢,更新前再缩回 |
| 主权重 | Master Weights | 始终以 FP32 存储的模型参数,保证累加更新精度 |
| 下溢 | Underflow | 数值过小超出浮点数可表示范围,变为零 |
| 溢出 | Overflow | 数值过大超出浮点数可表示范围,变为无穷大 |
| 隐含前导 1 | Implied Leading 1 | IEEE 754 规范中,正规数的尾数整数部分默认为 1,不占存储位 |
| 机器 epsilon | Machine Epsilon | 1.0 与下一个可表示浮点数之差,衡量浮点格式的相对精度 |
| 动态损失缩放 | Dynamic Loss Scaling | 自动调整缩放因子,溢出时减小、稳定后增大的自适应策略 |
| Tensor Core | Tensor Core | NVIDIA GPU 中专门执行低精度矩阵乘法的硬件单元,支持 FP16/BF16/FP8 |
| 延迟缩放 | Delayed Scaling | FP8 训练中基于历史 amax 计算缩放因子的策略 |
| 块缩放 | Block Scaling | 每 N 个元素共享一个缩放因子的方案,用于 MX 格式 |
| 激活值 | Activation | 前向传播中各层的中间输出,反向传播时需用于计算梯度 |
| 激活检查点 | Activation Checkpointing | 只保存部分层激活值、反向时重新计算的显存优化技术 |
最新进展(2025-2026)
Section titled “最新进展(2025-2026)”FP8 训练走向成熟
Section titled “FP8 训练走向成熟”FP8 已从实验阶段正式进入大规模生产环境。2024-2025 年的标志性进展:
- Meta Llama 3 使用 FP8 训练:Meta 在 Llama 3 系列(405B 参数)的训练中大规模采用 FP8,证明了 FP8 在千亿参数规模上的可行性。训练中使用了混合 FP8 策略(前向 E4M3 + 反向 E5M2),并与 FSDP 和 Tensor Parallelism 协同工作。
- 混合 FP8 策略成为标准:前向传播用 E4M3(精度优先),反向传播用 E5M2(范围优先),兼顾精度与稳定性。这一策略被 NVIDIA Transformer Engine、MS-AMP、DeepSpeed 等主流框架广泛采纳。
- 自动缩放技术成熟:
DelayedScaling和MXFP8策略已能自动管理 per-tensor 或 per-block 缩放因子,开发者无需手动调参。 - 加速效果显著:H100 上 FP8 相比 BF16 约有 1.5-2 倍加速,B200 上 FP8 甚至可达到 BF16 的 3 倍吞吐。B200 的第二代 Transformer Engine(Transformer Engine,NVIDIA GPU 中专门加速 Transformer 计算的软硬件栈)进一步优化了 FP8 路径。
- 多家厂商验证:除了 Meta,Microsoft、Amazon 等也在各自的训练框架中报告 FP8 训练在数千亿参数规模上与 BF16 精度一致。
FP4 与 MX(Microscaling)格式
Section titled “FP4 与 MX(Microscaling)格式”2024-2026 年,FP4(4 位浮点)成为超低精度的前沿方向:
- OCP MX 格式规范(OCP,Open Compute Project,开放计算项目,由 Meta 等主导的开放硬件标准组织):定义了”块缩放”(block scaling)方案——每 32 个元素共享一个 8 位指数缩放因子,大幅扩展了低精度格式的有效动态范围。MX 格式包含 FP8、FP6 和 FP4 变体。
MXFP4 的块缩放原理:每 32 个 FP4 值共享一个 E8M0(8 位纯指数)缩放因子实际值 = FP4_value × scale_factor→ 有效动态范围 ≈ 2^(-127) 到 2^(127),与 FP32 相当→ 单元素精度低(4 位),但 32 元素的平均值精度可接受
- NVIDIA Blackwell B200(2024 年发布)支持原生 FP4 Tensor Core 算术,推理吞吐量相比 FP8 再提升数倍。B200 的 FP4 Tensor Core 理论算力达到约 9 PFLOPS(稠密)。
- FP4 训练仍处研究阶段:目前 FP4 主要用于推理(量化后部署),FP4 训练面临精度挑战。但 Microsoft 等已展示在特定条件下(如使用随机舍入、块缩放和梯度补偿技术)FP4 训练的可行性。
- 随机舍进(Stochastic Rounding)成为主流:传统舍入(四舍五入或截断)在超低精度下会引入系统性偏差。随机舍入让每个值的舍入方向按概率决定,使得多次运算的平均值无偏——这对 FP4/FP8 训练至关重要。
PyTorch 精度支持的演进(2025-2026)
Section titled “PyTorch 精度支持的演进(2025-2026)”- PyTorch 2.5+ 的 FP8 支持进入稳定阶段:
torch.float8_e4m3fn和torch.float8_e5m2数据类型已从实验阶段转为稳定 API,torch.float8_e4m3fnuz(无无限值变体)也已加入。 torch.compile与 AMP 深度集成:编译后的模型可以更高效地处理精度转换——编译器自动融合 cast 操作和相邻的数学算子,减少 kernel launch 开销和中间 tensor 的显存分配。实测在 Transformer 模型上可获得额外 10-20% 的加速。- FP16 在 CPU 路径上的支持:PyTorch 2.5+ 改进了 CPU 上的 FP16 计算路径,使得不支持 BF16 的 CPU 也能进行混合精度推理。
- cuDNN SDPA 后端:Scaled Dot Product Attention(SDPA,缩放点积注意力,Transformer 中的核心计算)的 cuDNN 后端在 H100 上实现了 75% 的加速,内部自动管理 FP16/BF16 和 FP32 的精度切换。
- 社区推进 MX 格式原生支持:PyTorch 社区正在推进
torch.mx模块,预计将在 PyTorch 2.6+ 逐步可用,届时可以在 Python 层面直接使用块缩放的低精度格式。
DeepSpeed 低精度创新(2025)
Section titled “DeepSpeed 低精度创新(2025)”DeepSpeed 在低精度训练方面持续创新:
- 低精度主权重(Low-Precision Master States, 2025/12):DeepSpeed Core API 引入了用 FP16/BF16 存储主权重的选项,进一步减少优化器状态的显存占用。关键创新是使用随机舍入来补偿低精度存储引入的偏差——每次更新时,低位截断按概率向上或向下舍入,使得多次更新的期望值等于 FP32 精度的结果。
传统方案: 主权重 FP32(4 bytes/param)低精度方案: 主权重 BF16(2 bytes/param)+ 随机舍入→ 7B 模型节省 14 GB 显存→ 精度损失可忽略(随机舍入保证无偏)
超低精度训练的前沿研究
Section titled “超低精度训练的前沿研究”- FP4 训练可行性研究:Microsoft Research 等机构展示了在 GPT-2 规模模型上进行 FP4 训练的初步结果。关键技术包括:(1) 块缩放(每 32 元素共享一个 scale factor);(2) 随机舍入消除偏差;(3) 梯度和主权重的差异化精度(梯度 FP4,主权重 FP8)。
- INT8 训练探索:虽然推理端 INT8 量化已非常成熟,但训练端的 INT8 仍面临挑战(特别是反向传播中梯度的动态范围)。一些研究通过 per-channel 量化来缓解。
- 精度感知的自动调优:一些框架(如 MASE、Prectrain)开始探索自动搜索每层最优精度组合的方案——不同层对精度的敏感度不同,混合精度方案可以为每层自动选择 FP8/FP16/BF16。
- Micikevicius et al.,「Mixed Precision Training」(ICLR 2018):NVIDIA 的混合精度训练开创性论文,提出 FP16 + 损失缩放 + FP32 主权重的三件套方案。https://arxiv.org/abs/1710.03740
- Kalamkar et al.,「A Study of BFLOAT16 for Deep Learning During Training and Inference」(ICCAD 2019):Google 的 BF16 深度学习应用论文,系统对比 BF16 与 FP16 的训练稳定性。https://arxiv.org/abs/1905.12322
- Micikevicius et al.,「FP8 Formats for Deep Learning」(2022):NVIDIA/Intel/AMD 联合的 FP8 格式白皮书,定义了 E4M3 和 E5M2 两种 FP8 格式。https://arxiv.org/abs/2209.05433
- NVIDIA,「Hopper Architecture Whitepaper」(2022):H100 GPU 架构白皮书,详细描述 FP8 Tensor Core 的设计。https://resources.nvidia.com/en-us-hopper-architecture
- NVIDIA,「Blackwell Architecture Whitepaper」(2024):B200/B100 GPU 架构白皮书,引入第二代 Transformer Engine 和原生 FP4 Tensor Core 支持。
- OCP Microscaling Formats (MX) Specification, v1.0 (2023):开放计算项目(OCP)提出的 MX 格式规范,定义了 FP8/FP6/FP4 的块缩放格式。https://www.opencompute.org/documents/ocp-microscaling-formats-mx-v1-0-specification-pdf-markdown-pdf-1
- Sun et al.,「Ultra-Low Precision Low-Rank Tensor Decomposition for CNNs」(2025):超低精度训练的前沿研究,探索 FP4 训练的可行性。
- DeepSpeed Team,「DeepSpeed Core API: Low-Precision Master States」(2025/12):DeepSpeed 低精度主权重技术,通过随机舍入在 BF16 下存储主权重。https://github.com/deepspeedai/DeepSpeed
- PyTorch 官方文档,「Automatic Mixed Precision Tutorial」:AMP 官方教程,涵盖 autocast 和 GradScaler 的完整用法。https://pytorch.org/tutorials/recipes/recipes/amp_recipe.html
- PyTorch 官方文档,「CUDA Automatic Mixed Precision Example」:https://pytorch.org/docs/stable/notes/amp_examples.html
- NVIDIA Developer Blog,「Training with Mixed Precision」:NVIDIA 的混合精度实践指南,含各模型的加速基准数据。https://docs.nvidia.com/deeplearning/performance/mixed-precision-training/
- NVIDIA Transformer Engine 文档:https://github.com/NVIDIA/TransformerEngine ,FP8 训练的官方实现和参考。
- MS-AMP (Microsoft Automatic Mixed Precision):Microsoft 的低精度训练库,支持 FP8 和更激进的精度方案。https://github.com/Azure/MS-AMP
- Peng et al.,「FP8-LM: Training FP8 Large Language Models」(2025):系统性研究 FP8 在大语言模型训练中的应用,涵盖前向、反向、梯度和主权重各环节的精度选择。
- 相关章节:梯度下降与优化器、分布式训练、DeepSpeed 与 FSDP、大模型推理、模型压缩与加速、Transformer、语言模型演进。